+1 Daha

BİLGE'ye Dair Temel Bilgiler (Yapay Zekâ ile Oluşturulmuştur)
BİLGE (Dil Modeli)
Adı | BİLGE | ||||||||
|---|---|---|---|---|---|---|---|---|---|
Türü | Büyük Dil Modeli | ||||||||
Geliştirici | TÜBİTAK BİLGEM | ||||||||
İş Birliği Yapılan Kurumlar | Sanayi ve Teknoloji Bakanlığı Türkiye Teknoloji Takımı Vakfı (T3 Vakfı) | ||||||||
Odak Alanı | Türkçe ve doğal dil işleme | ||||||||
Model Yapısı | Farklı parametre ölçeklerine sahip model ailesi | ||||||||
Temel Amaç | Türkçeyi ve Türkiye'nin kültürel bağlamını yapay zekâ sistemlerinde daha etkin temsil etmek | ||||||||
Kullanım Alanları | Kamu Eğitim Finans Sağlık Telekomünikasyon Bilgi teknolojileri | ||||||||
BİLGE (Dil Modeli), Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK) Bilişim ve Bilgi Güvenliği İleri Teknolojiler Araştırma Merkezi (BİLGEM) tarafından geliştirilen; Türkçenin sondan eklemeli biçimbilimsel (morfolojik) yapısını, anlamsal katmanlarını ve yerel kültürel birikimini merkeze alarak yüksek kaynak verimliliği ve veri egemenliği sağlamak amacıyla tasarlanmış, çok ölçekli yerli ve millî büyük dil modeli (LLM) ailesidir.
BİLGE, küresel yapay zekâ sistemlerindeki algoritmik temsil kısıtlarını aşmayı ve Türkçeyi birincil dil olarak işleyip akıl yürütebilen yetkin bir model altyapısı sunmayı amaçlayan ulusal yapay zekâ ekosisteminin temel bileşenidir. TÜBİTAK bünyesinde 2024 yılında "Türkçe Büyük Temel Dil Modeli Projesi" adıyla başlatılan Ar-Ge çalışmaları, 2026 yılında farklı parametre büyüklüklerine sahip "BİLGE" model ailesinin kamuoyuna tanıtılması ve geliştiricilerin erişimine açılması süreciyle genişletilmiştir.
Türkçe Büyük Dil Modeli Projesi Tanıtım Videosu (TÜBİTAK Bilim Genç)
BİLGE’nin geliştirilme süreci, Türkiye’nin yapay zekâ alanında dışa bağımlılığını azaltma, kritik verilerin ulusal sınırlar içerisinde işlenmesini sağlama ve eklemeli bir dil olan Türkçenin küresel tokenizasyon algoritmalarında karşılaştığı hesaplama maliyetlerini düşürme ihtiyacından doğmuştur.
Küresel büyük dil modellerinin veri havuzlarında Türkçenin düşük temsil oranına sahip olması; kavramsal kaymalara, kültürel ön yargılara ve yüksek belirteç (token) maliyetlerine yol açmaktadır. BİLGE, ulusal verilerin yurt dışı sunucularına aktarılmadan işlenebilmesini (veri egemenliği), kamu mevzuatına ve Türkçenin biçim bilimsel (morfolojik) kurallarına doğrudan uyum sağlayan optimize bir model ailesinin oluşturulmasını hedeflemiştir.
TÜBİTAK'ın 2024-2028 Stratejik Planı doğrultusunda, Türkçenin zenginlik ve çeşitliliğinin yapay zekâ sistemlerine aktarılmasını amaçlayan “Türkçe Büyük Temel Dil Modeli Projesi”, Ekim 2024’te TÜBİTAK BİLGEM bünyesinde kurum içi Ar-Ge desteğiyle başlatılmıştır. Bu aşamada açık kaynaklı internet verileri ile kamu kurumlarından derlenen nitelikli veri setlerinin temizlenmesi ve etiketlenmesi yürütülmüştür.
2025 yılı boyunca TÜBİTAK BİLGEM, Sanayi ve Teknoloji Bakanlığı ve Türkiye Teknoloji Takımı Vakfı (T3 Vakfı) iş birliğinde insan kaynağı yetiştirme çalışmaları hızlandırılmış; TEKNOFEST bünyesinde Eylem Temelli Türkçe Büyük Dil Modeli Yarışması düzenlenerek akademik ve teknik ekosistem projeye entegre edilmiştir.
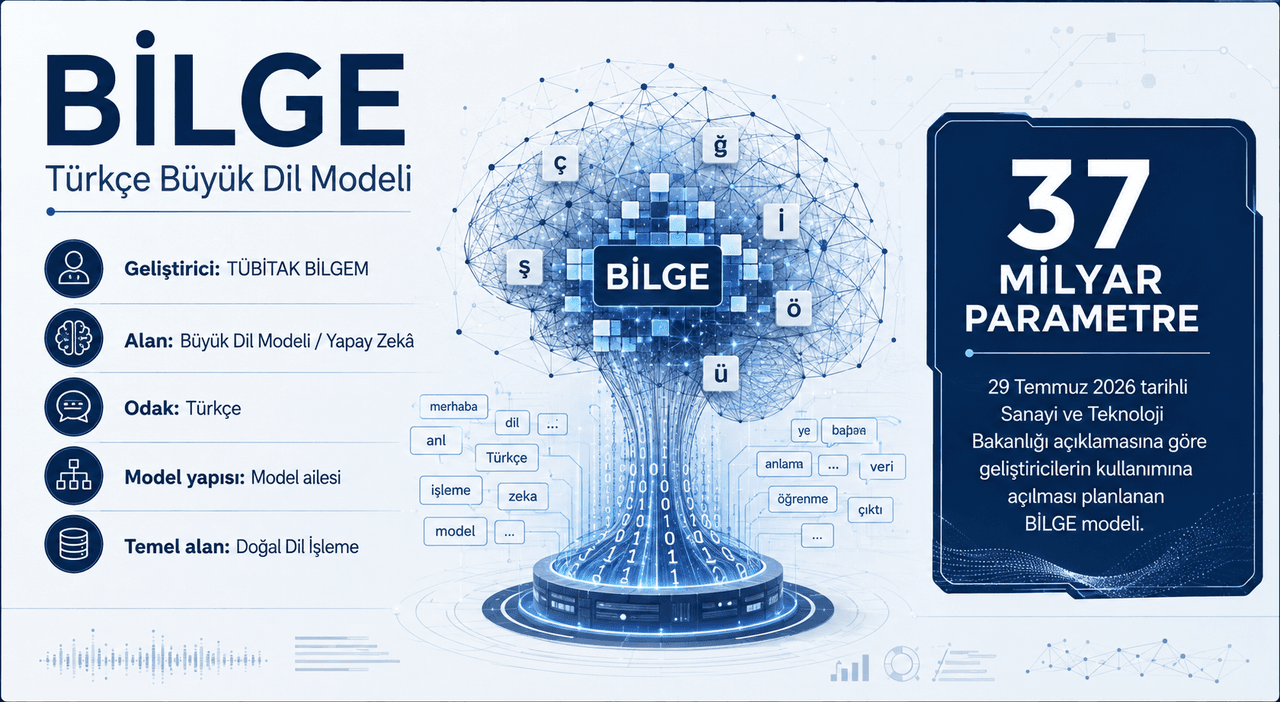
2026 yılında model ailesi resmen "BİLGE" adı ile kamuoyuna tanıtılmış; 1 milyardan 122 milyar parametreye kadar uzanan mimari tasarım duyurulmuştur. 29 Temmuz 2026 tarihinde Sanayi ve Teknoloji Bakanlığı tarafından yapılan açıklamayla, 37 milyar parametreli BİLGE sürümünün geliştiricilerin ve girişim ekosisteminin kullanımına sunulacağı ilan edilmiştir.【1】
Türkiye'de Türkçe doğal dil işleme ve büyük dil modeli geliştirme çalışmaları, yapay zekâ alanında yerli araştırma ve geliştirme kapasitesinin artırılmasına yönelik faaliyetler kapsamında yürütülmektedir. TÜBİTAK'ın 2024-2028 Stratejik Planı'nda Türkçenin zenginlik ve çeşitliliğinin yapay zekâ sistemlerine aktarılmasını amaçlayan “Türkçe Büyük Dil Modeli Projesi" başlatılmıştır.
TÜBİTAK'ın 2024 yılı Faaliyet Raporu'nda Türkçe Büyük Temel Dil Modeli Projesi'nin Ekim 2024'te kurum içi destekle başlatıldığı ve Türkçeye özgü, anlama ve üretme yetenekleri yüksek dil modellerinin geliştirilmesinin hedeflendiği belirtilmiştir. Raporda ayrıca internete açık kaynakların yanında kamu kurumlarından sağlanan verilerin toplanması ve işlenmesi yoluyla Türkçe yapay zekâ modellerinin geliştirilmesinin amaçlandığı ifade edilmiştir.【2】
Projenin teknik ve kurumsal altyapısı yalnızca dil modelinden oluşmamaktadır. Büyük dil modellerinin geliştirilmesi; veri kaynaklarının oluşturulması ve işlenmesi, yüksek işlem gücünün sağlanması, model eğitimi, değerlendirme, yazılım geliştirme ve bu alanlarda çalışabilecek insan kaynağının yetiştirilmesi gibi birbirini tamamlayan süreçleri kapsamaktadır.
TÜBİTAK'ın 2025 yılı Faaliyet Raporu'nda da Türkçe büyük dil modeli ekosisteminin geliştirilmesine yönelik faaliyetlerin sürdürüldüğü saptanmıştır. Raporda, TÜBİTAK, Türkiye Teknoloji Takımı Vakfı ve Sanayi ve Teknoloji Bakanlığı yürütücülüğünde Eylem Temelli Türkçe Büyük Dil Modeli Yarışması düzenlendiği ve yarışmanın Türkçe büyük dil modeli alanında yetkin insan kaynağının yetiştirilmesi ile yenilikçi çözümlerin teşvik edilmesi amaçlarıyla gerçekleştirildiği belirtilmiştir.【3】
BİLGE, tek bir modelden ziyade farklı ölçeklerde geliştirilen büyük dil modellerini içeren bir model ailesi olarak tanımlanmaktadır. BİLGE'nin resmî internet sitesinde model ailesinin TÜBİTAK BİLGEM tarafından geliştirildiği ve Türkçenin kendine özgü yapısı ile kültürel birikiminin model geliştirme sürecinde dikkate alındığı belirtilmektedir. Aynı kaynakta, BİLGE model ailesinin 1 milyardan 122 milyara kadar farklı parametre ölçeklerinde modeller içerdiği ifade edilmektedir.
BİLGE model ailesinde farklı kullanım ihtiyaçlarına yönelik çeşitli model ölçekleri bulunmaktadır. Projenin resmî sitesinde 9 milyar parametreli modelin Türkçeye özgü bir tokenizer altyapısıyla geliştirildiği ve performans ile kaynak kullanımı arasında denge sağlamasının amaçlandığı belirtilmektedir. Aynı sitede 27 milyar parametreli modelin açık kaynaklı modeller üzerine Türkçe verilerle sürekli ön eğitim uygulanarak geliştirildiği, 122 milyar parametreli modelin ise geliştirme aşamasında olduğu bilgisi yer almaktadır.【4】
Bunun yanında Sanayi ve Teknoloji Bakanlığı tarafından 29 Temmuz 2026 tarihinde yapılan açıklamada, TÜBİTAK tarafından 37 milyar parametreyle geliştirilen BİLGE Dil Modeli'nin yakın zamanda geliştiricilerin kullanımına açılacağı bildirilmiştir.【5】Böylece kamuya açıklanan bilgiler, BİLGE'nin farklı model ölçekleri üzerinden geliştirilen ve kullanım alanları genişletilmesi planlanan bir model ailesi olduğunu göstermektedir.
Büyük dil modelleri, insan dilini işlemek ve üretmek amacıyla büyük miktarda metinsel veriden öğrenen yapay zekâ sistemleridir. Bu modeller doğal dildeki örüntüleri öğrenerek metin oluşturma, soru yanıtlama, özetleme, çeviri ve benzeri dil işleme görevlerinde kullanılabilir. TÜBİTAK Bilim Genç tarafından yayımlanan Türkçe Büyük Dil Modeli Projesi içeriğinde de büyük dil modelleri, insan dilini anlama, işleme ve üretme amacıyla geliştirilen yapay zekâ sistemleri olarak açıklanmaktadır.
Türkçeye yönelik bir büyük dil modeli geliştirilirken dilin yapısal özelliklerinin dikkate alınması önem taşımaktadır. Türkçe, sondan eklemeli bir dil olduğundan sözcüklerin kök ve ekler aracılığıyla farklı biçimlere dönüşmesi, doğal dil işleme sistemleri açısından kendine özgü veri işleme ihtiyaçları ortaya çıkarmaktadır.
BİLGE'nin resmî internet sitesinde model ailesinin Türkçenin dil yapısı, anlam katmanları ve kültürel bağlamına odaklandığı belirtilmektedir. Sitede ayrıca BİLGE'nin Türkçe içerik üretme, metinleri özetleme, soruları yanıtlama ve Türkçe-İngilizce çeviri gibi doğal dil işleme görevlerinde kullanılabileceği ifade edilmektedir. Bu yaklaşım, yalnızca bir yapay zekâ modelinin Türkçe metin üretebilmesinden farklı olarak Türkçenin dil bilgisel özelliklerinin ve Türkiye'ye özgü kültürel referansların, modelin geliştirilmesi ve değerlendirilmesinde dikkate alınmasını amaçlamaktadır.
Büyük dil modellerinin geliştirilmesinde veri ve hesaplama altyapısı temel unsurlar arasında yer almaktadır. Modelin öğrenme sürecinde kullanılan verilerin niteliği, kapsamı ve işlenme yöntemleri, modelin dil yeteneklerini etkileyen faktörler arasında bulunmaktadır.
TÜBİTAK'ın 2024 yılı Faaliyet Raporu'nda Türkçe Büyük Temel Dil Modeli Projesi kapsamında internete açık kaynakların yanı sıra kamu kurumlarından sağlanan verilerin toplanması ve işlenmesinin planlandığı belirtilmiştir. Bu yaklaşım, Türkçe yapay zekâ modellerinin geliştirilmesinde veri kaynaklarının oluşturulması ve düzenlenmesini, projenin temel bileşenlerinden biri hâline getirmektedir.
Model eğitiminde ihtiyaç duyulan yüksek işlem gücü de büyük dil modeli çalışmalarının önemli bir bileşenidir. TÜBİTAK'ın 2024-2028 Stratejik Planı'nda yapay zekâ ve benzeri yüksek hesaplama gerektiren araştırmalar için TRUBA Veri Merkezi ve ARF Hesaplama Kümesi gibi altyapıların, araştırmacıların, kamu kurumlarının ve özel sektörün kullanımına sunulduğu belirtilmiştir.【6】Bu altyapılar, büyük miktarda verinin işlenmesi ve yüksek hesaplama gücü gerektiren yapay zekâ modellerinin eğitilmesi açısından önem taşımaktadır. Böylece büyük dil modeli geliştirme süreci yalnızca algoritma ve yazılım çalışmalarına değil, veri yönetimi ve yüksek başarılı hesaplama altyapılarına da dayanmaktadır.
BİLGE'nin resmî internet sitesinde model ailesinin kamu hizmetleri, finans ve bankacılık, sağlık, telekomünikasyon, eğitim ve bilgi teknolojileri gibi farklı alanlarda kullanılabilecek uygulamalara temel oluşturabileceği belirtilmektedir.
Kamu alanında büyük dil modelleri; vatandaş hizmetlerinin dijitalleştirilmesi, başvuru süreçlerinin desteklenmesi, belge ve metinlerin işlenmesi ve mevzuata dayalı bilgi sistemlerinin geliştirilmesi gibi görevlerde kullanılabilir. Bu tür uygulamalarda modelin ürettiği bilgilerin doğruluğu, güncelliği, güvenliği ve insan denetimine açık olması önem taşımaktadır.
Eğitim alanında Türkçe içerik üretimi, metinlerin özetlenmesi ve doğal dil işleme araştırmaları gibi kullanım alanları bulunabilir. Sağlık alanında ise tıbbi belgelerin özetlenmesi ve bilgi erişiminin desteklenmesi gibi uygulamalar geliştirilebilir. Ancak bu tür alanlarda yapay zekâ çıktılarının uzman değerlendirmesinin yerine geçmemesi ve ilgili alana özgü güvenlik ve mevzuat şartlarına uygun biçimde kullanılması gerekmektedir.
Millî Teknoloji Hamlesi, Türkiye'nin kritik ve stratejik teknolojilerde araştırma, geliştirme ve üretim kapasitesini artırmaya yönelik teknoloji politikalarının temel çerçevelerinden biridir. Yapay zekâ, büyük veri ve yüksek başarımlı hesaplama altyapıları bu çerçevede stratejik teknoloji alanları arasında değerlendirilmektedir.
TÜBİTAK'ın 2024-2028 Stratejik Planı'nda Türkçe Büyük Dil Modeli projesinin başlatılması, yapay zekâ alanında yerli ve özgün kapasitenin geliştirilmesine yönelik çalışmalar arasında gösterilmektedir.
Sanayi ve Teknoloji Bakanlığının 29 Temmuz 2026 tarihli açıklamasında da BİLGE'nin Türkçenin zenginliğini ve Türkiye'nin toplumsal birikimini yapay zekâ modellerinde yansıtması, teknolojik bağımsızlık bağlamında ele alınmıştır. Aynı açıklamada yapay zekâ ekosisteminin nitelikli insan kaynağı, güçlü dijital altyapı, kurumsal koordinasyon ve finansman unsurlarıyla birlikte geliştirilmesinin hedeflendiği belirtilmiştir. Bu yönüyle BİLGE, yalnızca doğal dil işleme alanında geliştirilen bir yazılım modeli olarak değil; Türkçe veri, yapay zekâ araştırmaları, yüksek başarılı hesaplama, insan kaynağı ve dijital altyapının bir araya geldiği daha geniş bir teknoloji ekosisteminin parçası olarak değerlendirilmektedir.
Büyük dil modellerinin geliştirilmesi, yalnızca yapay zekâ uygulamalarının kullanımını değil, veri ve teknoloji üzerindeki kontrolü de gündeme getirmektedir. Model geliştirme süreçlerinde kullanılan verilerin nerede işlendiği, hangi altyapılarda saklandığı ve bu verilere kimlerin erişebildiği dijital egemenlik açısından önem taşımaktadır.
BİLGE'nin resmî internet sitesinde model ailesinin ulusal verilerin ülke içinde işlenmesi ve depolanmasına katkı sağlayarak dışa bağımlılığın azaltılması ve veri güvenliğinin desteklenmesi amacıyla konumlandırıldığı belirtilmektedir.
TÜBİTAK'ın Türkçe Büyük Dil Modeli Projesi'ne ilişkin stratejik belgelerinde de Türkçenin yapay zekâ sistemlerinde temsil edilmesi ve yerli yapay zekâ modellerinin geliştirilmesi hedeflenmektedir. Bu nedenle BİLGE, Türkiye'deki yapay zekâ çalışmalarının yanı sıra veri güvenliği, hesaplama altyapısı ve teknolojik yetkinlik başlıklarıyla da ilişkilendirilmektedir.
BİLGE'nin geliştiriciler tarafından kullanılabilmesi, model ailesinin araştırma ve uygulama ekosistemine yaygınlaştırılması açısından önemli bir aşamadır. Sanayi ve Teknoloji Bakanlığı 29 Temmuz 2026 tarihli açıklamasında, 37 milyar parametreli BİLGE'nin yakın zamanda geliştiricilerin kullanımına açılacağını duyurmuştur.
BİLGE'nin resmî internet sitesinde ise model ailesinin henüz genel kullanıma açılmadığı ve erişim süreçlerine ilişkin gelişmelerin resmî kanallardan duyurulacağı belirtilmektedir. Bu nedenle BİLGE'ye erişim, kullanım koşulları, lisanslama, teknik arayüzler ve model sürümlerine ilişkin güncel bilgilerin yalnızca TÜBİTAK BİLGEM ile Sanayi ve Teknoloji Bakanlığının resmî açıklamaları üzerinden takip edilmesi gerekmektedir.
Büyük dil modeli geliştirme süreci; yapay zekâ, bilgisayar mühendisliği, veri bilimi, doğal dil işleme, yazılım geliştirme ve yüksek başarımlı hesaplama gibi farklı uzmanlık alanlarının birlikte çalışmasını gerektirmektedir. TÜBİTAK'ın Türkçe Büyük Dil Modeli çalışmalarına ilişkin faaliyet raporlarında, Türkçe büyük dil modeli ekosisteminin geliştirilmesi ve bu alanda yetkin insan kaynağının yetiştirilmesine yönelik faaliyetler de yer almıştır. 2025 yılı Faaliyet Raporu'nda düzenlenen Eylem Temelli Türkçe Büyük Dil Modeli Yarışması'nın amaçları arasında Türkçe büyük dil modeli ekosisteminin geliştirilmesi ve yetkin insan kaynağının yetiştirilmesi gösterilmiştir. Bu nedenle BİLGE'nin geliştirilmesi, Türkiye'de yapay zekâ alanında araştırma yapabilecek, model geliştirebilecek ve bu modelleri farklı sektörlere uyarlayabilecek insan kaynağının oluşturulmasıyla birlikte değerlendirilmektedir.
Sanayi ve Teknoloji Bakanlığı. “Türkiye’nin Yerli Dil Modeli ‘BİLGE’ Geliştiricilerin Kullanımına Açılıyor.” Erişim tarihi: 31 Ağustos 2026.https://www.sanayi.gov.tr/medya/haber/turkiyenin-yerli-dil-modeli-bilge-gelistiricilerin-kullanimina-aciliyor
TÜBİTAK Bilge. "BİLGE Hakkında.” Erişim tarihi: 31 Ağustos 2026. https://bilge.gov.tr/
TÜBİTAK Bilim Genç. “Türkçe Büyük Dil Modeli Projesi.” Youtube. Erişim tarihi: 31 Ağustos 2026. https://bilimgenc.tubitak.gov.tr/video/turkce-buyuk-dil-modeli-projesi
TÜBİTAK. TÜBİTAK 2024 Yılı Faaliyet Raporu. Ankara: Türkiye Bilimsel ve Teknolojik Araştırma Kurumu, 2025. Erişim tarihi: 31 Ağustos 2026. https://tubitak.gov.tr/tr/kurumsal/hakkimizda/strateji-belgeleri-mali-tablolar
TÜBİTAK. TÜBİTAK 2024-2028 Stratejik Planı. Ankara: Türkiye Bilimsel ve Teknolojik Araştırma Kurumu, 2024. Erişim tarihi: 31 Ağustos 2026. https://tubitak.gov.tr/tr/kurumsal/hakkimizda/strateji-belgeleri-mali-tablolar
TÜBİTAK. TÜBİTAK 2025 Yılı Faaliyet Raporu. Ankara: Türkiye Bilimsel ve Teknolojik Araştırma Kurumu, 2026. Erişim tarihi: 31 Ağustos 2026. https://tubitak.gov.tr/tr/kurumsal/hakkimizda/strateji-belgeleri-mali-tablolar
[1]
Sanayi ve Teknoloji Bakanlığı, “Türkiye’nin Yerli Dil Modeli ‘BİLGE’ Geliştiricilerin Kullanımına Açılıyor,” erişim tarihi: 31 Ağustos 2026,https://www.sanayi.gov.tr/medya/haber/turkiyenin-yerli-dil-modeli-bilge-gelistiricilerin-kullanimina-aciliyor.
[2]
TÜBİTAK, TÜBİTAK 2024 Yılı Faaliyet Raporu, 90. Türkiye Bilimsel ve Teknolojik Araştırma Kurumu, 2025, erişim tarihi: 31 Ağustos 2026, https://tubitak.gov.tr/sites/default/files/2025-03/TUBITAK_2024_Yili_Faaliyet_Raporu.pdf
[3]
TÜBİTAK, TÜBİTAK 2025 Yılı Faaliyet Raporu, 90. Türkiye Bilimsel ve Teknolojik Araştırma Kurumu, 2026, erişim tarihi: 31 Ağustos 2026, https://tubitak.gov.tr/sites/default/files/2026-03/TUBITAK_2025_Yili_Faaliyet_Raporu_0.pdf
[4]
TÜBİTAK Bilge. "BİLGE Hakkında.” erişim tarihi: 31 Ağustos 2026. https://bilge.gov.tr/
[5]
Sanayi ve Teknoloji Bakanlığı, “Türkiye’nin Yerli Dil Modeli ‘BİLGE’ Geliştiricilerin Kullanımına Açılıyor.”
[6]
TÜBİTAK, TÜBİTAK 2024-2028 Stratejik Planı, V. Türkiye Bilimsel ve Teknolojik Araştırma Kurumu, 2024, erişim tarihi: 31 Ağustos 2026, https://tubitak.gov.tr/sites/default/files/2024-10/tubitak_2024-2028_stratejik_plani_1.pdf
BİLGE'ye Dair Temel Bilgiler (Yapay Zekâ ile Oluşturulmuştur)
BİLGE (Dil Modeli)
Adı | BİLGE | ||||||||
|---|---|---|---|---|---|---|---|---|---|
Türü | Büyük Dil Modeli | ||||||||
Geliştirici | TÜBİTAK BİLGEM | ||||||||
İş Birliği Yapılan Kurumlar | Sanayi ve Teknoloji Bakanlığı Türkiye Teknoloji Takımı Vakfı (T3 Vakfı) | ||||||||
Odak Alanı | Türkçe ve doğal dil işleme | ||||||||
Model Yapısı | Farklı parametre ölçeklerine sahip model ailesi | ||||||||
Temel Amaç | Türkçeyi ve Türkiye'nin kültürel bağlamını yapay zekâ sistemlerinde daha etkin temsil etmek | ||||||||
Kullanım Alanları | Kamu Eğitim Finans Sağlık Telekomünikasyon Bilgi teknolojileri | ||||||||
Henüz Tartışma Girilmemiştir
"BİLGE (Dil Modeli)" maddesi için tartışma başlatın
Geliştirme Sebepleri ve Aşamaları
Projenin Başlatılması (2024)
Ekosistem ve İnsan Kaynağı Faaliyetleri (2025)
Kamuoyuna Tanıtım ve Geliştirici Aşaması (2026)
Türkçe Büyük Dil Modeli Projesi
BİLGE Model Ailesi
BİLGE'nin Türkçe Odaklı Yapısı
Veri, Hesaplama Altyapısı ve Model Geliştirme
BİLGE'nin Kullanım Alanları
Millî Teknoloji Hamlesi Bağlamında BİLGE
Dijital Egemenlik ve Veri Güvenliği
Geliştiricilere Açılması
BİLGE'nin Geliştirilmesinde İnsan Kaynağı
Bu madde yapay zeka desteği ile üretilmiştir.
