
“Ahmet geldi.”
“Ahmet gelmiş.”
Aralarında birkaç harf var. Türkçe bilen biri içinse aralarındaki mesafe bundan çok daha büyük.
İlk cümlede konuşan kişi, çoğu bağlamda Ahmet’in gelişini doğrudan bildiğini düşündürür. İkincisinde bilginin arkasında başka bir yol belirir: Birinden duymuş olabiliriz; kapıdaki ayakkabıyı görüp geldiği sonucuna varmış olabiliriz. Türkçe, geçmişten söz ederken kimi zaman bize yalnızca “Ne oldu?” diye sormaz. Cümlenin içine ikinci bir soru daha saklar:
“Bunu nereden biliyorsun?”
Belki “Yapay zekâ Türkçe düşünebilir mi?” sorusuna da tam buradan başlamak gerekir.
Çünkü bugün bir yapay zekâya “Ahmet gelmiş” dedirtmek zor değil. Zor olan başka bir şey: Makine bu eki doğru yere getirirken, onun ardındaki bilgi kaynağı ayrımını da temsil ediyor mu? Yoksa milyarlarca cümle arasında “gelmiş” biçiminin hangi bağlamlarda ortaya çıktığını öğrenmiş kusursuz bir taklitçi mi?
Daha temel soru şu:
Bir dilde konuşmakla, o dilin içinden dünyaya bakmak aynı şey midir?
Bu soru yapay zekâdan çok daha eskidir.
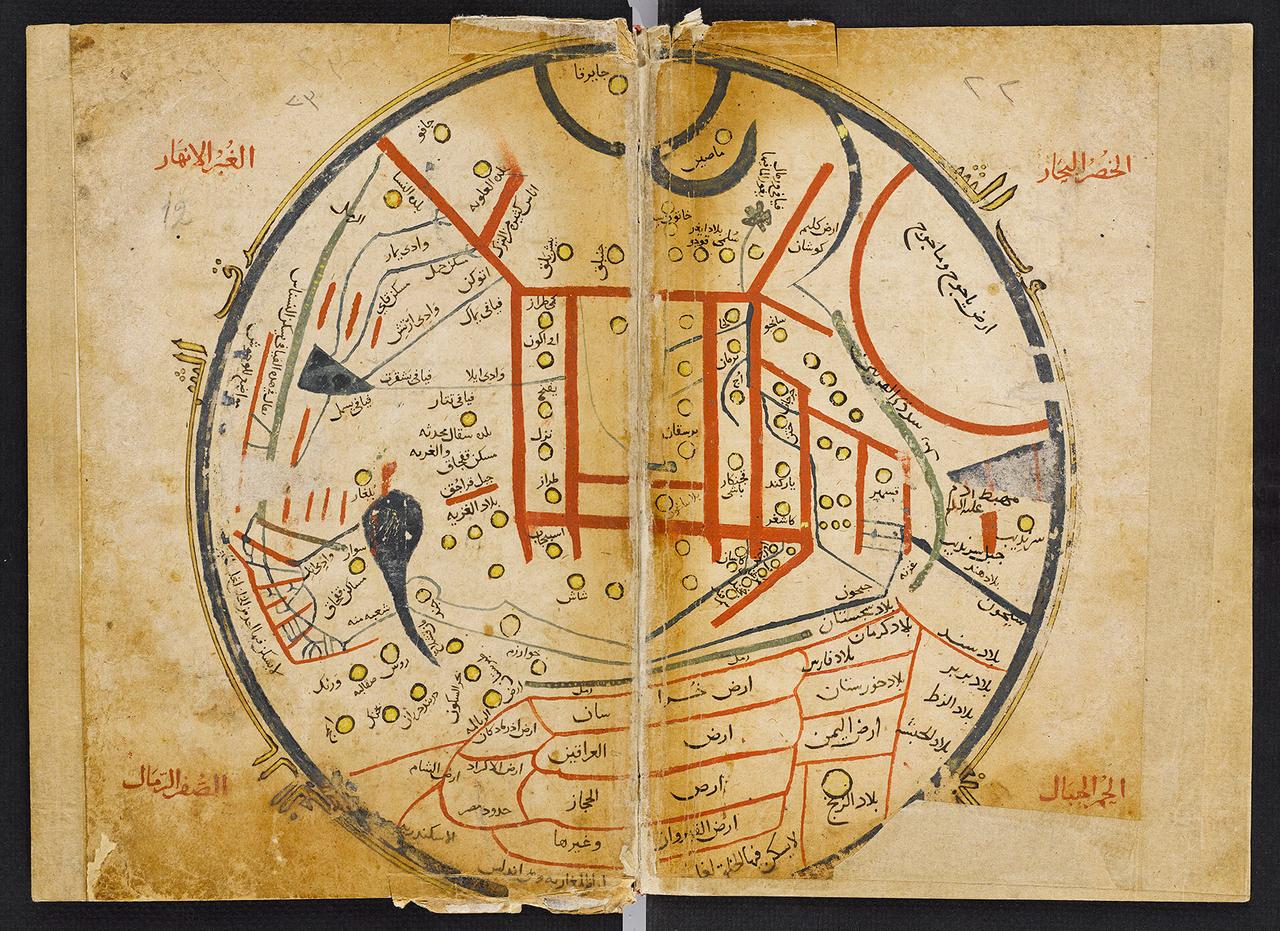
Dîvânu Lugâti’t-Türk (Türkiye Yazma Eserler Kurumu Başkanlığı)
İnsanlar uzun zamandır konuştuğumuz dilin dünyayı algılayışımızı değiştirip değiştirmediğini tartışıyor. Bir zamanlar bu ilişkinin çok güçlü olduğu düşünüldü: Sanki dilimiz zihnimizin sınırlarını çiziyor, sözcüğü bulunmayan düşünceyi düşünmemizi engelliyordu.
Bugün böyle katı bir görüşü savunmak güç.
İnsan zihni dilinin hapishanesinde yaşamaz. Yeni kavramlar öğrenebilir, başka dillerdeki ayrımları kavrayabilir, daha önce adı olmayan şeyler üzerine düşünebilir. Fakat bunun tersi de doğru değildir: Dil, zihinden geçenlerin tamamen tarafsız bir taşıyıcısı değildir.
Daha incelikli bir ihtimal vardır.
Dil bize ne düşünebileceğimizi söylemeyebilir; ama konuşurken neye dikkat edeceğimizi etkileyebilir.
Türkçedeki “geldi / gelmiş” ayrımı bunun güzel örneklerinden biridir. Türkçe geçmişteki olaylardan söz ederken -DI ve -mIş biçimleri aracılığıyla doğrudan ve dolaylı bilgi arasında ayrım yapabilir. İngilizcede aynı bilgi elbette ifade edilebilir; fakat konuşan kişi bunu her defasında fiilin üzerinde işaretlemek zorunda değildir. 【1】
Böyle bir dilsel alışkanlık zihnimizi de değiştirir mi?
Araştırmaların cevabı, basit bir “evet” veya “hayır” değildir. Türkçedeki bilgi kaynağı işaretlemesinin bazı bellek ve kaynak izleme görevleriyle ilişkili olabildiğini gösteren bulgular vardır. Buna karşılık Türkçe ve İngilizce konuşan yetişkinlerin dil dışı kimi kaynak belleği görevlerinde oldukça benzer davrandığı da görülmüştür.【2】
Belki dilin etkisi tam burada saklıdır:
Dünya görüşümüzü baştan sona belirlemez; fakat kimi ayrımları tekrar tekrar gözümüzün önüne getirir.
Peki aynı şeyi bir makine için söyleyebilir miyiz?
Bir insan “Ahmet gelmiş” dediğinde cümlenin arkasında yaşanmış bir dünya vardır.
Bir telefon konuşması, kapıda görülen bir ayakkabı, bir arkadaşın sözü, belki belli belirsiz bir çıkarım...
İnsan dili yalnızca başka cümlelerden öğrenmez. Yağmur kelimesini yağmur altında ıslanarak; sıcaklığı dokunarak; tereddüdü bir insanın yüzünde görerek de öğrenir.
Büyük dil modellerinin dil tecrübesi ise bizimkinden farklıdır.
Makinenin Dilsel Veriyi İşleme Sürecini Temsil Eden Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Onlar çok büyük miktardaki metin içinde hangi dilsel biçimlerin hangi bağlamlarda yan yana geldiğini öğrenir. Bu sistemlerin şaşırtıcı derecede başarılı olması, dil ile anlam arasındaki eski soruyu daha da ilginç hâle getiriyor.
Emily M. Bender ve Alexander Koller’in yaptığı önemli ayrım burada devreye girer: Dilsel biçimi başarıyla kullanmak ile o biçimin dünyadaki anlamına sahip olmak aynı şey değildir.【3】
Fakat bugünün araştırmaları bu tartışmayı daha da tuhaf bir yere taşıyor.
Çünkü artık yalnızca yapay zekânın dışarıda hangi dili konuştuğuna değil, bir cevabı oluştururken içeride neler olduğuna da bakabiliyoruz.
Ve gördüğümüz şey, “Türkçe girer, Türkçe düşünülür, Türkçe çıkar” kadar basit değil.
Çok dilli bir yapay zekâya Türkçe bir soru soralım.
Ekranda Türkçe bir cevap beliriyor.
Peki model bu iki an arasında ne yaptı?
2024'te Llama-2 ailesinin ara katmanlarını inceleyen araştırmacılar ilginç bir örüntü gördüler. İngilizce dışındaki bir dilde verilen girdiler işlenirken modelin orta katmanlarında doğru kavramın İngilizce karşılığı, kimi zaman giriş dilindeki karşılığından daha güçlü biçimde beliriyordu. Araştırmacılar, İngilizcenin eğitim verisinde baskın olduğu bu modellerde soyut “kavram alanının” İngilizceye diğer dillere göre daha yakın olabileceğini öne sürdüler.【4】
Bu bulguyu “Yapay zekâ gizlice İngilizce düşünüyor” diye okumak cazip.
Ama bilim çoğu zaman en güzel cümleyi biraz bozar.
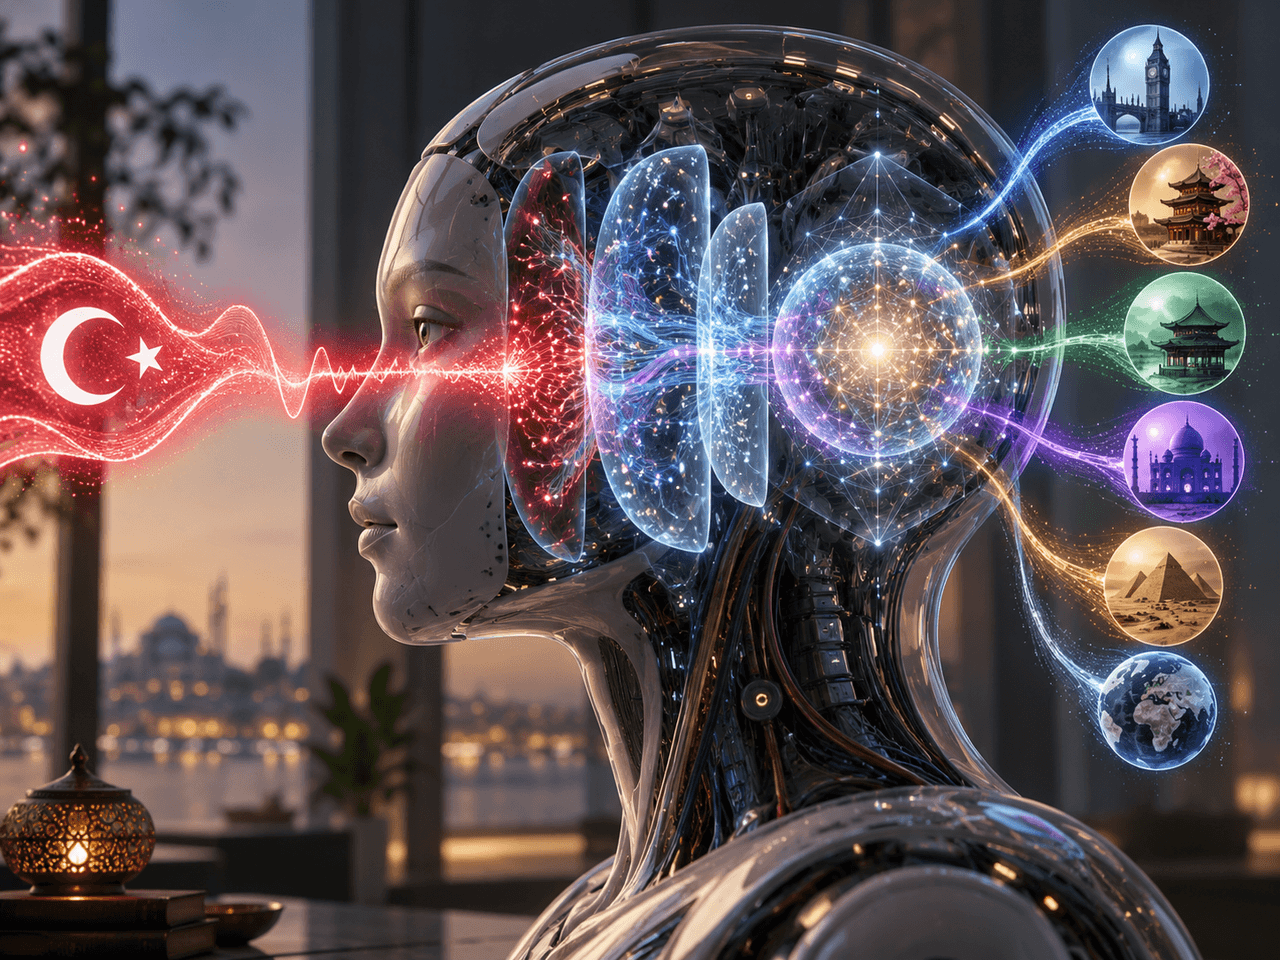
Çok Dilli Yapay Zekâda Kavram Uzayını Temsil Eden Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Sonraki çalışmalar, dil ile kavramın modelin içinde bütünüyle aynı şey olmayabileceğine dair kanıtlar sundu. Araştırmacılar bazı modellerde temsil edilen kavramı değiştirip dili koruyabildi; dili değiştirip kavramı koruyabildi. Farklı dillerdeki aynı kavramın temsilleri arasında, tek bir doğal dile indirgenemeyen ortak bir katman bulunabileceği görüldü. 【5】
Başka modellerde ise tablo yine değişti. İngilizce ağırlıklı eğitilen sistemler iç temsillerinde İngilizceye daha çok yaslanırken, diller arasında daha dengeli eğitilen modeller birden fazla “gizli dili” kullanabiliyordu. Üstelik bu farklılığın kültüre bağlı sorulara verilen cevaplarla da ilişkili olabileceğine dair bulgular elde edildi.【6】
Öyleyse belki makine ne İngilizce ne Türkçe düşünüyor.
Belki kelimelerin altında, bizim doğal dillerimizden hiçbirine tam olarak benzemeyen bir kavram uzayı oluşuyor. Türkçe, İngilizce veya Japonca ise bu uzaya açılan farklı kapılar gibi davranıyor.
Eğer öyleyse asıl sorumuz değişiyor:
Türkçe bu kapılardan yalnızca biri mi, yoksa içerideki kavramların biçimlenmesine de katkıda bulunabiliyor mu?
Bu soru Türkçe için teorik bir meraktan daha fazlasıdır.
Bir yapay zekâ Türkçe cümleleri kusursuz kurabilir; fakat bilgi dünyasının büyük bölümü başka dillerde oluşmuşsa, Türkçe yalnızca son aşamada üzerine geçirilmiş başarılı bir tercüme katmanına dönüşebilir.
Bu ihtimali anlamak için Türkçenin yapısına bakmak yeterlidir.
“Yapabileceğim.”
Yine tek kelime.
Fakat içinde eylem, yeterlilik, gelecek zaman ve kişi bilgisi bulunur. Dil modeli ise bu kelimeyi bizim gördüğümüz gibi tek bir sözcük olarak görmek zorunda değildir. Metni önce “token” adı verilen daha küçük parçalara ayırır.
Bu parçalar rastgele değildir. Eğitim verisinden öğrenilmiş istatistiksel birimlerdir. Model de parçalar arasındaki ilişkileri öğrenebilir. Ancak bir tokenizerın çizdiği sınırlar, insanın “yap + abil + ecek + im” gibi sezebildiği biçimbilimsel yapıyla örtüşmek zorunda değildir. Türkçe üzerine yapılan güncel çalışmalar, bu örtüşmenin ve parçalanma biçiminin model performansını değerlendirirken dikkate alınması gereken etkenlerden biri olduğunu gösteriyor.【7】
Demek ki Türkçe meselesi yalnızca modele daha fazla Türkçe cümle göstermekten ibaret değildir.
Bir dilin bilgisayarda nasıl parçalandığı, hangi metinlerle temsil edildiği ve ne tür sorularla sınandığı da önemlidir.
Ve asıl sorun burada daha görünür hâle gelir.
Bir düşünce deneyi yapalım.
İngilizce hazırlanmış bir milyon soruyu kusursuz biçimde Türkçeye çevirelim.
Artık elimizde bir milyon Türkçe soru vardır.
Peki bir milyon soruluk Türkçe bir dünya da var mıdır?
Sorular Türk edebiyatını bilmiyorsa, Türkiye'nin tarihsel hafızasına dokunmuyorsa, Türkçenin deyimlerini, gündelik çağrışımlarını ve bu dil içinde gelişen tartışmaları taşımıyorsa ortaya çıkan şey Türkçe midir, yoksa İngilizce kurulmuş bir dünyanın Türkçe yüzü müdür?
TurkishMMLU çalışmasının değerli tarafı tam da bu ayrımı ciddiye almasıdır. 10 binden fazla soru doğrudan Türkiye'deki lise müfredatı dikkate alınarak alan uzmanlarınca hazırlanmış; Türk edebiyatı ve Türkiye Cumhuriyeti tarihi gibi yerel bilgi alanları da değerlendirmeye katılmıştır.【8】
Bu basit bir sınav tekniği değildir.
Arkasında çok daha büyük bir düşünce vardır:
Bir dilin kelimelerini tercüme edebilirsiniz. O dilin hafızasını tercüme ederek yeniden kuramazsınız.
Dilbilimsel Şemaları Temsil Eden Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Nitekim 2025'te yaygın kullanılan 17 Türkçe değerlendirme veri setini inceleyen bir araştırma, kendi kalite ölçütlerine göre bunların yüzde 70'inin gerekli standartları karşılamadığını belirledi.
Araştırmacılar özellikle başka dillerden çevrilmiş ve uyarlanmış veri kümelerinde dilsel ve kültürel uygunluğa dikkat çekti.【9】
Bu bulgu, yapay zekâ çağında çok önemli bir kelimeyi yeniden düşünmemizi gerektiriyor:
Veri.
Bir dil için asıl zenginlik, kaç milyar kelimenin depolandığı olmayabilir.
Asıl zenginlik, hangi hayatların, hangi bilgilerin, hangi düşüncelerin ve hangi kavramların veri hâline getirildiğidir.
Belki burada başlığımızdaki soruya karşı dürüst olmamız gerekiyor.
Bugün bilimsel olarak “Türkçe düşünen yapay zekâ” diye kesin sınırları çizilmiş bir durum yok. Bir modelin Türkçe cevap vermesi yeterli değil.
İç katmanlarında Türkçe kelimelerin görünmesi de tek başına yeterli olmayabilir. Hatta hedefin, hiçbir başka dilden etkilenmemiş “saf Türkçe düşünen” bir makine olması gerektiği bile tartışmalıdır.
İnsan zihni de böyle çalışmaz.
İki dil bilen biri bazen bir kavramı bir dilde daha kolay düşünür, başka bir dilde daha iyi ifade eder. Diller birbirinden kelime, kavram ve çağrışım ödünç alır. Düşüncenin zenginliği çoğu zaman bu geçişlerde artar.
O hâlde daha anlamlı bir hedef belirleyebiliriz:
Türkçenin, yapay zekânın kavram dünyasında ikinci sınıf bir giriş ve çıkış dili olmaması.
Türkçe Düşünen Yapay Zekâyı Temsil Eden Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Türkçe yalnızca sisteme soru sorduğumuz ve cevabı aldığımız arayüz olmamalı. Türkçeyle üretilmiş bilim, tarih, edebiyat, hukuk, eğitim ve gündelik hayat bilgisi de modellerin kurduğu kavramsal dünyanın parçası olabilmeli.
Bunun yolu tek bir “yerli ChatGPT” üretmekten geçmiyor.
Nitelikli Türkçe veri gerekiyor. Türkçenin yapısını dikkate alan dil teknolojileri gerekiyor. Modellerin gerçekten ne kadar Türkçe bildiğini ölçebilecek araçlar gerekiyor. Hesaplama altyapısı, araştırmacılar, dilbilimciler, mühendisler ve sürekli yeni bilgi üretecek kurumlar gerekiyor.
Türkiye'deki Türkçe büyük dil modeli çalışmaları da bu nedenle yalnızca yeni bir ürün geliştirme girişimi olarak okunmamalı. TÜBİTAK BİLGEM bünyesindeki çalışmalar kapsamında yüz milyarlarca Türkçe tokenın eğitimde kullanılması ve Türkçeye yönelik temel model çalışmalarının yürütülmesi, daha geniş bir teknolojik kapasite arayışının parçalarıdır.【10】
Çünkü teknoloji bağımsızlığı yalnızca başkasının ürününün benzerini yapabilmek değildir. Bazen bağımsızlık, başkasının sorduğu soruyla yetinmemektir.
İşte “Türkçe düşünebilir mi?” sorusu burada bir teknoloji politikası meselesine dönüşür.
Türkiye'nin 2030 Sanayi ve Teknoloji Stratejisi, Türkçe Büyük Dil Temel Modeli çalışmalarını yapay zekâ alanındaki dışa bağımlılığı azaltma ve Türkçeye özgü üretken yapay zekâ çözümleri geliştirme hedefiyle ilişkilendiriyor. 2026'da açıklanan Yapay Zekâ Eylem Planı'nda da Türkçe Büyük Dil Modeli çalışmalarının dijital egemenliği güçlendirmek amacıyla sürdürüleceği belirtiliyor.【11】
“Dijital egemenlik” kulağa sunucular, veri merkezleri ve işlemcilerle ilgili bir kavram gibi gelebilir. Oysa dil de onun parçasıdır.
Çünkü gelecekte neyi aradığımızla bulduğumuz bilgi arasına giderek daha fazla yapay zekâ girecek. Öğrenciye tarihi açıklayan, hekimin önündeki metni özetleyen, hukukçunun belge taramasına yardım eden, yazılımcıya kod öneren, araştırmacıya kaynak gösteren sistemler yalnızca bilgiyi taşımayacak; hangi bilginin görünür olacağını da etkileyecek.
Türkçe bu dünyada yalnızca başka dillerde düşünülmüş bilgilerin tercüme edildiği bir son durak hâline gelirse kaybedilen şey birkaç kelime olmayacaktır.
Bir dilin bilgi üretme kudreti zayıflayacaktır.
Milli Teknoloji Hamlesinin dil alanındaki asıl meselesi de belki burada yatıyor: Türkçeyi yalnızca dijital dünyada yaşatmak değil, dijital dünyanın kuruluşuna Türkçeyle katılabilmek.
Başlangıçtaki iki cümleye son kez dönelim.
Ahmet geldi.
Ahmet gelmiş.
Bir insan için aralarındaki fark yalnızca iki geçmiş zaman biçiminden ibaret değildir. Cümlenin arkasındaki bilginin yoluna açılan küçük bir penceredir.
Bugünün yapay zekâsı bu pencerenin hangi cümlede açılması gerektiğini giderek daha iyi öğreniyor. Fakat pencereden bizim gördüğümüz dünyayı görüp görmediğini söylemek için henüz erken. Belki de yapay zekânın “hangi dilde düşündüğünü” sorarken zihnimizde fazla insanca bir görüntü kuruyoruz: Makinenin içinde sessizce Türkçe veya İngilizce konuşan küçük bir ses arıyoruz.
Oysa araştırmalar başka bir ihtimale işaret ediyor. Dilin altında, farklı dillerin kesişebildiği bir kavram alanı bulunabilir. Kimi modeller bu alanda İngilizceye daha fazla yaslanabilir; kimileri birden fazla dilsel temsil arasında hareket edebilir.
Bu nedenle asıl mesele, makinenin içinde Türkçe bir ses duyulup duyulmadığı değildir.
Asıl mesele Türkçenin, makinenin kurduğu kavram dünyasının ne kadar derinine ulaşabildiğidir.
Bir gün “Bu yapay zekâ Türkçe düşünüyor” diyebileceksek bunun ölçüsü yalnızca ekleri doğru getirmesi, deyimleri bilmesi veya bizimle akıcı biçimde konuşması olmayacaktır.
Türkçe; o sistemle bilgi üretmenin, kavram kurmanın, soru sormanın ve dünyayı açıklamanın dillerinden biri olabilmelidir.
Çünkü bir dilin geleceği yalnızca kaç kişinin o dili konuştuğuyla belirlenmez.
Yapay zekâ çağında bir soru daha vardır:
O dil, geleceğin bilgisinin üretildiği yerde bulunacak mı?
“Yapay zekâ Türkçe düşünebilir mi?”
Bugün verebileceğimiz en dürüst cevap:
Henüz bilmiyoruz.
Fakat Türkçenin yalnızca yapay zekânın konuştuğu dillerden biri değil, onunla düşünülen ve bilgi üretilen dillerden biri olması bizim elimizde.
Belki de asıl yarış, makineye Türkçe konuşturmak değil;
Türkçeyi geleceğin düşünce dillerinden biri olarak tutabilmek.
Başar, Ezgi ve Arianna Bisazza. “A Morphology-Aware Evaluation of Turkish Syntax in Large Language Models.” Proceedings of the Second Workshop Natural Language Processing for Turkic Languages (SIGTURK 2026), 95–102. Association for Computational Linguistics, 2026. Erişim 2 Eylül 2026. https://doi.org/10.18653/v1/2026.sigturk-1.9.
Bender, Emily M. ve Alexander Koller. “Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data.” Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, 5185–5198. Association for Computational Linguistics, 2020. Erişim 2 Eylül 2026. https://doi.org/10.18653/v1/2020.acl-main.463.
Dumas, Clément, Chris Wendler, Veniamin Veselovsky, Giovanni Monea ve Robert West. “Separating Tongue from Thought: Activation Patching Reveals Language-Agnostic Concept Representations in Transformers.” Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 31822–31841. Association for Computational Linguistics, 2025. Erişim 2 Eylül 2026. https://doi.org/10.18653/v1/2025.acl-long.1536.
Kandemirci, Birsu, Anna Theakston, Ditte Boeg Thomsen ve Silke Brandt. “Does Evidentiality Support Source Monitoring and False Belief Understanding? A Cross-Linguistic Study with Turkish- and English-Speaking Children.” Child Development 94, sy. 4 (2023): 889–904. Erişim 2 Eylül 2026. https://doi.org/10.1111/cdev.13905.
Samo, Giuseppe ve Paola Merlo. “Modelling the Morphology of Verbal Paradigms: A Case Study in the Tokenization of Turkish and Hebrew.” Proceedings of the Second Workshop Natural Language Processing for Turkic Languages (SIGTURK 2026), 82–94. Association for Computational Linguistics, 2026. Erişim 2 Eylül 2026. https://doi.org/10.18653/v1/2026.sigturk-1.8.
T.C. Cumhurbaşkanlığı İletişim Başkanlığı. “Cumhurbaşkanı Erdoğan Türkiye Yapay Zekâ Eylem Planı’nı Açıkladı.” 13 Haziran 2026. Erişim 2 Eylül 2026.
T.C. Sanayi ve Teknoloji Bakanlığı. 2030 Sanayi ve Teknoloji Stratejisi. 2025. Erişim 2 Eylül 2026. https://www.sanayi.gov.tr/assets/pdf/plan-program/2030SanayiveTeknolojiStratejisi.pdf.
Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK). “TÜBİTAK’la Bilim ve Teknolojide Başarılarla Dolu 2025 Yılı.” 1 Ocak 2026. Erişim 2 Eylül 2026. https://tubitak.gov.tr/tr/haber/tubitakla-bilim-ve-teknolojide-basarilarla-dolu-2025-yili.
Türkiye Yazma Eserler Kurumu Başkanlığı. “Dîvânu Lugâti’t-Türk.” Erişim 2 Eylül 2026. https://www.yek.gov.tr/Home/Index_?n_id=152.
Umutlu, Elif Ecem, Ayse Aysu Cengiz, Ahmet Kaan Sever, Seyma Erdem, Burak Aytan, Busra Tufan, Abdullah Topraksoy, Esra Darıcı ve Cagri Toraman. “Evaluating the Quality of Benchmark Datasets for Low-Resource Languages: A Case Study on Turkish.” Proceedings of the Fourth Workshop on Generation, Evaluation and Metrics (GEM²), 471–487. Association for Computational Linguistics, 2025. Erişim 2 Eylül 2026. https://aclanthology.org/2025.gem-1.41/.
Ünal, Ercenur ve Anna Papafragou. “Relations Between Language and Cognition: Evidentiality and Sources of Knowledge.” Topics in Cognitive Science 12, sy. 1 (2020): 115–135. Erişim 2 Eylül 2026. https://doi.org/10.1111/tops.12355.
Wendler, Chris, Veniamin Veselovsky, Giovanni Monea ve Robert West. “Do Llamas Work in English? On the Latent Language of Multilingual Transformers.” Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 15366–15394. Association for Computational Linguistics, 2024. Erişim 2 Eylül 2026. https://doi.org/10.18653/v1/2024.acl-long.820.
Yüksel, Arda, Abdullatif Köksal, Lütfi Kerem Senel, Anna Korhonen ve Hinrich Schuetze. “TurkishMMLU: Measuring Massive Multitask Language Understanding in Turkish.” Findings of the Association for Computational Linguistics: EMNLP 2024, 7035–7055. Association for Computational Linguistics, 2024. Erişim 2 Eylül 2026. https://doi.org/10.18653/v1/2024.findings-emnlp.413.
Zhong, Chengzhi, Qianying Liu, Fei Cheng, Junfeng Jiang, Zhen Wan, Chenhui Chu, Yugo Murawaki ve Sadao Kurohashi. “What Language Do Non-English-Centric Large Language Models Think in?” Findings of the Association for Computational Linguistics: ACL 2025, 26333–26346. Association for Computational Linguistics, 2025. Erişim 2 Eylül 2026. https://doi.org/10.18653/v1/2025.findings-acl.1350.
[1]
Ercenur Ünal ve Anna Papafragou, “Relations Between Language and Cognition: Evidentiality and Sources of Knowledge,” Topics in Cognitive Science 12, sy. 1 (2020): 115–135, erişim 2 Eylül 2026, https://doi.org/10.1111/tops.12355; Birsu Kandemirci vd., “Does Evidentiality Support Source Monitoring and False Belief Understanding? A Cross-Linguistic Study with Turkish- and English-Speaking Children,” Child Development 94, sy. 4 (2023): 889–904, erişim 2 Eylül 2026, https://doi.org/10.1111/cdev.13905.
[2]
Ünal ve Papafragou, “Relations Between Language and Cognition,” 115–135; Kandemirci vd., “Does Evidentiality Support Source Monitoring,” 889–904.
[3]
Emily M. Bender ve Alexander Koller, “Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data,” Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics (Association for Computational Linguistics, 2020), 5185–5198, erişim 2 Eylül 2026, https://doi.org/10.18653/v1/2020.acl-main.463.
[4]
Chris Wendler, Veniamin Veselovsky, Giovanni Monea ve Robert West, “Do Llamas Work in English? On the Latent Language of Multilingual Transformers,” Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (Association for Computational Linguistics, 2024), 15366–15394, erişim 2 Eylül 2026, https://doi.org/10.18653/v1/2024.acl-long.820.
[5]
Clément Dumas, Chris Wendler, Veniamin Veselovsky, Giovanni Monea ve Robert West, “Separating Tongue from Thought: Activation Patching Reveals Language-Agnostic Concept Representations in Transformers,” Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (Association for Computational Linguistics, 2025), 31822–31841, erişim 2 Eylül 2026, https://doi.org/10.18653/v1/2025.acl-long.1536.
[6]
Chengzhi Zhong vd., “What Language Do Non-English-Centric Large Language Models Think in?,” Findings of the Association for Computational Linguistics: ACL 2025 (Association for Computational Linguistics, 2025), 26333–26346, erişim 2 Eylül 2026, https://doi.org/10.18653/v1/2025.findings-acl.1350.
[7]
Ezgi Başar ve Arianna Bisazza, “A Morphology-Aware Evaluation of Turkish Syntax in Large Language Models,” Proceedings of the Second Workshop Natural Language Processing for Turkic Languages (SIGTURK 2026) (Association for Computational Linguistics, 2026), 95–102, erişim 2 Eylül 2026, https://doi.org/10.18653/v1/2026.sigturk-1.9; Giuseppe Samo ve Paola Merlo, “Modelling the Morphology of Verbal Paradigms: A Case Study in the Tokenization of Turkish and Hebrew,” Proceedings of the Second Workshop Natural Language Processing for Turkic Languages (SIGTURK 2026) (Association for Computational Linguistics, 2026), 82–94, erişim 2 Eylül 2026, https://doi.org/10.18653/v1/2026.sigturk-1.8.
[8]
Arda Yüksel, Abdullatif Köksal, Lütfi Kerem Senel, Anna Korhonen ve Hinrich Schuetze, “TurkishMMLU: Measuring Massive Multitask Language Understanding in Turkish,” Findings of the Association for Computational Linguistics: EMNLP 2024 (Association for Computational Linguistics, 2024), 7035–7055, erişim 2 Eylül 2026, https://doi.org/10.18653/v1/2024.findings-emnlp.413.
[9]
Elif Ecem Umutlu vd., “Evaluating the Quality of Benchmark Datasets for Low-Resource Languages: A Case Study on Turkish,” Proceedings of the Fourth Workshop on Generation, Evaluation and Metrics (GEM²) (Association for Computational Linguistics, 2025), 471–487, erişim 2 Eylül 2026, https://aclanthology.org/2025.gem-1.41/.
[10]
Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK), “TÜBİTAK’la Bilim ve Teknolojide Başarılarla Dolu 2025 Yılı,” 1 Ocak 2026, erişim 2 Eylül 2026, https://tubitak.gov.tr/tr/haber/tubitakla-bilim-ve-teknolojide-basarilarla-dolu-2025-yili.
[11]
T.C. Sanayi ve Teknoloji Bakanlığı, 2030 Sanayi ve Teknoloji Stratejisi (2025), erişim 2 Eylül 2026, https://www.sanayi.gov.tr/assets/pdf/plan-program/2030SanayiveTeknolojiStratejisi.pdf; T.C. Cumhurbaşkanlığı İletişim Başkanlığı, “Cumhurbaşkanı Erdoğan Türkiye Yapay Zekâ Eylem Planı’nı Açıkladı,” 13 Haziran 2026, erişim 2 Eylül 2026, https://www.iletisim.gov.tr/turkce/haberler/detay/cumhurbaskani-erdogan-turkiye-yapay-zeka-eylem-planini-acikladi.
Dil Verisinden Dijital Egemenliğe
Dil Bize Ne Düşüneceğimizi mi Söyler?
Makine “Gelmiş” Dediğinde Ne Biliyor?
Türkçe Soruyoruz; İçeride Hangi Dil Konuşuluyor?
Türkçe Yalnızca Çıkış Dili Olursa
Bir Dilin Dünyası Tercüme Edilebilir mi?
“Türkçe Düşünen” Bir Yapay Zekâ Ne Demek?
Dil Verisinden Dijital Egemenliğe
Peki, Yapay Zekâ Türkçe Düşünebilir mi?