Ana bulgular: Bu yazıda Qwen3 ailesiyle Türkçe kıyaslama testleri (benchmark) üzerinde üç deney yapılmıştır: kalibrasyon verisinin dili (E1), bellek bütçesi (E2) ve decode hızı (E3). Deneylerin gösterdikleri kısaca şöyledir:
Sınır: Bulgular Qwen3 ailesindeki yoğun modeller, Türkçe çoktan seçmeli kıyaslama testleri ve tek bir H100 ile sınırlıdır.
Bu yazı, üç bölümlük "Kuantizasyon" serisinin ikinci yazısıdır. Seri boyunca Qwen3 ailesi Türkçe veri ve Türkçe kıyaslama testleriyle sınanmaktadır: birinci yazıda büyük modellerin bellek sorunu, kuantizasyonun ağırlıklar üzerindeki etkisi ile model boyutu ve bit sayısının etkisi; üçüncü yazıda karma hassasiyet, anahtar-değer (Key-Value, KV) önbelleği (KV cache) ve lm_head kuantizasyonu ele alınmaktadır. Bu yazı, birinci yazıda anlatılan bellek ve hız hesabının, kuantizasyonun temel adımlarının ve ortak deney kurulumunun üzerine kuruludur; önce birinci yazının okunması önerilir.
Bir modelin kuantize edilmesine karar verilmesi, sürecin yalnızca ilk adımıdır. Temel soru, modelin hangi yöntemle, kaç bitte ve hangi veriyle kuantize edileceğidir. Bu sorunun yanıtı, kullanım bağlamına göre değişmektedir. Aynı donanımla çok sayıda kullanıcıya hizmet veren bir model sağlayıcısı için temel soru, eş zamanlı istek sayısı arttığında hangi formatın hızlı kaldığıdır. Müşteri verisini kendi sunucusunda tutan bir altyapı ekibi için temel soru, çoğunlukla İngilizce veriyle hazırlanmış hazır bir kuantizasyonun Türkçe konuşan kullanıcılar üzerindeki etkisidir. Grafik İşlem Birimi (GPU) belleği 8 ile 24 GB arasında olan bir kullanıcı için temel soru, bu belleğe sığan en iyi modelin hangisi olduğudur. Bu bağlamlarda tam hassasiyetli küçük bir modelin mi, sıkıştırılmış büyük bir modelin mi tercih edilmesi gerektiği temel sorulardan biridir.
Bu yazıda önce bir kuantizasyon yöntemi seçerken sorulması gereken dört soruyu ve kalibrasyon kullanan yöntemlerin nasıl çalıştığı ele alınacaktır. Ardından Qwen3 ailesiyle üç deney yapılacaktır: kalibrasyon verisinin dilinin Türkçedeki kaybı nasıl değiştirdiğini, belirli bir bellek bütçesinde hangi model ve kuant birleşiminin en iyi sonucu verdiğini ve kuantizasyonun decode hızını gerçekte ne kadar artırdığı ölçülecektir.
Birinci yazıda anlatılan yuvarlama, eğitimi bitmiş bir modeli yeniden eğitmeden sıkıştırır. Bu yaklaşıma eğitim sonrası kuantizasyon (post-training quantization, PTQ) denir. Bir PTQ yöntemi seçmek, dört soruya verilen cevaplarla büyük ölçüde belirlenir.
Bir kuantizasyon formatı ancak onu okuyabilen bir çıkarım motoru (inference engine) varsa işe yarar; bu nedenle ilk soru donanımdır. GGUF, llama.cpp'nin formatıdır; Merkezî İşlem Birimi (CPU), Apple Silicon, NVIDIA ve AMD üzerinde çalışır ve modeli GPU ile işlemci belleği arasında bölebilir.【1】 Mac'te MLX, Apple Silicon'un ortak belleği için yazılmış bir seçenektir.【2】 Tek bir NVIDIA kartında ExLlamaV3, ağırlık başına bit sayısını kesirli değerlere kadar ayarlamaya izin verir.【3】 Sunucuda ise vLLM ve SGLang gibi motorlar GPTQ, AWQ, INT8 ve 8 bit kayan nokta (FP8) kuantlarını çalıştırır.【4】
Tek kullanıcılı yerel kurulumlarda darboğaz ağırlıkların okunmasıdır ve yalnızca ağırlıkları sıkıştıran 4 bitlik kuantlar hem belleği hem hızı iyileştirir. Çok kullanıcılı servislerde darboğaz hesaplamaya kayar; burada ağırlık ve aktivasyonları birlikte sıkıştıran FP8 Ada Lovelace ve Hopper GPU'larda donanım desteğiyle çalışır, Blackwell kuşağında NVFP4 aynı rolü 4 bitte üstlenir.【5】 Ağırlık ve aktivasyon bitleri kısaca W ve A ile yazılır: GPTQ W4A16'da ağırlıklar 4 bitte saklanıp 16 bitte çarpılır, FP8 W8A8'de ise çarpımın kendisi 8 bitte yapılır. Bu nedenle ilki belleği ve tek kullanıcılı kod çözme (decode) hızını, ikincisi girdinin tamamının tek seferde işlendiği ön doldurma (prefill) aşamasını ve yoğun servisleri hızlandırır.
Hedef bit sayısı, yöntemin ne kadar özenli olması gerektiğini belirler. 8 bitte basit yuvarlama çoğu durumda yeterli olabilir; önceki değerlendirmelerde FP8 ağırlık ve aktivasyon kuantizasyonunun kaliteyi büyük ölçüde koruduğu görülmüştür.【6】 Modellerin Brain Floating Point 16 (BF16) kopyaları ince ayar (fine-tuning) ve araştırma için, FP8 kopyaları ise servis için yayımlanmaktadır. 4 bitte kalibrasyon kullanan yöntemler doğruluğun korunmasında belirleyici olabilir. 3 bit ve altında kalibrasyon tek başına yeterli olmayabilir; bitleri tensörler arasında eşit dağıtmayan karma hassasiyet gerekebilir.
Yöntemler bu soruda ikiye ayrılır. Veri gerektirmeyenler hızlıdır: birinci yazıda ele alınan en yakın değere yuvarlama (round-to-nearest, RTN), ızgara seviyelerini normal dağılımın yoğun olduğu bölgelere sıklaştıran NormalFloat4 (NF4)【7】ölçeği hızlıca optimize eden Yarı İkinci Dereceden Kuantizasyon (Half-Quadratic Quantization, HQQ)【8】 ve aktivasyon ölçeğini çalışma anında hesaplayan FP8. Diğerleri bir kalibrasyon verisi (calibration data), yani modelden geçirilen örnek metinler kullanır. GPTQ ağırlıkları sırayla kuantize eder ve her adımda oluşan hatayı henüz kuantize edilmemiş ağırlıkları düzelterek telafi eder.【9】 AWQ, aktivasyonu büyük kanallara bağlı ağırlıkları önemli sayıp kuantizasyondan önce ölçekleyerek korur.【10】 llama.cpp'nin imatrix aracı kalibrasyon metninden bir önem matrisi çıkarır ve GGUF kuantlarında yuvarlamayı önemli ağırlıklara göre yönlendirir.【11】 Ağırlık matrislerini döndürerek aykırı değerleri (outlier) dağıtan QuaRot ve SpinQuant gibi yöntemler ise 4 bitlik ağırlık ve aktivasyon kuantizasyonunu hedefler.【12】
Bu durum, Qwen3 tokenizer'ı ile üç kısa Türkçe paragraf ve İngilizce karşılıkları bölündüğünde gözlenmiştir: Türkçe metin, İngilizce karşılığından ortalama 1.67 kat (310'a karşı 186 token), Belebele'nin 900 paralel paragrafında ise 1.61 kat daha fazla token'a bölünmüştür; token başına karakter sayısı Türkçede 3.1, İngilizcede 4.8 olmuştur.
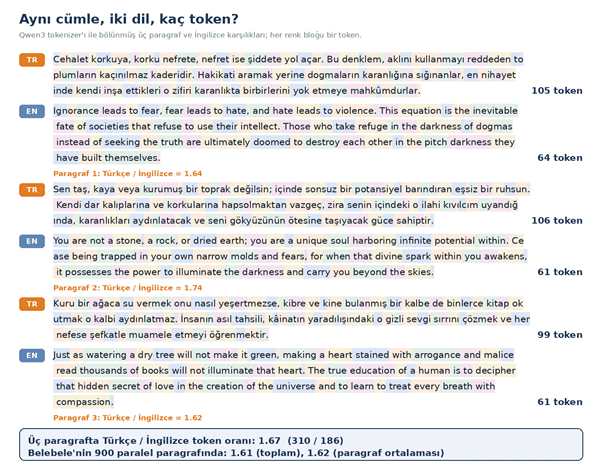
Aynı Cümlenin İki Dilde Qwen3 Tokenizer'ıyla Bölünmesi (Çizim: Elif İnce)
Kalibrasyon kullanan yöntemler, hangi ağırlığın önemli olduğuna gördükleri metne bakarak karar verir. Araçların varsayılan kalibrasyon kümeleri çoğunlukla İngilizcedir. Türkçe metin işlenirken etkinleşen kanallar İngilizce metinde etkinleşmiyorsa yöntem bu kanalları önemsiz sayar ve daha kaba yuvarlar. Aynı içerik İngilizceye göre daha fazla token'a bölünür;【13】 bunda Türkçenin eklemeli yapısının rol oynadığı düşünülebilir. Bu durumda bir yanıtın daha fazla adımda üretilmesi, her adımdaki küçük sapmaların birikmesine yol açabilir. Kuantizasyonun İngilizce dışındaki bazı dillerde daha fazla bozulmaya yol açtığı ve otomatik ölçütlerin bu bozulmayı insan değerlendirmesinden daha az gösterdiği bildirilmiştir.【14】 Bu sonuç Türkçe için ayrıca sınanmalıdır. Kalibrasyon dilinin etkisi E1'de doğrudan ölçülecektir.
Tablo 1, bir yöntem seçmenin bir format ile bir motoru birlikte seçmek olduğunu gösterir: aynı Qwen3-8B, Mac'te MLX ya da GGUF olarak, sunucuda FP8 ya da AWQ olarak çalıştırılır.
Tablo 1: Kuantizasyon Yöntemi Seçiminde Durum, Önerilen Seçim, Gerekçe ve Kaçınılacak Seçenekler
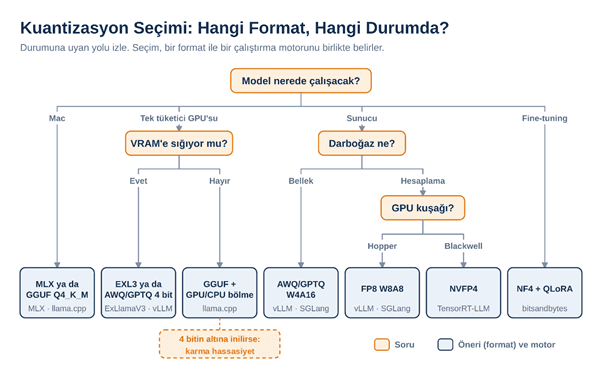
Kuantizasyon Seçim Ağacı (Çizim: Elif İnce)
Yandaki kuantizasyon seçim ağacı aynı seçimi bu sorular boyunca izler; yaprakta bir format ile onu çalıştıran motor birlikte bulunur.
GPTQ her katman için tek bir hedefe bakar: kuantize ağırlıklarla elde edilen katman çıktısı, orijinal çıktıya kalibrasyon girdilerinde olabildiğince yakın olmalıdır. Ağırlıkları sütun sütun kuantize eder; bir sütunu yuvarladığında oluşan hatayı, henüz yuvarlanmamış sütunlara, girdiler arasındaki ilişkiyi tutan bir matrisin tersini kullanarak dağıtır.【15】
Bu düzeltmenin sonucunda tek tek ağırlıkların hatası RTN'den büyük olabilir; ancak katmanın çıktısındaki hata küçülür. Kalibrasyon girdileri H matrisini belirlediği için GPTQ'nun hangi hataları önemli saydığı, gördüğü metne bağlıdır.
Akılda kalsın: Kuantizasyon yöntemi donanıma, kullanıcı sayısına, hedef bit sayısına ve kalibrasyon imkânına göre seçilir; bu seçim bir format ile bir çalıştırma motorunu birlikte belirler.
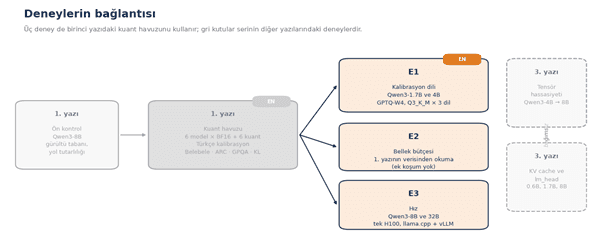
Deneylerin Birbirine Bağlantısı: E1, E2 ve E3 (Çizim: Elif İnce)
Şemada turuncu İngilizce (EN) rozeti İngilizce ölçüm içeren deneyi gösterir; gri kutular serinin diğer yazılarında ele alınan deneylerdir. Serideki bütün koşumlar tek bir H100'de (80 GB) gerçekleştirilmiştir; toplam süre 10.7 GPU-saattir.
Önceki bölümde anlatılan yaklaşımlar bu bölümde Qwen3 ailesinin yoğun modelleri üzerinde, Türkçe kıyaslama testleriyle sınanmıştır. Ana ölçüt görev doğruluğudur; İngilizce yalnızca karşılaştırma için ölçülmüştür. Cevabı aranan sorular şunlardır:
Birinci yazıda altı Qwen3 modeli altı kuantla (FP8, Q8_0, GPTQ-W4, Q4_K_M, Q3_K_M, Q2_K) Türkçe kalibrasyonla üretilip ölçülmüştür. E1'de bu kuantlardan ikisi üç farklı kalibrasyon kümesiyle yeniden üretilmiş ve yazının İngilizce yan sonucu elde edilmiştir; E2 ve E3'te birinci yazıdaki kuantlar yeniden kullanılmıştır.
Deneylerde birinci yazıdaki ortak kurulum kullanılmıştır; bu yazıyla ilgili kısımlar aşağıda verilmiştir.
Tablo 2: Ortak Kurulum; Modeller, Kuantlar, Kalibrasyon ve Ölçütler (Bu yazıyı ilgilendiren kısım)
Ölçüm: Ana ölçüt, kuantize modelin doğruluğunun aynı modelin BF16 kopyasına göre farkıdır; her kuant aynı soruları çözdüğü için bu fark, sorular eşleştirilerek yeniden örnekleme (bootstrap) ile %95 güven aralığıyla (GA) verilir. Cevap değiştirme (flip) oranı, BF16 modelin doğru cevaplarının yanlışa, yanlış cevaplarının doğruya dönme sıklığıdır; ortalama doğruluk aynı kalırken cevaplar değişebildiği için doğrulukla birlikte yorumlanır.【24】 Birinci yazıdaki ön kontrolde ölçüm zincirinin gürültü tabanı ±0.47 puan olarak ölçülmüştür; bu banttan küçük farklar gürültü olarak değerlendirilmiştir.
Türkçe kalibrasyon kümesi, BellaTurca'nın özenle temizlenmiş genel web metinlerinden oluşan OzenliDerlem alt kümesinden rastgele örneklenmiştir.【25】 İki küme de web kaynaklıdır; ancak C4, Common Crawl'dan filtrelenirken OzenliDerlem küratörlü sitelerden derlenir, bu nedenle kümeler dilin yanı sıra alan ve temizleme bakımından da ayrışır. Kalibrasyon örnek sayısı GPTQ'nun özgün çalışmasındaki 128 örneği izler.【26】
Belebele'nin Türkçe ve İngilizce kümeleri aynı paragraflar üzerine kurulmuş aynı sorulardır; paragraflar FLORES-200'den alınmıştır.【27】 İki dilin aynı içerikte karşılaştırılmasını bu sağlar. ARC-tr, ARC-Challenge test bölümünün insan kontrolünden geçmiş Türkçe çevirisidir.
Kıyaslama testleri, logaritmik olabilirlik (log-likelihood) tabanlı çoktan seçmeli puanlamayla çalıştırılmıştır; model metin üretmediği için Qwen3'ün düşünme modunun sonuçları etkilememesi beklenir. GPTQ ve FP8 kuantları vLLM'de kendi çekirdekleriyle çalışır.【28】 GGUF kuantlarının ağırlıkları BF16'ya geri açılıp aynı motorda değerlendirilir; böylece bütün kuantlar aynı ölçüm zincirinden geçer. Bu yolun llama.cpp'nin kendisiyle aynı sonucu verdiği, birinci yazıdaki ön kontrolde doğrulanmıştır.
Soru: Kalibrasyon verisinin dili Türkçedeki kaybı değiştirir mi, bu etki model boyutuna göre farklılaşır mı ve İngilizce doğrulukta bir kayba yol açar mı?
Kurulum: Qwen3-1.7B ve Qwen3-4B için kalibrasyon kullanan iki kuant (GPTQ-W4 ve imatrix'li Q3_K_M) üç kalibrasyon kümesiyle üretilmiştir: İngilizce (allenai/c4), Türkçe (BellaTurca OzenliDerlem) ve karışık. Qwen3-4B'de her küme iki farklı rastgelelik tohumuyla (seed; s0, s1) örneklenmiş; Qwen3-1.7B'de yalnızca s0 çalıştırılmıştır. Türkçe ana sonuç Belebele-tr ve ARC-tr'dir. İngilizce yan sonuç Belebele-en ile ARC-tr'nin kaynağı olan allenai/ai2_arc veri setinin ARC-Challenge test bölümüdür (ARC-en).
Tablo 3: Kalibrasyon Koşulları (Kontrol, K-en, K-tr ve K-mix)
Beklenti ve yorum: Türkçe kalibrasyonun Türkçedeki kaybı azaltması, etkinin 3 bitte 4 bitten ve 1.7B'de 4B'den büyük olması, karışık kalibrasyonun ise İngilizceden belirgin bir şey götürmeden Türkçe kaybın çoğunu kapatması beklenir. K-tr Türkçeyi iyileştirirken İngilizceyi bozarsa kuant hedef dile göre ayrı üretilmelidir; K-tr ve K-mix İngilizcede K-en'e yakın kalırsa pratik öneri en azından karışık kalibrasyondur; dil fark yaratmazsa birinci yazıdaki dil farkı kalibrasyondan değil, modelin Türkçe temsillerinden ya da tokenizasyondan kaynaklanıyor olabilir; tohumlar arası değişkenlik dil etkisinden büyükse sonuç "fark ayırt edilemedi" olarak raporlanır.
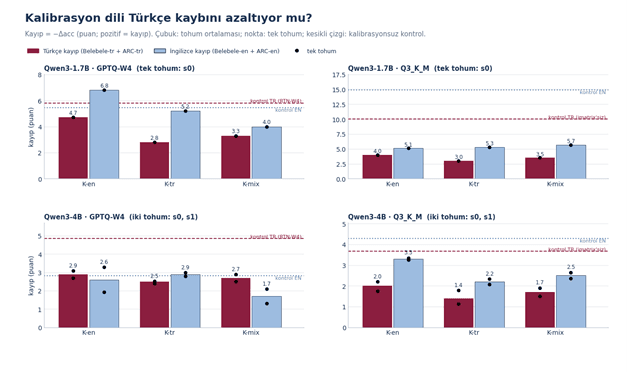
Kalibrasyon Dili ve Türkçe/İngilizce Kayıp (Çizim: Elif İnce)
Kalibrasyonun varlığı, kalibrasyon dilinden daha büyük bir etki göstermiştir. imatrix'siz Q3_K_M kontrolünde Türkçe kayıp 1.7B'de 9.98, 4B'de 3.67 puan iken, imatrix'li üç kümede 1.7B'de 3.03–3.95, 4B'de 1.45–1.97 puana inmiştir. Kalibrasyonsuz RTN-W4 kontrolü 1.7B'de 5.81, 4B'de 4.84 puan kaybederken GPTQ-W4 1.7B'de 2.83–4.66, 4B'de 2.5–2.9 puan kaybetmiştir. Tek istisna 1.7B GPTQ-W4'tür: K-en, RTN-W4'ten 1.15 puan daha az kayıp verirken (4.66'ya karşı 5.81) K-tr, K-en'den +1.84 puan daha iyidir; bu hücrede dil etkisi, kalibrasyonun varlığı etkisinden büyüktür (RTN kontrolü tek tohumdur).
Bulgular: Kayıp, BF16'ya göre −Δacc olarak verilmiştir (Türkçe: Belebele-tr ve ARC-tr ortalaması; İngilizce: Belebele-en ve ARC-en ortalaması). Üç bulgu öne çıkmıştır.
Türkçe kalibrasyonun sağladığı artış küçük, ancak tutarlı yöndedir. Türkçe kalibrasyonun (K-tr) İngilizce kalibrasyona (K-en) göre Türkçe doğruluk farkı, eşleştirilmiş yeniden örnekleme (bootstrap) ile şöyle bulunmuştur: 1.7B GPTQ-W4'te +1.84 puan (GA [−0.26, +3.87]), 1.7B Q3_K_M'de +1.0 [−0.5, +2.5]; 4B GPTQ-W4'te +0.30 ve +0.58 (s0 ve s1), 4B Q3_K_M'de +0.42 ve +0.62 puan; hiçbirinin GA'sı tek başına sıfırı dışlamamıştır, ancak altı sonucun (dört model–yöntem çifti; 4B'de iki tohum ayrı sayılmıştır) tamamı aynı yöndedir (ortalama +0.8 puan) ve etki 1.7B'de 4B'den büyüktür. Beklentinin aksine etki 3 bitte 4 bitten belirgin biçimde büyük çıkmamıştır: 1.7B'de GPTQ-W4'te +1.84, Q3_K_M'de +1.0; 4B'de iki yöntemde farklar yakındır (ortalama +0.44 ve +0.52 puan). Aynı kalibrasyonun iki tohumu arasındaki fark (4B) Türkçede ortalama 0.31 (GPTQ-W4) ve 0.51 puan (Q3_K_M) olmuş, tek tek karşılaştırmalarda 1.4 puana çıkmıştır (GPTQ-W4, K-en, İngilizce: +1.38, GA [+0.26, +2.49]); bu nedenle tohum farkı dil farkıyla aynı büyüklüktedir ve tek bir tohumla küçük artış kesinleştirilememiştir.
İngilizceye belirgin bir bedel gözlenmemiştir; karışık kalibrasyon sonuçları diğer iki kalibrasyonun arasında yer almıştır. K-tr, İngilizce doğruluğunu sistematik olarak bozmamıştır: 1.7B GPTQ-W4'te İngilizce kaybı 6.81'den 5.16'ya, 4B Q3_K_M'de 3.27'den 2.23'e inmiştir (4B Q3_K_M, K-tr − K-en: s0'da +0.88, s1'de +1.22 puan, GA [+0.26, +2.17]; bu koşulda fark sıfırı dışlıyor, yani K-tr İngilizcede de K-en'den daha iyi); buna karşılık 1.7B Q3_K_M'de (5.10 → 5.25) ve 4B GPTQ-W4'te (2.65 → 2.90) K-tr, K-en'in 0.15–0.25 puan gerisinde kalmış ve bu fark gürültü bandı (±0.47) içindedir. K-mix Türkçede K-en ile K-tr arasında kalmış, İngilizcede çoğunlukla K-en'e yakın ya da daha iyi (1.7B Q3_K_M'de 0.55 puan geride): İngilizce kaybı 1.7B GPTQ-W4'te 3.97 (K-en 6.81), 1.7B Q3_K_M'de 5.65 (K-en 5.10), 4B'de 1.7 (GPTQ-W4; K-en 2.6) ve 2.55 (Q3_K_M; K-en 3.27) olarak bulunmuştur.
Tablo 4: Görev Başarımı (BF16'ya Göre Doğruluk, Türkçe ve İngilizce)
4B satırları iki tohumun ortalaması, 1.7B satırları tek tohumdur. Birinci yazıdaki 4B değerleri s0 tohumuna aittir. Son sütun eşleştirilmiş yeniden örnekleme (bootstrap) farkıdır; hiçbir farkın %95 GA'sı sıfırı dışlamadığı için kalın hücre kullanılmamıştır. Kontrol satırları kalibrasyonsuzdur: GPTQ'da RTN-W4, Q3_K_M'de imatrix'siz Q3_K_M.
Sonuç E1: K-tr, K-en'e göre Türkçede küçük ama yönü tutarlı bir kazanç sağlamış, K-mix ise ikisinin arasında kalmıştır; İngilizceye belirgin bir bedel gözlenmemiş, ancak Türkçe farkların hiçbiri istatistiksel olarak ayırt edilememiştir. Kalibrasyonun varlığı genel olarak dilinden daha önemlidir (ayrıntı: Bulgular). K-tr ya da K-mix, kanıtı zayıf ama maliyetsiz bir varsayılan olarak önerilir.
Soru: Belirli bir bellek bütçesinde Türkçede en iyi sonucu hangi model ve kuant birleşimi verir?
Kurulum: Ek koşum yapılmamıştır. Birinci yazıdaki 42 noktanın (6 model × BF16 ve 6 kuant; tam liste birinci yazının Ek bölümünde) hepsi disk boyutuna karşı Belebele-tr ve ARC-tr ortalamasıyla çizilir ve Pareto sınırı çıkarılır. Örnek karşılaştırmalar (disk boyutuyla): yaklaşık 16 GB'ta Qwen3-8B BF16 ile Qwen3-32B Q3_K_M ve Qwen3-14B Q8_0; yaklaşık 8 GB'ta Qwen3-4B BF16 ile Qwen3-8B Q4_K_M.
Beklenti ve Yorum: Pareto sınırının çoğunlukla büyük modellerin 4 bit civarındaki kuantlarından oluşması ve BF16 kopyaların sınırın gerisinde kalması beklenir: 3–8 bit aralığını inceleyen bir çalışmada 4 bit, toplam model bit sayısı ve doğruluk bakımından çoğu durumda en uygun nokta bulunmuştur.【29】 Bu üstünlüğün 3 bite yaklaştıkça azalması beklenir. Sonuçlar şöyle okunur: sınırı 4 bit civarındaki büyük modeller oluşturursa, "En büyük modeli 4 bitte çalıştır" önerisi Türkçe için de geçerlidir; sınırda 2–3 bitlik büyük modeller de yer alırsa bu aile düşük bite beklenenden dayanıklıdır ve bulgu birinci yazıdaki kırılma noktasıyla birlikte yorumlanır; BF16 küçük modeller sınırda kalırsa Türkçede sıkıştırmanın bedeli İngilizce için bildirilen eğilimden yüksektir.
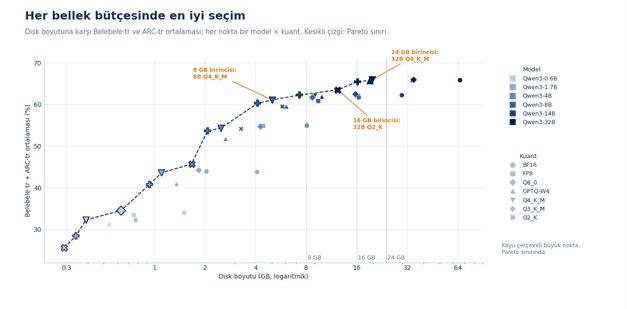
Disk Boyutuna Karşı Doğruluk ve Pareto Sınırı (Çizim: Elif İnce)
Bulgular: Bu 42 noktanın tamamı disk boyutuna karşı çizilmiştir. Pareto sınırında 16 nokta bulunmuş ve hepsi kuantize olmuştur: BF16 ve FP8 kopyaların hiçbiri sınırda yer almamıştır. Örneğin 8 GB civarında Qwen3-4B BF16 (8.0 GB) Belebele-tr ve ARC-tr ortalamasında %54.9 elde ederken Qwen3-8B Q4_K_M (5.0 GB) %61.1 elde etmiştir; 16 GB civarında Qwen3-8B BF16 (16.4 GB) %61.8, Qwen3-14B Q8_0 (15.7 GB) %62.5, Qwen3-32B Q3_K_M (16.2 GB) ise %65.5 elde etmiştir; ancak tahmini belleği 18.3 GB olduğundan 16 GB bütçeye sığmamaktadır; o bütçede 32B Q2_K (12.3 GB, %63.5) en iyi sığan seçenektir. Bu örnekler disk boyutuyla verilmiştir; KV önbelleği ve çalışma payı eklenince 4B BF16, 8B BF16 ve 14B Q8_0 ilgili bütçeye sığmaz (Tablo 5'te seçim tahmini belleğe göre yapılmıştır). Birinci yazıda 32B için Q2_K kırılma noktası olarak bulunmuştu (−2.33 puan); buna rağmen bu bütçede sığan en iyi doğruluğu vermektedir.
Bütçe başına en iyi üç seçim, 4K bağlamlı KV önbelleği (KV cache) ve 1 GB çalışma payı eklenerek hesaplanmıştır. 8 GB bütçede birinci sırada Qwen3-8B Q4_K_M, 16 GB bütçede Qwen3-32B Q2_K, 24 GB bütçede Qwen3-32B Q4_K_M yer almıştır. Ancak sıralamanın bir kısmı istatistiksel olarak ayırt edilememiştir: 16 GB'ta ilk iki seçim (32B Q2_K ve 14B Q3_K_M) ile 24 GB'ta ilk üç seçim (32B Q4_K_M, 32B GPTQ-W4 ve 32B Q3_K_M) GA'ları örtüştüğü için eşdeğer sayılmalıdır. Büyük modelin düşük bitli kuantı bu veride sınırda yer almıştır: Qwen3-32B Q2_K (≈3.0 bit) 12.3 GB'ta %63.5 ile sınırdadır; buna karşılık 1.7B, 8B ve 14B'de Q2_K sınırın altında kalmıştır (Qwen3-1.7B Q2_K: −11.58 puan), yalnızca 0.6B ve 4B'nin Q2_K kuantı küçük boyutlarda sınırda yer almıştır.
Tablo 5: Bellek Bütçesi Başına İlk Üç Seçim
Tahmini bellek = disk + 4K bağlamda KV önbelleği + 1 GB çalışma payı; bütçe birincileri bu değerle seçilmiştir. Doğruluk, iki görevin ortalamasıdır. 8 GB'ta 3. sıradaki Qwen3-14B Q2_K (59.56) ile Qwen3-8B GPTQ-W4 (59.55) arasındaki fark 0.01 puandır; bu iki seçenek eşit sayılmalıdır.
Sonuç E2: İncelenen modeller ve Türkçe görevler kapsamında her bellek bütçesinde en iyi doğruluk, çoğunlukla büyük bir modelin 3–4 bit civarındaki kuantıyla elde edilmiştir: 8 GB için Qwen3-8B Q4_K_M (14B Q2_K üçüncü sıradadır), 16 GB için Qwen3-32B Q2_K (ya da eşdeğeri 14B Q3_K_M), 24 GB için Qwen3-32B Q4_K_M (ya da eşdeğerleri GPTQ-W4 ve Q3_K_M). BF16 ve FP8 kopyalar bu bütçelerde geride kalmıştır.
Soru: Ölçülen decode hızı, birinci yazıdaki "bant genişliği ÷ model boyutu" sınırının ne kadarına ulaşır?
Kurulum: Qwen3-8B ve Qwen3-32B'nin bütün kuantları tek H100'de, tek istek, 512 token'lık girdi ve 256 token'lık üretimle ölçülmüştür; ön doldurma (prefill) ve kod çözme (decode) hızları ayrı raporlanmış, her ölçüm üç tekrarın ortalaması olarak alınmıştır. Girdi rastgele token dizisidir (llama.cpp'nin hız aracı yalnızca rastgele dizi kabul eder; hızın dilden bağımsız olduğu varsayıldığı için bu deney İngilizcede tekrarlanmamıştır). GGUF kuantları llama.cpp'de, diğerleri vLLM'de çalıştırılmıştır. Ek olarak 32B'nin BF16, FP8 ve GPTQ-W4 kopyaları vLLM ile 1, 4, 16 ve 64 eş zamanlı istekte ölçülmüştür.
Beklenti ve Yorum: Tek istekte decode hızlarının teorik eğriye paralel ama altında kalması, açma maliyeti yüksek bazı GGUF türlerinin eğriden daha çok uzaklaşması, eş zamanlı istek arttıkça darboğazın hesaplamaya kayması ve FP8'in bir noktada GPTQ-W4'ün önüne geçmesi beklenir. Noktalar eğriye paralelse hız bant genişliğiyle sınırlıdır; en küçük kuantlar eğriden kopuyorsa bu kuantlar bellek kazandırır ancak hız kazandırmaz; FP8 öne geçerse "Hangi Kuantizasyon Ne Zaman Seçilmelidir?" bölümündeki ayrım (yerelde ağırlık, serviste aktivasyon) bu kurulumda doğrulanmış olur ve geçiş noktası raporlanır.
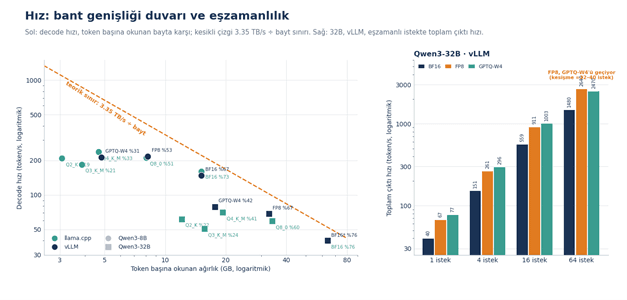
Decode Hızı ve Bant Genişliği Sınırı (Çizim: Elif İnce)
Bulgular: Tek kullanıcılı decode'da her yeni token için bütün ağırlıklar bellekten bir kez okunduğundan teorik sınır, H100'ün 3.35 TB/s'lik bant genişliği token başına okunan bayta bölünerek hesaplanmıştır.
Teorik Sınıra Ulaşma: llama.cpp'de 8B BF16 161 token/s ile sınırın %73'üne (221), Q8_0 212 token/s ile %51'ine, Q4_K_M 237 token/s ile %33'üne ulaşmıştır; 32B'de aynı sıra %76, %60 ve %41 olmuştur. Boyutun küçültülmesi hızı artırmış, ancak artış bayt azalmasıyla orantılı olmamıştır: Q4_K_M'de bayt 3.2 kat azalırken (8B: 15.1 → 4.7 GB) hız 1.47 kat artmıştır (32B: bayt 3.3 kat azalırken 1.77 kat).
Açma Maliyeti (Olası Neden): En küçük GGUF türlerinin hızı teorik eğrinin belirgin biçimde altında kalmıştır: Qwen3-8B'de Q3_K_M (185 token/s) ve Q2_K (209), Q4_K_M'den (237) yavaştır, Q3_K_M Q8_0'dan (212) bile yavaştır; 32B'de Q3_K_M 50.9, Q2_K 61.9, Q4_K_M 70.5 token/s olarak ölçülmüştür. Bu kuantlar bellekte kazanç sağlamış; hızda ise Q4_K_M'nin gerisinde kalmıştır (BF16'ya göre yine de hızlıdır). llama.cpp'de ön doldurma (prefill) aşamasında ise bütün kuantlar BF16'dan yavaş kalmıştır: 8B'de 23 637 token/s'den Q4_K_M'de 9 605'e, 32B'de 6 441'den 2 474'e düşülmüştür (yaklaşık 0.4 kat).
vLLM ve Eş Zamanlılık: vLLM'de 32B decode hızı BF16'da 40.0 (†), FP8'de 68.6 ve GPTQ-W4'te 78.8 token/s; 8B'de 147.9, 217.0 ve 213.3. GPTQ-W4 en az bayt okumasına rağmen sınırın yalnızca %42'sine (32B) ve %31'ine (8B) ulaşmıştır: çekirdek yükünün baskın olduğu düşünülmektedir. vLLM ön doldurma (prefill) hızı ilk token süresinden hesaplanmıştır: FP8, BF16'nın yaklaşık 1.3 katı hızlıdır (8B'de 33 800'e karşı 26 400; 32B'de 8 900'e karşı 6 900 token/s), GPTQ-W4 ise yaklaşık 0.8 katıdır (21 900 ve 5 600). Eş zamanlılıkta (32B, vLLM) toplam çıktı hızı 1, 4, 16 ve 64 istekte BF16'da 40, 151, 559 ve 1 480; FP8'de 67, 261, 911 ve 2 640; GPTQ-W4'te 77, 296, 1003 ve 2 470 token/s. Eş zamanlılık koşumları ayrı bir ölçümdür; 1 istekte toplam çıktı hızı (FP8'de 67, GPTQ-W4'te 77), Tablo 6'daki tek istek decode hızından (68.6 ve 78.8) 1–2 token/s düşüktür. GPTQ-W4/FP8 oranı 1.15'ten 1.13'e, 1.10'a ve 64 istekte 0.94'e düşmüştür: FP8, 16 ile 64 eş zamanlı istek arasında GPTQ-W4'ü geçmiştir (bu aralıkta ölçüm yok; ölçülen noktalar arasında interpolasyonla yaklaşık 30–45 istek). Darboğazın hesaplamaya kayması, ağırlık okumasındaki avantajın önemini yitirmesine ve W8A8'in daha hızlı matris çarpımının öne çıkmasına yol açıyor olabilir.
Tablo 6: Decode ve Prefill Hızı
+ Qwen3-32B BF16'nın vLLM ölçümü max_model_len 4096 ile alınmıştır (40960 için 10.0 GiB KV önbelleği gerekirken 5.8 GiB kullanılabilir durumdaydı); diğer vLLM hücreleri 40960 ile ölçülmüştür. Etkinin küçük olması beklenmektedir, ancak ölçülmemiştir; 32B BF16, FP8 ya da GPTQ-W4 ile kıyaslanırken bu durum dikkate alınmalıdır. Sınıra oran, ölçülen hızın teorik sınıra yüzdesidir. vLLM ön doldurma (prefill) hızı, 512 token'lık girdinin ilk token süresinden hesaplanmıştır. Her hücre üç tekrarın ortalamasıdır, koşumlar arası değişkenlik ölçülmemiştir; GGUF ve vLLM hızları motorlar arası kıyas için değildir.
Sonuç E3: Ölçülen decode hızı, bant genişliği sınırının %19–77'sı: sınıra en yakın tür BF16, en uzak türler ise 3 bit ve altındaki GGUF türleri olmuştur. llama.cpp kuantları arasında en hızlısı Q4_K_M olmuştur; vLLM'de FP8 ve GPTQ-W4, BF16'dan 1.4–2.0 kat hızlı decode vermiş ve 32B'de GPTQ-W4 az eşzamanlı istekte FP8'in önünde yer almıştır (8B'de tek istekte ikisi eşit düzeyde: 213.3 ve 217.0), ancak 16 ile 64 eşzamanlı istek arasında (interpolasyonla yaklaşık 30–45 istekte) FP8 öne geçmiştir; prefill'de de FP8 BF16'dan hızlı, GPTQ-W4 yavaş olmuştur.
Tablo 7: Deneylerin Özeti
Dil: Kuantizasyon yöntemleri ve onları doğrulayan kıyaslama testleri büyük ölçüde İngilizce üzerine kurulmuştur. Bir kuantın İngilizcede kayıpsız görünmesi Türkçede de kayıpsız olduğu anlamına gelmez; kalibrasyon verisinin dili ve değerlendirmenin dili ayrıca belirtilmelidir.
Donanım Desteği: Bir format, onu hızlı çalıştıran bir çekirdek (kernel) olmadıkça yalnızca bellek kazandırır. NVFP4, Blackwell kuşağı donanım gerektirir; FP8'in donanım hız kazancı Ampere ve önceki kartlarda görülmez; bazı GGUF türleri belirli donanımlarda daha büyük kuantlardan yavaş çalışabilir (bkz. E3).
Kapsam: Bu yazının bulguları Qwen3 ailesinin yoğun modellerine, Türkçeye (İngilizceye yalnızca karşılaştırma için), çoktan seçmeli kıyaslama testlerine, tek bir H100'e ve belirli yazılım sürümlerine aittir. Kalibrasyon deneyi iki model ve iki yöntemle, kalibrasyon kümesi başına en fazla iki tohumla gerçekleştirilmiştir; tek tek farklar istatistiksel olarak ayırt edilememiştir. Hız ölçümleri llama.cpp ve vLLM'in kendi çekirdeklerine bağlıdır ve iki motoru birbiriyle kıyaslamak için tasarlanmamıştır. AWQ, NF4, EXL3 ve NVFP4 gibi formatlar ile Hopper dışındaki GPU'lar kapsam dışıdır.
Bazı kurulumlarda olabilir. Ağırlıkları açma (dequantization) maliyeti yüksekse ya da donanımda uygun çekirdek yoksa hız kazancı sınırlı kalabilir; çalışmalarda 4 bit ağırlık ve 8 bit ağırlık-aktivasyon formatlarının hız avantajının dağıtım senaryosuna ve GPU türüne göre değiştiği gözlenmiştir.【30】 Tek kullanıcılı decode ise çoğu zaman hızlanır. E3'te llama.cpp'de bütün kuantların prefill hızı BF16'nın altında kaldı; Q3_K_M ve Q2_K ise decode'da bile Q4_K_M'den yavaştı; vLLM'de GPTQ-W4, 64 eşzamanlı istekte FP8'in gerisine düştü.
Aynı bellek bütçesinde, 3–8 bit aralığını inceleyen bir çalışmada 4 bitlik büyük modelin çoğu durumda en iyi sonucu verdiği bulunmuştur.【31】 Bu çalışma 3 bitin altını kapsamaz; eğilim daha düşük bitlerde ve dile göre değişebilir. E2'de Türkçe için de aynı eğilim gözlenmiştir: her bütçede öne çıkan, çoğunlukla büyük bir modelin 3–4 bitlik kuantıydı.
Bit sayısının yanında kalibrasyon kullanılıp kullanılmadığına ve kullanıldıysa hangi dilde veriyle yapıldığına bakılmalıdır; hazır kuantların birçoğunun İngilizce ağırlıklı veriyle kalibre edildiği görülmektedir. E1'de kalibrasyonun varlığı, kalibrasyon dilinden daha büyük bir etki göstermiştir; Türkçe ya da karışık kalibrasyon ise Türkçede küçük, ancak tutarlı yönde bir ek kazanç sağlamıştır.
Bir kuant seçmek, bir yöntemle birlikte bir formatı ve onu çalıştıran motoru seçmektir. Bu yazının deneylerinde, Türkçe kullanıcılar için bu seçimde kalibrasyonun, bellek bütçesinin ve kullanıcı sayısının etkisi incelenmiştir. E1'de Türkçe kalibrasyon (K-tr), İngilizce kalibrasyona (K-en) göre Türkçede altı sonucun altısında pozitif sonuç vermiş (ortalama +0.8 puan), karışık kalibrasyon (K-mix) K-en ile K-tr arasında kalmış ve İngilizceye belirgin bir bedel getirmemiştir; ancak tek tek farklar istatistiksel olarak ayırt edilememiştir. Kalibrasyonun varlığı genel olarak dilinden daha önemli bulunmuştur.
Bellek ve Hız: E2'de Pareto sınırı tamamen kuantize modellerden oluşmuştur: 8 GB'ta 8B Q4_K_M, 16 GB'ta 32B Q2_K (14B Q3_K_M ile eşdeğer), 24 GB'ta 32B Q4_K_M (32B GPTQ-W4 ve 32B Q3_K_M ile eşdeğer). E3'te decode hızı bant sınırının %19–77'sine ulaşmış; Q3_K_M ve Q2_K, Q4_K_M'den yavaş kalmış; 32B'de FP8, GPTQ-W4'ü 16 ile 64 eş zamanlı istek arasında geçmiştir.
Sınır: Bulgular Qwen3 ailesinin yoğun modelleri, Türkçe çoktan seçmeli kıyaslama testleri ve tek bir H100 ile sınırlıdır.
Açık kalan soru, Türkçede kalibrasyonla kapatılamayan bir kayıp kalması hâlinde bu kaybın kaynağının ne olduğudur: modelin kendi Türkçe temsilleri mi, yoksa Türkçenin daha fazla token'a bölünmesiyle biriken küçük sapmalar mı?
Serinin üçüncü ve son yazısında her tensörün aynı bitle sıkıştırılmasının gerekip gerekmediği incelenecektir: Türkçe metinle bir hassasiyet haritası çıkarılıp aynı boyutta karma hassasiyetli bir yapılandırma oluşturulacak, ardından ağırlıkların dışında KV önbelleği ile lm_head'in sıkıştırılmasının bellek, hız ve kalite üzerindeki etkisi ölçülecektir.
Alvarez, E., O. Almog, E. Chung, S. Layton, D. Stosic, R. Krashinsky ve K. Aubrey. “Introducing NVFP4 for Efficient and Accurate Low-Precision Inference.” NVIDIA Developer Technical Blog. 24 Haziran 2025. Erişim tarihi: 13 Ekim 2026. https://developer.nvidia.com/blog/introducing-nvfp4-for-efficient-and-accurate-low-precision-inference/
Ashkboos, S., A. Mohtashami, M. L. Croci, B. Li, P. Cameron, vd. “QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs.” arXiv 2024. Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/2404.00456
Badri, H. ve A. Shaji. “Half-Quadratic Quantization of Large Machine Learning Models.” Dropbox Tech. 22 Ekim 2025. Erişim tarihi: 8 Ekim 2026. https://dropbox.tech/machine-learning/halfquadratic-quantization-of-large-machine-learning-models
Bandarkar, L., D. Liang, B. Muller, M. Artexte, S. N. Shukla, vd. “The Belebele Benchmark: a Parallel Reading Comprehension Dataset in 122 Language Variants.” arXiv 2023. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2308.16884
Clark, P., I. Cowhey, O. Etzioni, T. Khot, A. Sabharwal, vd. “Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge.” arXiv 2018. Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/1803.05457
Dettmers, T. ve L. Zettlemoyer. “The case for 4-bit precision: k-bit Inference Scaling Laws.” arXiv 2022. Erişim tarihi: 4 Ekim 2026. https://arxiv.org/abs/2212.09720
Dettmers, T., A. Pagnoni, A. Holtzman ve L. Zettlemoyer. “QLoRA: Efficient Finetuning of Quantized LLMs.” arXiv 2023. Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/2305.14314
Dutta, A., S. Krishnan, N. Kwatra ve R. Ramjee. “Accuracy is Not All You Need.” arXiv 2024. Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2407.09141
EleutherAI. “Language Model Evaluation Harness.” GitHub. Erişim tarihi: 13 Ekim 2026. https://github.com/EleutherAI/lm-evaluation-harness
Frantar, E., S. Ashkboos, T. Hoefler ve D. Alistarh. “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers.” arXiv 2023. Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2210.17323
Kurtic, E., A. Marques, S. Pandit, M. Kurtz ve D. Alistarh. “‘Give Me BF16 or Give Me Death’? Accuracy-Performance Trade-Offs in LLM Quantization.” arXiv 2024. Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2411.02355
Kwon, W., Z. Li, S. Zhuang, Y. Sheng, L. Zheng, vd. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” arXiv 2023. Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2309.06180
Lin, J., J. Tang, H. Tang, S. Yang, W. Chen, vd. “AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration.” arXiv 2023. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2306.00978
Liu, Z., C. Zhao, I. Fedorov, B. Soran, D. Choudhary, vd. “SpinQuant: LLM Quantization with Learned Rotations.” arXiv 2025. Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/2405.16406
ML Explore. “MLX: An Array Framework for Apple Silicon.” GitHub. Erişim tarihi: 15 Ekim 2026. https://github.com/ml-explore/mlx
Marchisio, K., S. Dash, H. Chen, D. Aumiller, A. Üstün, vd. “How Does Quantization Affect Multilingual LLMs?” arXiv 2024. Erişim tarihi: 12 Ekim 2026. https://arxiv.org/abs/2407.03211
NVIDIA. “NVIDIA Model Optimizer.” GitHub. Erişim tarihi: 8 Ekim 2026. https://github.com/NVIDIA/Model-Optimizer
Open Language Data Initiative. “FLORES+.” Sürüm 5.0. Hugging Face. Erişim tarihi: 3 Ekim 2026. https://huggingface.co/datasets/openlanguagedata/flores_plus
Petrov, A., E. La Malfa, P. H. S. Torr ve A. Bibi. “Language Model Tokenizers Introduce Unfairness Between Languages.” arXiv 2023. Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2305.15425
Raffel, C., N. Shazeer, A. Roberts, K. Lee, S. Narang, vd. “Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer.” arXiv 2023. Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/1910.10683
Red Hat AI ve vLLM Project. "LLM Compressor." GitHub. Erişim tarihi: 3 Ekim 2026. https://github.com/vllm-project/llm-compressor
Turkish NLP Suite. “BellaTurca.” Erişim tarihi: 5 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/BellaTurca
Yang, A., A. Li, B. Yang, B. Zhang, B. Hui, vd. “Qwen3 Technical Report.” arXiv 2025. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2505.09388
Zheng, L., L. Yin, Z. Xie, C. Sun, J. Huang, vd. “SGLang: Efficient Execution of Structured Language Model Programs.” arXiv 2024. Erişim tarihi: 15 Ekim 2026. https://arxiv.org/abs/2312.07104
bitsandbytes Foundation. “bitsandbytes.” GitHub. Erişim tarihi: 2 Ekim 2026. https://github.com/bitsandbytes-foundation/bitsandbytes
ggml-org. “llama.cpp: LLM Inference in C/C++.” GitHub. Erişim tarihi: 6 Ekim 2026. https://github.com/ggml-org/llama.cpp
malhajar. “arc-tr-v0.2.” Hugging Face. Erişim tarihi: 8 Ekim 2026. https://huggingface.co/datasets/malhajar/arc-tr-v0.2
turboderp-org. “ExLlamaV3.” GitHub. Erişim tarihi: 7 Ekim 2026. https://github.com/turboderp-org/exllamav3
[1]
ggml-org, “llama.cpp: LLM Inference in C/C++,” GitHub, Erişim tarihi: 6 Ekim 2026. https://github.com/ggml-org/llama.cpp
[2]
ML Explore, “MLX: An Array Framework for Apple Silicon,” GitHub, Erişim tarihi: 15 Ekim 2026. https://github.com/ml-explore/mlx
[3]
turboderp-org, “ExLlamaV3,” GitHub, Erişim tarihi: 7 Ekim 2026. https://github.com/turboderp-org/exllamav3
[4]
W. Kwon, Z. Li, S. Zhuang, Y. Sheng, L. Zheng, vd., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” arXiv 2023, 1-3, Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2309.06180; Red Hat AI ve vLLM Project, "LLM Compressor," GitHub, Erişim tarihi: 3 Ekim 2026. https://github.com/vllm-project/llm-compressor; L. Zheng, L. Yin, Z. Xie, C. Sun, J. Huang, vd., “SGLang: Efficient Execution of Structured Language Model Programs,” arXiv 2024, 6, Erişim tarihi: 15 Ekim 2026. https://arxiv.org/abs/2312.07104
[5]
NVIDIA, “NVIDIA Model Optimizer,” GitHub, Erişim tarihi: 8 Ekim 2026. https://github.com/NVIDIA/Model-Optimizer; E. Alvarez, O. Almog, E. Chung, S. Layton, D. Stosic, R. Krashinsky ve K. Aubrey, “Introducing NVFP4 for Efficient and Accurate Low-Precision Inference,” NVIDIA Developer Technical Blog, 24 Haziran 2025, Erişim tarihi: 13 Ekim 2026. https://developer.nvidia.com/blog/introducing-nvfp4-for-efficient-and-accurate-low-precision-inference/
[6]
E. Kurtic, A. Marques, S. Pandit, M. Kurtz ve D. Alistarh, “‘Give Me BF16 or Give Me Death’? Accuracy-Performance Trade-Offs in LLM Quantization,” arXiv 2024, 1, Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2411.02355
[7]
Dettmers, T., A. Pagnoni, A. Holtzman ve L. Zettlemoyer, “QLoRA: Efficient Finetuning of Quantized LLMs,” arXiv 2023, 2, 9, Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/2305.14314; bitsandbytes Foundation, “bitsandbytes,” GitHub, Erişim tarihi: 2 Ekim 2026. https://github.com/bitsandbytes-foundation/bitsandbytes
[8]
H. Badri ve A. Shaji, “Half-Quadratic Quantization of Large Machine Learning Models,” Dropbox Tech, 22 Ekim 2025, Erişim tarihi: 8 Ekim 2026. https://dropbox.tech/machine-learning/halfquadratic-quantization-of-large-machine-learning-models
[9]
E. Frantar, S. Ashkboos, T. Hoefler ve D. Alistarh, “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” arXiv 2023, 4-7, Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2210.17323
[10]
J. Lin, J. Tang, H. Tang, S. Yang, W. Chen, vd., “AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,” arXiv 2023, 10, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2306.00978
[11]
ggml-org, “llama.cpp: LLM Inference in C/C++.”
[12]
S. Ashkboos, A. Mohtashami, M. L. Croci, B. Li, P. Cameron, vd., “QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs,” arXiv 2024, 4, Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/2404.00456; Z. Liu, C. Zhao, I. Fedorov, B. Soran, D. Choudhary, vd., “SpinQuant: LLM Quantization with Learned Rotations,” arXiv 2025, 5, Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/2405.16406
[13]
A. Petrov, E. La Malfa, P. H. S. Torr ve A. Bibi, “Language Model Tokenizers Introduce Unfairness Between Languages,” arXiv 2023, 10, Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2305.15425
[14]
K. Marchisio, S. Dash, H. Chen, D. Aumiller, A. Üstün, vd., “How Does Quantization Affect Multilingual LLMs?” arXiv 2024, 2, Erişim tarihi: 12 Ekim 2026. https://arxiv.org/abs/2407.03211
[15]
E. Frantar, vd., “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” 4-7.
[16]
A. Yang, A. Li, B. Yang, B. Zhang, B. Hui, vd., “Qwen3 Technical Report,” arXiv 2025, 6, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2505.09388
[17]
Red Hat AI ve vLLM Project, "LLM Compressor."
[18]
ggml-org, “llama.cpp: LLM Inference in C/C++.”
[19]
Turkish NLP Suite, “BellaTurca,” Erişim tarihi: 5 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/BellaTurca
[20]
C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, vd., “Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer,” arXiv 2023, 8-10, Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/1910.10683
[21]
L. Bandarkar, D. Liang, B. Muller, M. Artexte, S. N. Shukla, vd., “The Belebele Benchmark: a Parallel Reading Comprehension Dataset in 122 Language Variants,” arXiv 2023, 3-4, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2308.16884
[22]
malhajar, “arc-tr-v0.2,” Hugging Face, Erişim tarihi: 8 Ekim 2026. https://huggingface.co/datasets/malhajar/arc-tr-v0.2; P. Clark, I. Cowhey, O. Etzioni, T. Khot, A. Sabharwal, vd., “Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge,” arXiv 2018, 10, Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/1803.05457
[23]
EleutherAI, “Language Model Evaluation Harness,” GitHub, Erişim tarihi: 13 Ekim 2026. https://github.com/EleutherAI/lm-evaluation-harness
[24]
A. Dutta, S. Krishnan, N. Kwatra ve R. Ramjee, “Accuracy is Not All You Need,” arXiv 2024, 6-8, 10-11, Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2407.09141
[25]
Turkish NLP Suite, “BellaTurca.”
[26]
E. Frantar, vd., “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” 4-7.
[27]
Open Language Data Initiative, “FLORES+,” Hugging Face, Erişim tarihi: 3 Ekim 2026. https://huggingface.co/datasets/openlanguagedata/flores_plus
[28]
W. Kwon, vd., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” 1-3.
[29]
T. Dettmers ve L. Zettlemoyer, “The case for 4-bit precision: k-bit Inference Scaling Laws,” arXiv 2022, 3-4, 8. Erişim tarihi: 4 Ekim 2026. https://arxiv.org/abs/2212.09720
[30]
E. Kurtic, vd., “‘Give Me BF16 or Give Me Death’? Accuracy-Performance Trade-Offs in LLM Quantization,” 1.
[31]
T. Dettmers, T. ve L. Zettlemoyer, “The case for 4-bit precision: k-bit Inference Scaling Laws,” 3-4, 8.

Kuantizasyon Kararından Sonra: Yöntem, Bit ve Veri Seçimi
Hangi Kuantizasyon Ne Zaman Seçilmelidir?
Model Nerede Çalışacak?
Kaç Kişiye Hizmet Verecek?
Ne Kadar Sıkıştırmaya İhtiyaç Var?
Kalibrasyon İçin Veri ve Zaman Var mı?
Kalibrasyon Verisinin Dili Neden Önemli?
Derine İn: GPTQ Hatayı Nasıl Telafi Eder?
Kalibrasyon, Bellek Bütçesi ve Hız Üzerine Üç Deney
Deneylerde Kullanılan Modeller, Kuantlar ve Ölçütler
Derine İn: Kurulum Ayrıntıları
Türkçe Kalibrasyon Farkı Kapatır Mı?
Aynı Bellekte Büyük ve Sıkıştırılmış Mı, Küçük ve Tam Mı?
Kuantizasyon Decode Hızını Ne Kadar Artırır?
Tartışma ve Sınırlar
Sık Sorulan Sorular
Kuantize Bir Model Daha Yavaş Olabilir Mi?
4 bitlik Büyük Model Mi, 16 bitlik Küçük Model Mi?
Hazır Bir Kuantı İndirirken Neye Bakılmalıdır?
Yöntem Seçiminde Kalibrasyonun, Belleğin ve Hızın Rolü