
Osmanlı döneminden kalan kitaplar, gazeteler ve dergiler, Türkçenin yazılı tarihinin anlaşılması açısından değerli kaynaklardır. Bu belgelerin büyük bölümü günümüzde taranmış görüntüler hâlinde saklanmaktadır. Tarihî ve kültürel değerlerinden yararlanılabilmesi için içeriklerinin metne dönüştürülmesi gerekmektedir. Bu işlem optik karakter tanıma (Optical Character Recognition, OCR) ile gerçekleştirilir. Taranmış sayfadaki yazı otomatik olarak dijital ortama aktarılabilir. Böylece binlerce sayfa içinde dakikalar içinde arama yapılabilir, büyük arşivler elle yazıya aktarılmadan işlenebilir ve Türkçenin tarihî dönemlerine ait dil kaynakları oluşturulabilir. Osmanlıca arşivlerde de bu olanaklardan yararlanılabilmesi için güvenilir OCR sistemlerinin geliştirilmesi gerekmektedir.
Osmanlı Dönemine Ait El Yazması Belgeler (Yapay Zeka ile Oluşturulmuştur.)
Bu yazıda önce Osmanlıca OCR’ın temel güçlükleri ve alandaki yaklaşımlar ele alınmaktadır. Ardından veri kaynaklarının satır düzeyinde kullanıma hazırlanması, hazır OCR sistemlerinin ortak bir test kümesinde incelenmesi ve tokenizer seçeneklerinin karşılaştırılması sunulmaktadır.
Osmanlıca, Türkçenin Arap alfabesiyle yazılmış biçimidir. Bu nedenle Latin alfabesi için geliştirilmiş OCR araçları doğrudan kullanılamaz. Harflerin çoğu birbirine bağlanır ve aynı harf, sözcük içindeki konumuna göre farklı biçimlerde yazılır. Dolayısıyla karakter sınırlarının ayrılmasına dayanan klasik yöntemlerle güvenilir sonuç almak güçtür. Birbirine benzeyen harfler küçük noktalarla ayırt edilir, ancak bu noktalar düşük baskı kalitesi veya düşük tarama çözünürlüğü nedeniyle kolayca kaybolabilir. Kısa ünlüler çoğunlukla yazıda gösterilmediği için aynı yazım birden fazla biçimde okunabilir. Bu nedenle Arap harfli metinden Latin harfli Türkçeye geçiş, birebir harf dönüşümü olarak değerlendirilemez. Metinlerde Türkçe, Arapça ve Farsça kökenli sözcüklerin birlikte kullanılması nedeniyle dil modelleme süreci de güçleşmektedir.
Bunlara ek olarak etiketlenmiş Osmanlıca veri azdır. Bu sorun, özellikle el yazısı metinlerde daha belirgin hâle gelmektedir; çünkü yazıların görünümü yazar, dönem ve kâtiplerin yazım üsluplarına bağlı olarak önemli ölçüde farklılık göstermektedir. Literatürdeki çalışmalar hem matbu metin hem de el yazısı tanıma (Handwritten Text Recognition, HTR) üzerinedir. Matbu Osmanlıca metinler, daha düzenli ve standart bir yazı yapısına sahip olmaları nedeniyle el yazısı metinlere kıyasla OCR açısından daha az zorluk içermektedir. Bununla birlikte, bu çalışmada hem matbu hem de el yazısı Osmanlıca metinlerin işlenmesine yönelik yöntemler ele alınmaktadır.
Osmanlıca metin tanıma literatüründe farklı görevler ve çıktı biçimleri ele alınmaktadır. Bazı çalışmalar matbu metinlere odaklanırken bazıları el yazısı metinlerin tanınmasını amaçlamaktadır. Benzer şekilde, elde edilen çıktılar da Arap harfli metin veya çağdaş Türkçe transkripsiyon şeklinde farklılık göstermektedir. Bu farklılıklar, kullanılan yöntemleri ve değerlendirme sonuçlarını doğrudan etkilemektedir. Bu bölümde, ilgili çalışmalar ele aldıkları görevler ve kullandıkları yöntemler doğrultusunda özetlenmektedir.
Kirmizialtin ve Wrisley, 20. yüzyılın başlarında yayımlanan iki Osmanlıca süreli yayın üzerinde otomatik metin tanıma çalışması gerçekleştirmiştir.Çalışmada, Transkribus platformu kullanılarak HTR modelleri eğitilmiş ve Arap harfli Osmanlıca metinlerin doğrudan Latin harfli Türkçe transkripsiyonlarının elde edilmesi amaçlanmıştır. Bu süreçte, Arap ve Latin alfabeleri arasında birebir harf eşleştirmesinin bulunmaması, metinlerin okunuşuna ilişkin belirsizlikler ve farklı yayınların yazı özelliklerinden kaynaklanan değişkenlikler ele alınmıştır. Çalışma, Osmanlıca metinlerin Latin harflerine aktarılmasında yalnızca karakter tanımanın değil, dilsel özelliklerin de önemli olduğunu ortaya koymaktadır.【1】
Bilgin Taşdemir ve çalışma arkadaşları, matbu Osmanlıca belgelerin doğrudan Latin harfli Türkçe transkripsiyonlarını üretmek amacıyla evrişimli sinir ağı ve çift yönlü uzun kısa süreli bellek tabanlı (Convolutional Neural Network–Bidirectional Long Short-Term Memory, CNN-BiLSTM) bir model geliştirmiştir. Modelin eğitiminde bağlantıcı zamansal sınıflandırma (Connectionist Temporal Classification, CTC) yöntemi kullanılmıştır. Geleneksel olarak Arap harfli metnin tanınması ve ardından Latin harflerine dönüştürülmesi şeklinde gerçekleştirilebilen iki aşamalı süreç yerine, belge görüntüsünden doğrudan Latin harfli çıktı üreten uçtan uca bir yaklaşım benimsenmiştir. Ayrıca modelin ürettiği metinlerin doğruluğunu artırmak amacıyla sözlük destekli Word Beam Search yöntemi değerlendirilmiştir. Bu yaklaşımda model, Osmanlıca yazımında açıkça gösterilmeyen ünlü harflerin transkripsiyon sırasında tamamlanmasını da öğrenmektedir.【2】
Dölek ve Kurt, nesih hattıyla basılmış Osmanlıca belgelerin otomatik olarak tanınmasına yönelik CNN ve çift yönlü LSTM katmanlarından oluşan bir OCR modeli geliştirmiştir. Çalışmada, eğitim verisinin model başarısına etkisini incelemek amacıyla gerçek belge görüntülerinden, sentetik örneklerden ve bu iki veri türünün birleşiminden oluşan farklı eğitim kümeleri kullanılmıştır. Geliştirilen sistem, diğer OCR araçlarıyla aynı test kümesi üzerinde karşılaştırılarak değerlendirilmiştir. Ayrıca tanıma sonuçları ham, normalize edilmiş ve boşlukları kaldırılmış metin biçimlerinde ayrı ayrı incelenmiştir. Böylece hem farklı eğitim verilerinin hem de metin normalizasyonunun değerlendirme sonuçları üzerindeki etkisi ele alınmıştır. 【3】
Osmanlıca metin tanıma çalışmalarında karşılaşılan önemli sorunlardan biri, farklı yazı biçimlerini kapsayan yeterli miktarda etiketli veriye ulaşmanın güçlüğüdür. Osmanlıcanın Arap harfli bir yazı sistemi kullanması, benzer alfabelere sahip diller üzerinde geliştirilen metin tanıma yaklaşımlarının değerlendirilmesini önemli hâle getirmektedir. Bu kapsamda, Arapça, Urduca ve Farsça gibi diller arasında gerçekleştirilen bilgi aktarımı çalışmaları, Osmanlıca metin tanıma sistemleri açısından da yararlanılabilecek yöntemler sunmaktadır.
Al-azzawi ve çalışma arkadaşları; Arapça, Urduca ve Farsça el yazısı metinlerin tanınmasında diller arası bilgi aktarımının etkisini incelemiştir. Çalışmada, evrişimli yinelemeli sinir ağı (Convolutional Recurrent Neural Network, CRNN) ve Transformer tabanlı HTR-VT mimarileri kullanılarak farklı dillerden elde edilen verilerle ortak eğitim gerçekleştirilmiştir.【4】Hedef dildeki etiketli veri miktarı değiştirilerek diğer Arap harfli dillerden sağlanan verilerin tanıma başarısına katkısı değerlendirilmiştir. Elde edilen sonuçlar, ortak karakterlerin bulunduğu diller arasında bilgi aktarımının özellikle sınırlı eğitim verisi koşullarında fayda sağlayabildiğini göstermiştir. Bununla birlikte, başarı artışının kullanılan model mimarisine, hedef dildeki veri miktarına ve diller arasındaki karakter benzerliğine bağlı olarak değiştiği belirlenmiştir.【5】
TrOCR (Transformer-based Optical Character Recognition), görüntüden doğrudan metin üretmek amacıyla geliştirilen Transformer tabanlı bir OCR mimarisidir.【6】 Model, görsel özellikleri çıkarmak için bir görüntü kodlayıcısı (encoder) ve bu özelliklerden metin dizisi oluşturmak için bir Transformer çözücüsü (decoder) kullanmaktadır. Eğitim sürecinde büyük ölçekli sentetik verilerden yararlanılmakta, ardından gerçek metin görüntüleri üzerinde ince ayar yapılmaktadır. Başlangıçta ağırlıklı olarak İngilizce metin tanıma görevleri için geliştirilen modelin Arap harfli dillere uyarlanmasında, kullanılan tokenizer'ın hedef dilin karakterlerini ve yazı özelliklerini desteklemesi önem taşımaktadır.【7】
Chan ve çalışma arkadaşları, TrOCR mimarisini temel alan HATFormer modelini tarihî Arapça el yazısı metinlerin tanınmasına uyarlamıştır. Çalışmada, tarihî belgelerdeki yazı biçimlerini daha iyi işleyebilmek amacıyla görüntü ön işleme yöntemleri ve modelin eğitim süreci özelleştirilmiştir. Ayrıca Arapça karakterlerin temsilini iyileştirmek için bayt düzeyinde alt sözcük birimlerine dayanan BBPE (Byte-level Byte Pair Encoding) tokenizer kullanılmıştır. Modelin eğitimi sentetik Arapça metin görüntüleriyle desteklenmiş ve ardından gerçek tarihî el yazısı verileri üzerinde ince ayar gerçekleştirilmiştir. Bu yaklaşım, önceden eğitilmiş Transformer modellerinin tarihî Arapça belgelere uyarlanmasına yönelik bir örnek sunmaktadır.【8】
Momeni ve BabaAli, Arapça el yazısı metinlerin tanınması için Transformer tabanlı iki farklı mimariyi karşılaştırmıştır. Çalışmada, görüntü kodlayıcısı ve metin çözücüsünde önceden eğitilmiş modellerden yararlanılmış, Arapça dil bilgisi içeren BERT tabanlı bir model metin üretim bileşenine uyarlanmıştır. Eğitim sürecinde sentetik veriler kullanılmış ve model KHATT el yazısı veri kümesi üzerinde değerlendirilmiştir. Standart kodlayıcı-çözücü Transformer ile Transformer Transducer mimarilerinin karşılaştırılması sonucunda, Transducer modelinin işlem hızı açısından avantaj sağladığı, standart Transformer mimarisinin ise daha düşük karakter hata oranına ulaştığı raporlanmıştır.【9】
Bu çalışmalar, Transformer tabanlı metin tanıma modellerinin farklı bileşenler ve eğitim stratejileriyle Arapça belgelere uyarlanabildiğini göstermektedir. TrOCR genel amaçlı bir kodlayıcı-çözücü mimarisi sunarken【10】 HATFormer, bu yaklaşımın tarihî Arapça el yazısına uyarlanmasına odaklanmaktadır.【11】 Momeni ve BabaAli farklı Transformer mimarilerini karşılaştırmış,【12】 Qalam ise SwinV2 görüntü kodlayıcısını RoBERTa tabanlı bir çözücüyle birleştirmiştir.【13】 Çalışmalarda ortak olarak öne çıkan noktalar, hedef dile uygun metin temsillerinin kullanılması, sentetik verilerle eğitimin desteklenmesi ve sınırlı gerçek veriyle model uyarlamasının gerçekleştirilmesidir.
Transformer tabanlı OCR modellerinin yanı sıra, farklı dillerdeki ve belge türlerindeki metinlerin tanınması için büyük görsel-dil modellerinden de yararlanılmaktadır. Belirli bir dile veya yazı sistemine odaklanan modellerden farklı olarak bu yaklaşımlar, daha geniş veri kümeleri üzerinde eğitilerek farklı tarihî belgelerin işlenmesini amaçlamaktadır. Bu doğrultuda geliştirilen CHURRO, Qwen2.5-VL tabanlı ve 3 milyar parametreye sahip açık ağırlıklı bir görsel-dil modelidir. Modelin eğitiminde farklı dönemlere, dillere ve yazı sistemlerine ait matbu ve el yazısı belgelerden oluşturulan geniş kapsamlı CHURRO-DS veri kümesi kullanılmıştır. Çalışmada, tarihî belgelerde karşılaşılan farklı yazı stilleri, belge düzenleri ve fiziksel bozulmaların metin tanıma üzerindeki etkileri ele alınmıştır. Modelin başarısı hem matbu hem de el yazısı belgeler üzerinde değerlendirilmiş ve farklı OCR sistemleri ile görsel-dil modellerinin sonuçlarıyla karşılaştırılmıştır. Bu çalışma, tarihî belgelere özgü verilerle eğitilen görsel-dil modellerinin metin tanıma alanında kullanılmasına yönelik önemli bir örnek sunmaktadır.【14】
Qalam, Arapça matbu ve el yazısı metinlerin tanınması amacıyla geliştirilmiş Transformer tabanlı bir OCR modelidir.【15】 Modelde, görüntü özelliklerinin çıkarılması için SwinV2 görüntü kodlayıcısı ve metin dizilerinin oluşturulması için RoBERTa tabanlı bir çözücü kullanılmıştır. Eğitim sürecinde geniş kapsamlı Arapça el yazması koleksiyonlarından ve sentetik olarak oluşturulmuş görüntü-metin çiftlerinden yararlanılmıştır. G. Bhatia ve arkadaşlarının çalışmasında, farklı yazı stillerinin ve Arapça karakterlerin yapısal özelliklerinin metin tanıma üzerindeki etkileri ele alınmıştır. Bu yaklaşım, önceden eğitilmiş Transformer mimarilerinin Arapça metin tanıma görevlerine uyarlanması ve sentetik verilerle desteklenmesi açısından önemli bir örnek sunmaktadır.【16】
İncelenen çalışmalar, Osmanlıca metin tanıma alanında karşılaşılan zorlukların yalnızca kullanılan model mimarisinden kaynaklanmadığını, belge türü, yazı özellikleri ve hedeflenen çıktı biçiminin de önemli bir rol oynadığını göstermektedir.【17】 Matbu metinler daha düzenli bir yazı yapısına sahipken el yazısı belgelerde karakterlerin biçimi yazar, dönem ve kâtip üslubuna göre önemli ölçüde değişebilmektedir. Ayrıca Arap harfli metnin doğrudan tanınması ile Latin harfli transkripsiyon üretilmesi farklı problemleri beraberinde getirmektedir.【18】 Özellikle Latin harfli transkripsiyon üretiminde, karakterlerin tanınmasının yanı sıra Osmanlıcanın dilsel özelliklerinin ve yazım farklılıklarının da dikkate alınması gerekmektedir.
Literatürde kullanılan yöntemler incelendiğinde, CNN ve LSTM tabanlı mimarilerden,【19】 Transformer tabanlı modellere【20】 ve büyük görsel-dil modellerine【21】 kadar farklı yaklaşımların değerlendirildiği görülmektedir. Bu çalışmaların ortak noktalarından biri, model başarısının yalnızca mimari seçimine değil, eğitim verisinin niteliğine ve çeşitliliğine de bağlı olmasıdır. Özellikle sentetik verilerin kullanılması, sınırlı miktarda etiketli tarihî belgeye sahip olunduğunda eğitim verisinin genişletilmesine olanak sağlamaktadır. Bununla birlikte, sentetik verilerin gerçek belgelerde karşılaşılan yazı farklılıklarını ve fiziksel bozulmaları ne ölçüde temsil ettiği de modelin genelleme başarısı açısından önem taşımaktadır.【22】
Arapça, Farsça ve Urduca gibi benzer yazı sistemlerine sahip diller üzerinde gerçekleştirilen çalışmalar, önceden eğitilmiş modellerden ve diller arası bilgi aktarımından yararlanılabileceğini göstermektedir.【23】Ancak ortak karakterlerin bulunması, bu dillerde elde edilen başarıların Osmanlıca için de aynı düzeyde gerçekleşeceği anlamına gelmemektedir. Diller arasındaki yazım kuralları, karakter kullanımı ve tarihî metinlerin özellikleri farklılık gösterebildiğinden, bu yaklaşımların Osmanlıca veri kümeleri üzerinde ayrıca değerlendirilmesi gerekmektedir.【24】
Genel olarak değerlendirildiğinde, Osmanlıca metin tanıma sistemlerinin geliştirilmesinde farklı mimarilerin karşılaştırılması kadar, çeşitli yazı stillerini ve belge türlerini kapsayan eğitim verilerinin oluşturulması da önem taşımaktadır.【25】 Özellikle gerçek ve sentetik verilerin birlikte kullanılması,【26】benzer yazı sistemlerinden bilgi aktarılması【27】 ve önceden eğitilmiş modellerin Osmanlıca belgelere uyarlanması,【28】 bu alanda değerlendirilmesi gereken yaklaşımlar olarak öne çıkmaktadır.
Bir OCR modeli açısından veri, yalnızca çok sayıda taranmış sayfadan ibaret değildir. Her görüntünün doğru metinle eşleştirilmesi, sayfa içindeki satır sınırlarının güvenilir biçimde çıkarılması, farklı kaynakların ortak bir dizin yapısında birleştirilmesi ve değerlendirme verisinin eğitimden ayrılması gerekmektedir. Osmanlıca söz konusu olduğunda buna bir de alfabe sorunu eklenmektedir: modern Arapça için hazırlanmış bir tokenizer tarafından Arap harfli Osmanlı Türkçesi otomatik olarak iyi temsil edilemeyebilmektedir.
Veri havuzunun ana kaynaklarından OpenITI Makhzan’da Arapça, Osmanlı Türkçesi, Farsça, Urduca ve Malayca metinlerin yanı sıra Arapça-Cava, Arapça-Farsça ve Osmanlıca-Farsça gibi birden fazla dil içeren belgeler sunulmaktadır.【29】 OpenITI PRINT koleksiyonunda ise Arapça, Osmanlı Türkçesi, Farsça ve Urduca matbu örneklere yer verilmektedir.【30】 Osmanlıca için bu kaynaklara osmanlica.com verisi【31】 de eklenmiştir. Diğer Arapça kaynaklar KHATT, Muharaf, RASAM, TariMa ve HICMA olarak belirlenmiş;【32】 bu koleksiyonlar aracılığıyla veri havuzuna farklı Arapça metin ve baskı örnekleri katılmıştır. Osmanlıca etiketli verinin sınırlı olması nedeniyle Arapça, Farsça ve Urduca örneklerden de yararlanılmıştır. Paylaşılan Arap harfleri sayesinde modelin daha geniş bir yazı ve baskı çeşitliliğiyle karşılaşması sağlanmıştır. Karma belgeler ise tek bir dile zorlanmak yerine içerdikleri dillere göre tanımlanmıştır.
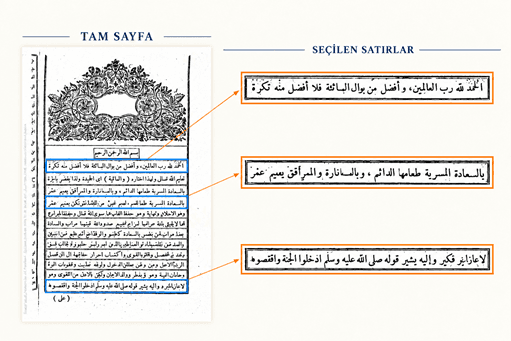
Veri Hazırlama Sürecinden Seçilmiş Satır Örnekleri (Yapay Zeka ile Oluşturulmuştur.)
Kaynakların bir bölümünde tek tek satırlar yerine sayfa görüntüleri ve sayfa düzeninin açıklandığı genişletilebilir işaretleme dili (Extensible Markup Language, XML) dosyaları yer almaktaydı. OCR modelinin eğitilebilmesi için her satırın görüntüsüyle metninin eşleştirilmesi gerektiğinden, XML’deki satır koordinatları kullanılarak sayfa görüntüsünden kırpım alınmış; satır metni de XML’den çıkarılmıştır. Böylece her satır, aynı adı taşıyan bir görüntü ve metin dosyasına dönüştürülmüştür.
Kaynakların XML yapılarında da farklılıklar bulunmaktaydı. Örneğin bir veri kümesinde satır sınırı dikdörtgen koordinatları yerine poligon noktalarıyla verilebilmektedir. Bu durumda noktaları kapsayan dikdörtgen hesaplanmış ve metin Unicode alanından çıkarılmıştır. Bu işlemlerin ardından farklı kaynakların ortak bir satır görüntüsü ve metin biçiminde kullanılabilmesi sağlanmıştır.
Veri hazırlama sürecinin ardından aşağıdaki dağılım elde edilmiştir. Tablo 1’deki sayılar, eğitim havuzundaki ve test kümesindeki (benchmark) satır-görüntü çiftlerinin sayısını göstermektedir.
Tablo 1: Dillere Göre Eğitim Havuzu ve Test Kümesi Satır-Görüntü Çifti Sayıları
Bu çalışmada test kümesi oluşturulurken kaynak bazlı orantılı örnekleme (proportional stratified sampling) yaklaşımından yararlanılmıştır. Öncelikle her dil için hedef test kümesi örnek sayısı belirlenmiştir. Ardından bu sayı, ilgili dilin veri kaynaklarının büyüklükleriyle orantılı biçimde dağıtılmıştır. Örneğin bir dile ait verilerin %70’inin bir kaynaktan, %30’unun başka bir kaynaktan gelmesi durumunda, test kümesi örneklerinde de yaklaşık olarak aynı oranların korunması hedeflenmiştir. Böylece ilgili dilin mevcut kaynak dağılımının test kümesinde temsil edilmesi sağlanmıştır. Bu yöntemle test kümesi sonuçlarının tek bir veri kaynağının özelliklerine aşırı bağımlı olmasının azaltılması amaçlanmıştır. Bununla birlikte kaynak oranlarının korunması, test kümesinde tüm yazı tiplerinin, görüntü kalitelerinin veya belge çeşitlerinin eşit düzeyde kapsandığı anlamına gelmemektedir.
Eğitim deneylerinden önce hazır OCR sistemleri aynı test kümesi üzerinde çalıştırılmıştır. Burada amaç, modelleri eğitilecek bir modelle karşılaştırmak değil, herhangi bir Osmanlıca ince ayar uygulanmadan önce genel amaçlı ve farklı alfabelerde eğitilmiş sistemlerin başlangıç noktasının görülmesidir. Böylece sonraki eğitim deneyleri için bir karşılaştırma tabanı oluşturulmuştur.
Test kümesi, dört dilde toplam 1.569 satır-görüntü çiftinden oluşturulmuştur. Osmanlıca bölümünde OpenITI Makhzan’dan 161,【33】 OpenITI PRINT’ten 214【34】 ve osmanlica.com’dan 87; Arapça bölümünde 656, Farsça bölümünde 233 ve Urduca bölümünde 218 örnek bulunmaktadır.【35】 Model çıktıları karakter hata oranı (Character Error Rate, CER) ile karşılaştırılmıştır. Tablo 2’deki CER değerleri için standart sapma, güven aralığı veya örneklem dağılımı belirtilmemiştir. Tablo 2’de hem dil bazındaki ortalamalara hem de dört dilin tamamını kapsayan genel ortalamaya yer verilmiştir. Genel ortalama, dillerin satır sayılarıyla ağırlıklandırılarak hesaplanmıştır. CER düştükçe referans metne daha çok yaklaşıldığı kabul edilmektedir. Değer 1’i geçtiğinde ekleme, silme ve değiştirme hatalarının toplamıyla referans uzunluğu aşılabileceğinden, oranın yüzde olarak okunmaması gerekmektedir.
Tablo 2: Hazır OCR Sistemlerinin Dil Bazında Karakter Hata Oranı (CER) Değerleri
Surya OCR 2, dört dilin tamamında en düşük CER değerini vermiş ve 0,3728’lik genel ortalamasıyla ilk sırada yer almıştır; Arapçada Surya 0,5071, Kraken ise 0,6013 değerini almıştır. Kraken ile dört dilde 0,3726–0,6225 aralığında CER elde edilmiştir (genel CER 0,5266). EasyOCR’ın dil ortalamaları 0,5285–0,6351 aralığında kalırken OCR Verse için Osmanlıca (0,6297) ve Urduca (0,6525) CER değerleri, Arapça (0,9751) ve Farsça (0,7284) değerlerinden daha düşüktür. Tablo 2, yalnızca Osmanlıca sıralamasına bakıldığında Arap harfli metinlerdeki genel başarı hakkında eksik bir görünüm elde edilebileceğini göstermektedir.
Modeller arasında farklı dil profilleri bulunduğu görülmüştür. Tesseract için Farsça ortalaması 0,4657, Osmanlıca ortalaması ise 0,9388 olarak ölçülmüştür. PaddleOCR-VL ile Osmanlıcada 0,4691 gibi düşük bir CER elde edilmesine karşın Farsça CER 1,7269 olarak ölçülmüştür. CHURRO’nun Arapça, Farsça ve Urduca sonuçları 0,84–1,07 aralığında ölçülürken Osmanlıca CER 4,0477 olarak belirlenmiştir. MonkeyOCRv2-B ile de Osmanlıcada 1,5944, Farsçada 16,1152 elde edilmiştir. Bu farklılıklar, ortak alfabe kullanılmasının tek başına aynı OCR başarısını sağlamadığını düşündürmektedir; modelin dil dağılımı ile kaynakların görsel özelliklerinin etkisi bu deneyde ayrıca sınanmamıştır.
Bazı genel amaçlı görsel-dil modellerinde dört dilin tamamı için yüksek hata oranları elde edilmiştir. Genel CER, GLM OCR için 13,1636, DeepSeek OCR 2 için 20,5732 ve Ovis OCR2 için 4,2361 olarak ölçülmüştür. Bu sonuçlar, modellerin Osmanlıca test kümesindeki başarısının yanı sıra diğer Arap harfli dillerdeki performanslarının da karşılaştırılmasına olanak tanımaktadır.
Dil ortalamaları kullanıldığında kaynaklar arasındaki değişkenlik gizlenebilir. Örneğin HunyuanOCR ile Osmanlıca OpenITI Makhzan ve OpenITI PRINT üzerinde sırasıyla 0,5454 ve 0,5192 CER elde edilirken osmanlica.com üzerindeki CER değeri 2,9996’ya yükselmiştir. OCR Verse için bu değerler 0,6267, 0,3771 ve 1,2567 olarak ölçülmüştür. Dolayısıyla dil başına tek bir skor kullanılarak belirli bir arşiv veya baskı türündeki performansın açıklanması yeterli değildir.
Bu nedenle Tablo 2, nihai bir model sıralaması olarak değil, aynı veri kümesi üzerinde yapılan ilk karşılaştırma olarak okunmalıdır. Modeller kendi doğal çözünürlükleri ve ön işleme akışlarıyla çalıştırılmıştır; istem biçimleri ile çıktı normalizasyonları ise sistemden sisteme değiştirilebilir. CER hesabı yazım normalizasyonuna duyarlıdır: Osmanlıca metinlerdeki hareke, boşluk, noktalama veya Unicode karakter biçimi farklılıkları, OCR çıktısı doğruya yakın olsa bile hata olarak değerlendirilebilir. Ayrıca her satıra ait CER değerlerinin ortalaması raporlanmıştır. Kaynak büyüklükleri eşit olmadığından, her kaynaktaki performans genel ortalamada aynı ölçüde temsil edilmemektedir.
TrOCR türü bir model iki ana bileşenden oluşmaktadır: satır görüntüsü, görüntü kodlayıcısı tarafından görsel temsillere dönüştürülmekte; çıktı ise metin çözücüsü tarafından adım adım üretilmektedir. Çözücüde doğrudan karakterlerle değil, tokenizer tarafından tanımlanan token’larla (metni oluşturan alt birimler) çalışılmaktadır. Bu nedenle tokenizer seçimi yalnızca bir ön işleme tercihi olarak görülemez; modelin çıktı uzayının, dizi uzunluğunun, bellek tüketiminin ve hangi karakterlerin kayıpsız üretilebileceğinin belirlendiği mimari bir karar olarak değerlendirilmelidir.【50】
Örneğin Osmanlıcada sık kullanılan bir harf tokenizer tarafından [UNK] (bilinmeyen token) olarak görülüyorsa çözücüye o karakterler arasındaki ayrım öğretilemez. Öte yandan metin, her karakteri ayrı bir token’a, hatta bazı karakterleri birden fazla bayt token’ına bölen bir tokenizer ile kayıpsız taşınsa bile çok uzun çıktı dizileri üretilebilir. Bu durumda eğitim yavaşlar ve sabit maksimum uzunluk nedeniyle kesilen satırların sayısı artar. Seçim yalnızca sözlük büyüklüğüne bakılarak yapılmamıştır.
Altı tokenizer aşağıdaki ölçütlere göre karşılaştırılmıştır:
Karşılaştırmaya RoBERTa (roberta-base; ilk TrOCR’ın çözücü tokenizer'ı), XLM-RoBERTa (çok dilli RoBERTa), AraBERT v2 (Arapça için BERT modeli), mT5, CAMeLBERT (Arapça BERT modeli) ve mBART-50 (50 dil için çok dilli BART) dâhil edilmiştir. Örnekleme sırasında Osmanlı Türkçesi, Malayca ve çok dilli kümelerin tamamı kullanılmış; her Arapça veri kümesinden en fazla 140, her Farsça ve Urduca veri kümesinden ise en fazla 250 satır seçilmiştir.
Osmanlı Türkçesi için en ayırt edici sonuçlar Tablo 3’te özetlenmiştir. Aralıklar, üç Osmanlıca veri kaynağında gözlenen değerleri göstermektedir:
Tablo 3: Altı Tokenizer'ın Üç Osmanlıca Veri Kaynağı Üzerindeki Aralıklı Sonuçları
İlk dikkat çeken sonuç, “Arapça için eğitilmiş” olmanın Osmanlıca için yeterli olmadığıdır. AraBERT ile test edilen altı Osmanlıca karakterin tamamı [UNK] ile temsil edilmiştir. Veri kaynağına göre Osmanlıca satırların %45,7 ile %97,39’unda [UNK] oluşmuş ve gidiş-dönüş CER değeri %48’e kadar yükselmiştir. CAMeLBERT ile yapılan tek karakter testinde altı harfin tamamı kapsanmış olsa da gerçek satırlarda yine de [UNK] üretilmiştir. Dolayısıyla karakterlerin tek tek kapsanması, bağlam içinde güvenilir temsili tek başına garanti etmemektedir.
RoBERTa’nın bayt düzeyindeki yaklaşımı ise karşıt uçta yer almıştır. Bütün karakterler kayıpsız taşınmış, [UNK] üretilmemiş ve kodlama-çözme dönüşünde %100 doğruluk sağlanmıştır. Bunun karşılığında dizi uzunluğu artmıştır: Karakter başına yaklaşık 1,1 token üretilmiştir. Özellikle daha uzun satırlara sahip osmanlica.com verisinde medyan dizi uzunluğu 95, p90 değeri ise 147 token olarak ölçülmüş ve 128 token sınırında satırların %17,12’sinin kesileceği görülmüştür. Dolayısıyla yalnızca kayıpsızlığın yeterli olmadığı, verimli bir temsile de ihtiyaç duyulduğu belirlenmiştir.
XLM-RoBERTa ve mBART-50 ile kısa diziler üretilmiş; deneyde birbirine çok yakın, hatta aynı sonuçlar elde edilmiştir. Bununla birlikte bazı kaynaklarda az sayıda da olsa [UNK] gözlenmiştir.
Nihai eğitim betiklerinde çözücü olarak mT5, buna bağlı olarak da mT5 tokenizer seçilmiştir. Üç Osmanlıca kaynağında da mT5 ile sıfır [UNK] üretilmiş, altı kritik karakterin tamamı kapsanmış ve medyan token/karakter oranı 0,42–0,44 aralığına indirilmiştir. Başka bir ifadeyle aynı metnin, medyan token/karakter oranlarına göre RoBERTa’nın kullandığı token sayısının yaklaşık %40’ı kadar token kullanılarak temsil edilebildiği görülmüştür. Gidiş-dönüş birebir eşleşmesi %100 olmamasına karşın ortalama karakter hatası kaynağa göre yalnızca %0,067–0,80 aralığında kalmış ve 128 token sınırında hiçbir Osmanlıca satır kesilmemiştir. Böylece sıfır [UNK], kısa diziler ve hazır bir çok dilli üretici çözücü bir arada sağlanmıştır.
Osmanlıca OCR; yazı biçimi, tarihî dil özellikleri ve farklı çıktı hedefleri nedeniyle veri hazırlama, model ve tokenizer kararlarının birlikte ele alınmasını gerektirmektedir. Bu yazıda literatürdeki yaklaşımların yanı sıra satır verisinin hazırlanması, hazır OCR sistemlerinin değerlendirilmesi ve tokenizer seçeneklerinin incelenmesi ele alınmıştır. Çalışmalar, matbu metin ile el yazısının ayrı ihtiyaçlar taşıdığını ve model sonuçlarının kullanılan veri ile değerlendirme koşulları içinde yorumlanması gerektiğini göstermektedir.
Osmanlıca el yazısı tanıma, arşiv belgelerinin okunmasını ve araştırmalarda kullanılmasını kolaylaştırma potansiyeli taşıyan bir çalışma alanıdır. Bu nedenle Osmanlıca HTR için veri ve yöntem geliştirme çabalarının sürdürülmesi önemli bir araştırma yönü olarak öne çıkmaktadır.
Serinin devam yazısı olan “Matbu’dan Dijitale II: Osmanlıca OCR için Veri Üretimi ve Model Eğitimi” başlıklı çalışmada, bu sürecin teknik aşamaları, kullanılan yöntemler ve uygulama detayları kapsamlı bir şekilde ele alınacaktır.
Al-azzawi, S., E. Barney ve M. Liwicki. "Cross-Lingual Learning within Arabic Script for Low-Resource HTR." arXiv, 2026. Erişim tarihi 24 Ekim 2026. https://doi.org/10.48550/arXiv.2605.02089
Antoun, W., F. Baly ve H. Hajj. "AraBERT: Transformer-based Model for Arabic Language Understanding." Proceedings of the Fourth Workshop on Open-Source Arabic Corpora and Processing Tools (2020): 9–15. Erişim tarihi 24 Ekim 2026. https://aclanthology.org/2020.osact-1.2/
Bai, S., K. Chen, X. Liu, vd. "Qwen2.5-VL Technical Report." arXiv 2025. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2502.13923
Bhatia, G., E. M. B. Nagoudi, F. Alwajih ve M. Abdul-Mageed. "Qalam: A Multimodal LLM for Arabic Optical Character and Handwriting Recognition." arXiv, 2024. Erişim tarihi 24 Ekim 2026. https://doi.org/10.48550/arXiv.2407.13559
Bilgin Taşdemir, E. F., Z. Tandoğan, S. Doğan Akansu, vd. "Automatic Transcription of Ottoman Documents Using Deep Learning." Document Analysis Systems (2024): 422-435. Erişim tarihi 24 Ekim 2026. https://www.researchgate.net/publication/383922570_Automatic_Transcription_of_Ottoman_Documents_Using_Deep_Learning
Calfa. "RASAM Dataset: An Open Dataset for the Recognition and Analysis of Scripts in Arabic Maghrebi." GitHub. Erişim tarihi 24 Ekim 2026. https://github.com/calfa-co/rasam-dataset
Calfa. "TariMa: Ground-truth of the TariMa Project (HTR of Maghrebi Arabic Documents)." GitHub. Erişim tarihi 24 Ekim 2026. https://github.com/calfa-co/tarima
Chan, A., A. Mijar, M. Saeed, C.-W. Wong ve A. Khater. "HATFormer: Historic Handwritten Arabic Text Recognition with Transformers." arXiv, 2024. Erişim tarihi 24 Ekim 2026. https://doi.org/10.48550/arXiv.2410.02179
Conneau, A. K. Khandelwal, N. Goyal, vd. "Unsupervised Cross-lingual Representation Learning at Scale." Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics (2020): 8440–8451. Erişim tarihi 24 Ekim 2026. https://doi.org/10.18653/v1/2020.acl-main.747
Datalab Team. "Surya: A Lightweight Framework for Analyzing Documents and PDFs at Scale." GitHub. Erişim tarihi 24 Ekim 2026. https://github.com/datalab-to/surya
Duan, S., Y. Xue, W. Wang, vd. "GLM-OCR Technical Report." arXiv, 2026. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2603.10910
Dölek, İ. ve A. Kurt. "Derin Sinir Ağlarıyla Osmanlıca Optik Karakter Tanıma." Gazi Üniversitesi Mühendislik Mimarlık Fakültesi Dergisi 38 (4). (2023): 2579–2594. Erişim tarihi 24 Ekim 2026. https://doi.org/10.17341/gazimmfd.1062596
Graves, A., S. Fernandez, F. Gomez ve J. Schmidhuber. "Connectionist Temporal Classification: Labelling Unsegmented Sequence Data with Recurrent Neural Networks." ICML '06: Proceedings of the 23rd International Conference on Machine Learning (2006): 369–376. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1145/1143844.1143891
Inoue, G., B. Alhafni, N. Baimukan vd. "The Interplay of Variant, Size, and Task Type in Arabic Pre-trained Language Models." Proceedings of the Sixth Arabic Natural Language Processing Workshop, (2021): 92–104. Erişim tarihi 24 Ekim 2026. https://aclanthology.org/2021.wanlp-1.10/
Ismail, A., Z. Kamel ve R. Mahmoud. "HICMA: The Handwriting Identification for Calligraphy and Manuscripts in Arabic Dataset." Proceedings of the The First Arabic Natural Language Processing Conference (2023): 24-32. Erişim tarihi 24 Ekim 2026. https://www.semanticscholar.org/paper/HICMA%3A-The-Handwriting-Identification-for-and-in-Ismail-Kamel/a3040695744ca4c871d35d9993875b7d6fe6c9e8
Jaided AI. "EasyOCR: Ready-to-use OCR." GitHub. Erişim tarihi 23 Ekim 2026. https://github.com/JaidedAI/EasyOCR
Jaided AI. "EasyOCR: Ready-to-use OCR." GitHub. Erişim tarihi 24 Ekim 2026. https://github.com/JaidedAI/EasyOCR
Kiessling, B. "Kraken – A Universal Text Recognizer for the Humanities." Digital Humanities Conference 2019. Erişim tarihi 24 Ekim 2026. https://dh-abstracts.library.virginia.edu/works/9912
Kirmizialtin, S. ve D. J. Wrisley. "Automated Transcription of Non-Latin Script Periodicals: A Case Study in the Ottoman Turkish Print Archive." DHQ: Digital Humanities Quarterly 16 (2). (2022). Erişim tarihi 24 Ekim 2026. https://doi.org/10.63744/w8pr3b3ss2qa
Li G., X. Wan, S. Peng, vd. "HunyuanOCR-1.5: Making Lightweight OCR VLMs Faster and Better." arXiv, 2026. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2607.04884
Li, M., T. Lv, J. Chen, vd. "TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models." arXiv, 2021. Erişim tarihi 24 Ekim 2026. https://doi.org/10.48550/arXiv.2109.10282
Li, Y., D. Chen, T. Tang ve X. Shen. "HTR-VT: Handwritten Text Recognition with Vision Transformer." Pattern Recognition 158 (2025): 110967. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1016/j.patcog.2024.110967
Liu, Y., J. Gu, N. Goyal vd. "Multilingual Denoising Pre-training for Neural Machine Translation." Transactions of the Association for Computational Linguistics 8 (2020): 726–742. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1162/tacl_a_00343
Liu, Y., M. Ott, N. Goyal, vd. "RoBERTa: A Robustly Optimized BERT Pretraining Approach." arXiv, 2019. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/1907.11692
Liu, Y., Z. Li, Z. Zhang vd. "MonkeyOCRv2: A Visual-Text Foundation Model for Document AI." arXiv, 2026. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2607.11562
Liu, Z., H. Hu, Y. Lin, vd. "Swin Transformer V2: Scaling Up Capacity and Resolution." 2022 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). (2022): 11999–12009. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1109/CVPR52688.2022.01170
Lu, S., Y. Li, Y. Xia, vd. "OvisOCR2 Technical Report." arXiv, 2026. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2607.13639
Mahmoud, S. A., I. Ahmad, W. Al-Khatib, vd. "KHATT: Handwritten Arabic Text." Linguistic Data Consortium, 2015. Erişim tarihi 24 Ekim 2026. https://doi.org/10.35111/vc52-tm53
Momeni, S. ve B. BabaAli. "A Transformer-Based Approach for Arabic Offline Handwritten Text Recognition." Signal, Image and Video Processing 18 (2024): 3053–3062. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1007/s11760-023-02970-9
Muehlberger, G., L. Seaward, M. Terras, vd. "Transforming Scholarship in the Archives through Handwritten Text Recognition: Transkribus as a Case Study." Journal of Documentation 75 (5). (2019): 954–976. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1108/JD-07-2018-0114
OpenITI. "Arabic Print Data: Training Data for Arabic-script Print Transcription and Layout Analysis Models." GitHub. Erişim tarihi 24 Ekim 2026. https://github.com/OpenITI/arabic_print_data
Osmanlica.com. "Test Veri Kümeleri: Osmanlıca OCR ve Transliterasyon Kıyaslama Veri Kümeleri." Erişim tarihi 24 Ekim 2026. https://osmanlica.com/test
PaddlePaddle. "PaddleOCR-VL-1.6." PaddleOCR. 2026. Erişim tarihi 24 Ekim 2026. https://www.paddleocr.ai/main/version3.x/algorithm/PaddleOCR-VL/PaddleOCR-VL-1.6.html
Parkes Allen, J., J. Mullan, L. Nigst, vd. "OpenITI MAKHZAN: An Open Annotated Dataset of Arabic, Persian, Ottoman Turkish, and Urdu Print and Manuscript Data." Zenodo 2025. Erişim tarihi 24 Ekim 2026. https://doi.org/10.5281/zenodo.16410106
Rashad, M. "Arabic-Nougat: Fine-Tuning Vision Transformers for Arabic OCR and Markdown Extraction." arXiv, 2024. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2411.17835
Saeed, M., A. Chan, A. Mijar, vd. "Muharaf-public: Manuscripts of Handwritten Arabic Dataset for Cursive Text Recognition." Zenodo 2024. Erişim tarihi 24 Ekim 2026. https://doi.org/10.5281/zenodo.11492215
Scheidl, H., S. Fiel ve R. Sablatnig. "Word Beam Search: A Connectionist Temporal Classification Decoding Algorithm." 2018 16th International Conference on Frontiers in Handwriting Recognition. 2018. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1109/ICFHR-2018.2018.00052
Semnani, S. J., H. Zhang, X. He, M. Tekgürler ve M. S. Lam. "CHURRO: Making History Readable with an Open-Weight Large Vision-Language Model for High-Accuracy, Low-Cost Historical Text Recognition." arXiv, 2025. Erişim tarihi 24 Ekim 2026. https://doi.org/10.48550/arXiv.2509.19768
Smith, R. "An Overview of the Tesseract OCR Engine." Ninth International Conference on Document Analysis and Recognition (ICDAR 2007). (2007): 629–633. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1109/ICDAR.2007.4376991
Wasfy, A., A. Nacar, A. Elkhateb, vd. "QARI-OCR: High-Fidelity Arabic Text Recognition through Multimodal Large Language Model Adaptation." arXiv, 2025. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2506.02295
Wei, H., Y. Sun ve Y. Li. "DeepSeek-OCR 2: Visual Causal Flow." arXiv, 2026. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2601.20552
Xue, L., N. Constant, A. Roberts, vd. "mT5: A Massively Multilingual Pre-trained Text-to-Text Transformer." Proceedings of the 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies. (2021): 483–498. Erişim tarihi 24 Ekim 2026. https://doi.org/10.18653/v1/2021.naacl-main.41
Zhong, Y., L. Chen, X. Zhao, vd. "OCRVerse: Towards Holistic OCR in End-to-End Vision-Language Models." arXiv, 2026. Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2601.21639
[1]
Suphan Kirmizialtin ve David Joseph Wrisley, “Automated Transcription of Non-Latin Script Periodicals: A Case Study in the Ottoman Turkish Print Archive,” Digital Humanities Quarterly 16 (2), (2022), 6-11, Erişim tarihi: 24 Ekim 2026. https://doi.org/10.63744/w8pr3b3ss2qa
[2]
Esma F. Bilgin Taşdemir vd., “Automatic Transcription of Ottoman Documents Using Deep Learning,” Document Analysis Systems, (2024), 425–429, Erişim tarihi: 20 Ekim 2026. https://www.researchgate.net/publication/383922570_Automatic_Transcription_of_Ottoman_Documents_Using_Deep_Learning
[3]
İshak Dölek ve Atakan Kurt, “Derin Sinir Ağlarıyla Osmanlıca Optik Karakter Tanıma,” Gazi Üniversitesi Mühendislik Mimarlık Fakültesi Dergisi 38 (4), (2023), 2587–2590, Erişim tarihi: 19 Ekim 2026. https://dergipark.org.tr/tr/pub/gazimmfd/article/1062596
[4]
Sana Al-azzawi, Elisa Barney ve Marcus Liwicki, “Cross-Lingual Learning within Arabic Script for Low-Resource HTR,” arXiv, (2026): 5-6, Erişim tarihi: 19 Ekim 2026. https://arxiv.org/abs/2605.02089
[5]
Al-azzawi, vd., 9-15.
[6]
M. Li vd., “TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models,” arXiv (2022), 1-3, Erişim tarihi: 24 Ekim 2026. https://arxiv.org/abs/2109.10282
[7]
A. Chan vd., "HATFormer: Historic Handwritten Arabic Text Recognition with Transformers," arXiv (2024), 3-4, Erişim tarihi 24 Ekim 2026. https://doi.org/10.48550/arXiv.2410.02179
[8]
Chan, vd., 2-5.
[9]
Saleh Momeni ve Bagher BabaAli, “A Transformer-Based Approach for Arabic Offline Handwritten Text Recognition,” Signal, Image and Video Processing 18 (2024), 3–5, Erişim tarihi: 19 Ekim 2026. https://link.springer.com/article/10.1007/s11760-023-02970-9
[10]
M. Li vd., 13094–13096.
[11]
Chan vd., 3-5.
[12]
Momeni ve BabaAli, 1-4.
[13]
G. Bhatia, vd., “Qalam: A Multimodal LLM for Arabic Optical Character and Handwriting Recognition,” arXiv (2024), 6–7, Erişim tarihi: 24 Ekim 2026. https://doi.org/10.48550/arXiv.2407.13559
[14]
Sina J. Semnani vd., “CHURRO: Making History Readable with an Open-Weight Large Vision-Language Model for High-Accuracy, Low-Cost Historical Text Recognition,” arXiv (2025), 1–8, Erişim tarihi: 21 Ekim 2026. https://arxiv.org/abs/2509.19768
[15]
Bhatia, vd., 1.
[16]
Bhatia, vd., 6-8.
[17]
Kirmizialtin ve Wrisley, 6-8; Dölek ve Kurt, 2580
[18]
Bilgin Taşdemir vd., 425-426.
[19]
Dölek ve Kurt, 2587–2588.
[20]
M. Li, vd., 1-2; Chan, vd., 2-3.
[21]
Semnani, vd., 1-2.
[22]
Dölek ve Kurt, 2588-2591; Chan, vd., 4-5.
[23]
Al-azzawi, vd., 3, 9-11.
[24]
Al-azzawi, vd., 3-4, 13-15.
[25]
Dölek ve Kurt, 2587-2591; Al-azzawi, vd., 5, 9-11.
[26]
Dölek ve Kurt, 2588–2591.
[27]
Al-azzawi, vd., 3, 9-11, 13-15.
[28]
Chan, vd., 3-5.
[29]
J. Parkes Allen, J. Mullan, L. Nigst, vd., "OpenITI MAKHZAN: An Open Annotated Dataset of Arabic, Persian, Ottoman Turkish, and Urdu Print and Manuscript Data," Zenodo 2025, Erişim tarihi 24 Ekim 2026. https://doi.org/10.5281/zenodo.16410106
[30]
OpenITI, "Arabic Print Data: Training Data for Arabic-script Print Transcription and Layout Analysis Models," GitHub, Erişim tarihi 24 Ekim 2026. https://github.com/OpenITI/arabic_print_data
[31]
Osmanlica.com, “Test Veri Kümeleri,” Erişim tarihi 27 Ekim 2026, https://osmanlica.com/test
[32]
S. A. Mahmoud, I. Ahmad, W. Al-Khatib, vd., "KHATT: Handwritten Arabic Text," Linguistic Data Consortium, 2015, Erişim tarihi 24 Ekim 2026. https://doi.org/10.35111/vc52-tm53; M. Saeed, A. Chan, A. Mijar, vd., "Muharaf-public: Manuscripts of Handwritten Arabic Dataset for Cursive Text Recognition," Zenodo 2024, Erişim tarihi 24 Ekim 2026. https://doi.org/10.5281/zenodo.11492215; Calfa, "RASAM Dataset: An Open Dataset for the Recognition and Analysis of Scripts in Arabic Maghrebi," GitHub, Erişim tarihi 24 Ekim 2026. https://github.com/calfa-co/rasam-dataset; Calfa, "TariMa: Ground-truth of the TariMa Project (HTR of Maghrebi Arabic Documents)," GitHub, Erişim tarihi 24 Ekim 2026. https://github.com/calfa-co/tarima; A. Ismail, Z. Kamel ve R. Mahmoud, "HICMA: The Handwriting Identification for Calligraphy and Manuscripts in Arabic Dataset," Proceedings of the The First Arabic Natural Language Processing Conference (2023), 24-26, Erişim tarihi 24 Ekim 2026. https://www.semanticscholar.org/paper/HICMA%3A-The-Handwriting-Identification-for-and-in-Ismail-Kamel/a3040695744ca4c871d35d9993875b7d6fe6c9e8
[33]
Parkes Allen, vd., "OpenITI MAKHZAN: An Open Annotated Dataset of Arabic, Persian, Ottoman Turkish, and Urdu Print and Manuscript Data," Zenodo.
[34]
OpenITI, "Arabic Print Data: Training Data for Arabic-script Print Transcription and Layout Analysis Models," GitHub.
[35]
Osmanlica.com, "Test Veri Kümeleri."
[36]
Datalab Team, "Surya: A Lightweight Framework for Analyzing Documents and PDFs at Scale," GitHub, Erişim tarihi 24 Ekim 2026. https://github.com/datalab-to/surya
[37]
B. Kiessling, "Kraken – A Universal Text Recognizer for the Humanities," Digital Humanities Conference 2019, Erişim tarihi 24 Ekim 2026. https://dh-abstracts.library.virginia.edu/works/9912
[38]
Jaided AI, "EasyOCR: Ready-to-use OCR," GitHub, Erişim tarihi 23 Ekim 2026. https://github.com/JaidedAI/EasyOCR
[39]
Y. Zhong, L. Chen, X. Zhao, vd., "OCRVerse: Towards Holistic OCR in End-to-End Vision-Language Models," arXiv, 2026, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2601.21639
[40]
R. Smith, "An Overview of the Tesseract OCR Engine," Ninth International Conference on Document Analysis and Recognition (ICDAR 2007), (2007), 629–633. Erişim tarihi 24 Ekim 2026. https://doi.org/10.1109/ICDAR.2007.4376991
[41]
PaddlePaddle, "PaddleOCR-VL-1.6," PaddleOCR, 2026, Erişim tarihi 24 Ekim 2026. https://www.paddleocr.ai/main/version3.x/algorithm/PaddleOCR-VL/PaddleOCR-VL-1.6.html
[42]
G. Li, X. Wan, S. Peng, vd., "HunyuanOCR-1.5: Making Lightweight OCR VLMs Faster and Better," arXiv, 2026, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2607.04884
[43]
S. J. Semnani, H. Zhang, X. He, M. Tekgürler ve M. S. Lam, "CHURRO: Making History Readable with an Open-Weight Large Vision-Language Model for High-Accuracy, Low-Cost Historical Text Recognition," arXiv, 2025, Erişim tarihi 24 Ekim 2026. https://doi.org/10.48550/arXiv.2509.19768
[44]
Y. Liu, Z. Li, Z. Zhang vd., "MonkeyOCRv2: A Visual-Text Foundation Model for Document AI." arXiv, 2026, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2607.11562
[45]
M. Rashad, "Arabic-Nougat: Fine-Tuning Vision Transformers for Arabic OCR and Markdown Extraction," arXiv, 2024, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2411.17835
[46]
S. Lu, Y. Li, Y. Xia, vd., "OvisOCR2 Technical Report," arXiv, 2026, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2607.13639
[47]
A. Wasfy, A. Nacar, A. Elkhateb, vd., "QARI-OCR: High-Fidelity Arabic Text Recognition through Multimodal Large Language Model Adaptation," arXiv, 2025, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2506.02295
[48]
S. Duan, Y. Xue, W. Wang, vd., "GLM-OCR Technical Report," arXiv, 2026, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2603.10910
[49]
H. Wei, Y. Sun ve Y. Li, "DeepSeek-OCR 2: Visual Causal Flow," arXiv, 2026, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/2601.20552
[50]
M. Li, vd., 13095–13096; Chan, vd., 37.
[51]
Y. Liu, M. Ott, N. Goyal, vd., "RoBERTa: A Robustly Optimized BERT Pretraining Approach," arXiv, 2019, Erişim tarihi 24 Ekim 2026. https://arxiv.org/abs/1907.11692
[52]
M. Li, vd., "TrOCR: Transformer-Based Optical Character Recognition with Pre-Trained Models."
[53]
A. Conneau, K. Khandelwal, N. Goyal, vd., "Unsupervised Cross-lingual Representation Learning at Scale," Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics (2020): 8440–8451, Erişim tarihi 24 Ekim 2026. https://doi.org/10.18653/v1/2020.acl-main.747
[54]
W. Antoun, F. Baly ve H. Hajj, "AraBERT: Transformer-based Model for Arabic Language Understanding," Proceedings of the Fourth Workshop on Open-Source Arabic Corpora and Processing Tools (2020): 9–15, Erişim tarihi 24 Ekim 2026. https://aclanthology.org/2020.osact-1.2/
[55]
L. Xue, N. Constant, A. Roberts, vd., "mT5: A Massively Multilingual Pre-trained Text-to-Text Transformer," Proceedings of the 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, (2021): 483–498, Erişim tarihi 24 Ekim 2026. https://doi.org/10.18653/v1/2021.naacl-main.41
[56]
G. Inoue, B. Alhafni, N. Baimukan vd., "The Interplay of Variant, Size, and Task Type in Arabic Pre-trained Language Models," Proceedings of the Sixth Arabic Natural Language Processing Workshop, (2021): 92–104, Erişim tarihi 24 Ekim 2026. https://aclanthology.org/2021.wanlp-1.10/
[57]
Y. Liu, J. Gu, N. Goyal vd., "Multilingual Denoising Pre-training for Neural Machine Translation," Transactions of the Association for Computational Linguistics 8 (2020): 726–742, Erişim tarihi 24 Ekim 2026. https://doi.org/10.1162/tacl_a_00343

Osmanlıca OCR Neden Zordur?
Literatürdeki Yaklaşımlar
Osmanlıca Üzerinde Doğrudan Yapılan Çalışmalar
Benzer Yazı Sistemlerinden Aktarım
Transformer Modelleri ve Arapça Uyarlamaları
Büyük Görsel-Dil Modelleri: Geniş Tarihî Veri Kümeleri
Osmanlı Türkçesi İçin Değerlendirme
Veri Hazırlama ve Tokenizer Seçimi
Eğitim Verisindeki Kaynaklar
Sayfa Verisini Satır Örneklerine Dönüştürmek
Veri Dağılımı
Hazır OCR Modelleri Osmanlıcayı Ne Kadar Okuyabiliyor?
Tokenizer Neden OCR’ın Bir Parçası?
Tokenizer Deneylerinin Sonucu
Sonuç