
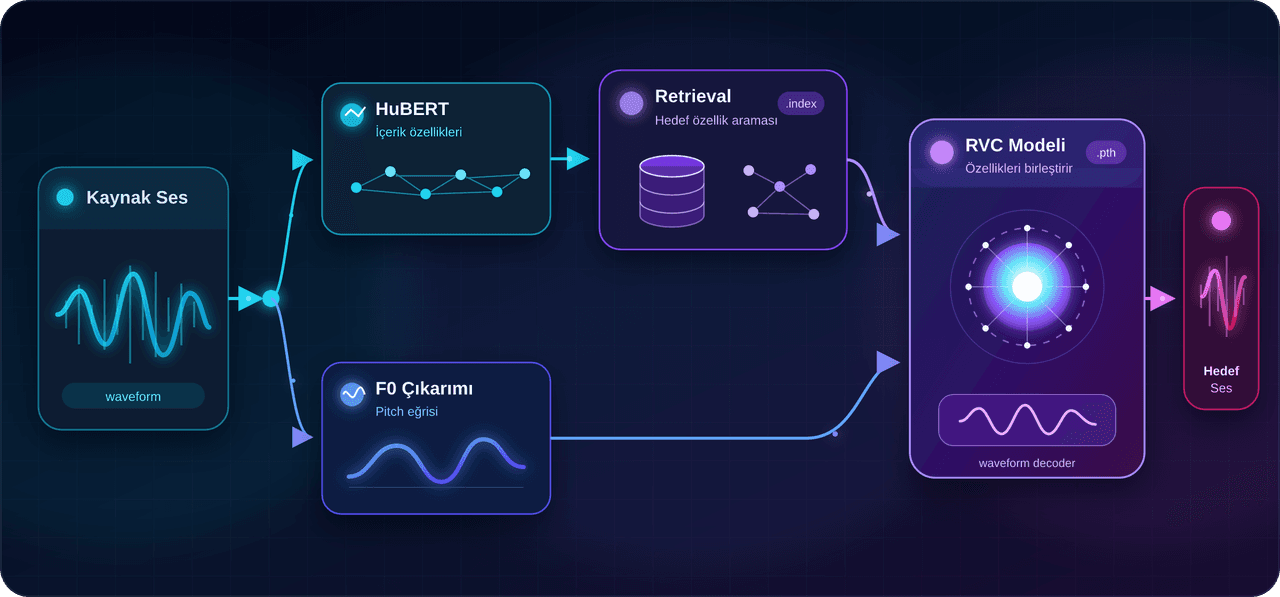
RVC Hattında Kaynak Waveform'un İçerik, Pitch ve Hedef Ses Bileşenleri Üzerinden Dönüştürülmesi (Yapay Zeka ile Oluşturulmuştur.)
Bir konuşma kaydındaki sözcükler, ritim ve vurgu korunurken konuşmacının ses kimliğinin değiştirilmesi istendiğinde voice conversion problemiyle karşılaşılır. Bu problem yalnızca pitch'in (algılanan ses perdesinin) yükseltilmesi veya sesin bir efekt zincirinden geçirilmesiyle çözülemez. Konuşma içeriğinin, perde hareketlerinin, vokal trakt (boğaz, ağız ve burun boşluklarından oluşan ses yolu) özelliklerinin ve konuşmacıya ait diğer ipuçlarının birbirinden yeterince ayrılması gerekir.
Retrieval-based Voice Conversion (RVC) bu ayrımın uygulanabildiği açık kaynaklı yaklaşımlardan biridir. Kaynak sesten çıkarılan içerik özellikleri, temel frekans bilgisi ve hedef sese ait öğrenilmiş temsiller birlikte kullanılır. Ayrıca eğitim verisinden oluşturulan bir özellik indeksi üzerinden benzer örnekler geri getirilebilir. Böylece kaynak konuşmacıdan kalan tını izlerinin azaltılması hedeflenir.【1】 Benzer bir retrieval fikri, kaynak özelliklerin hedef konuşmacıya ait özelliklerin en yakın komşularıyla değiştirildiği kNN-VC yaklaşımında da kullanılır.【2】 RVC'de ise geri getirilen özellikler kaynak özelliklerle harmanlanır.
Bu yazıda RVC sisteminin hangi parçalardan oluştuğu, her parçanın hangi problemi çözdüğü ve bir uygulama tasarlanırken hangi kararların verilmesi gerektiği açıklanacaktır. Verilen ayarlar evrensel optimumlar olarak sunulmayacak; aynı test girdileri üzerinde kontrollü karşılaştırma yapılmasını sağlayan başlangıç noktaları olarak değerlendirilecektir.
Bir kaynak kayıtta aynı anda birden fazla bilgi taşınır. Söylenen sözcükler, bunların süreleri, cümlenin melodisi, konuşma enerjisi, aksan, duygu ve kayıt ortamının izleri tek bir waveform içinde üst üste bulunur. Voice conversion sırasında bunların tamamının değiştirilmesi istenmez.
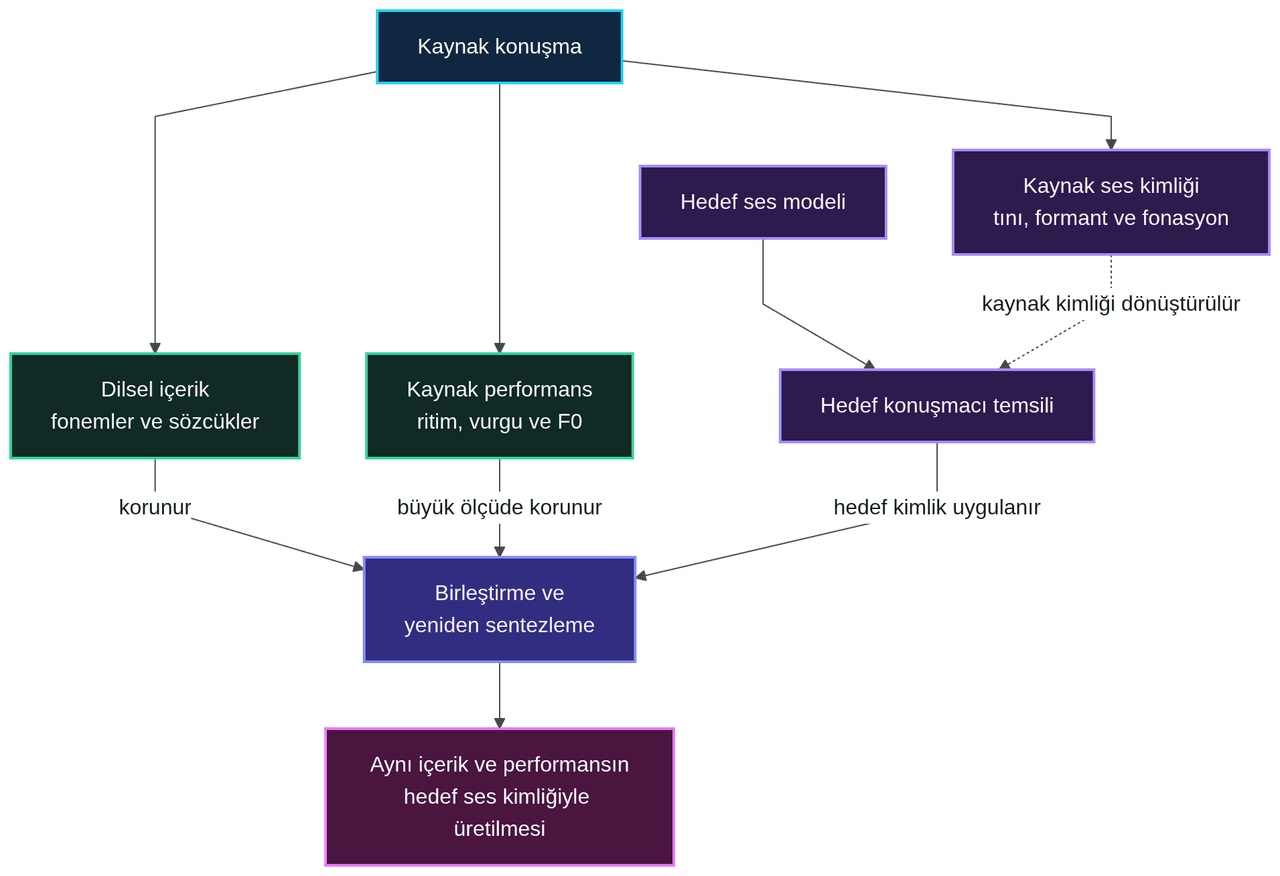
Kaynak Konuşmanın İçerik, Performans ve Konuşmacı Kimliği Bileşenlerine Göre Dönüşümünün Akış Gösterimi (Çizim: Büşra Medine Kurnaz)
Genellikle aşağıdaki özelliklerin korunması beklenir:
Değiştirilmesi hedeflenen özellik ise çoğunlukla konuşmacı kimliğidir. Ancak konuşmacı kimliği tek bir parametreden oluşmadığı için bu hedef kolayca tanımlanamaz. Spektral zarf (enerjinin frekanslar boyunca oluşturduğu genel şekil), formantlar (vokal traktın güçlendirdiği rezonans frekansları), fonasyon biçimi (ses tellerinin titreşim tarzı), ortalama pitch aralığı (sesin tipik incelik-kalınlık bölgesi), ritim alışkanlıkları ve aksan gibi çok sayıda ipucu birlikte değerlendirilir.
Basit pitch shifting (ses perdesini kaydırma) işleminde bütün spektrum belirli bir oranda kaydırılabilir. Bu işlem, sesi daha ince veya kalın duyurabilir ancak yeni bir konuşmacı kimliği oluşturulmuş olmaz. Benzer şekilde yalnızca formantların değiştirilmesi de hedef kişinin artikülasyon, fonasyon ve prozodi (konuşmanın melodi, vurgu, ritim ve süre düzeni) özelliklerini otomatik olarak üretmez. Voice conversion sistemlerinde daha zengin temsillere bu nedenle ihtiyaç duyulur.
Birbirine yakın görünmelerine rağmen bu kavramlarda farklı girdiler ve farklı hedefler kullanılır.
Tablo 1: Text-to-Speech, Voice Conversion, Voice Cloning ve DSP Yaklaşımlarının Karşılaştırılması
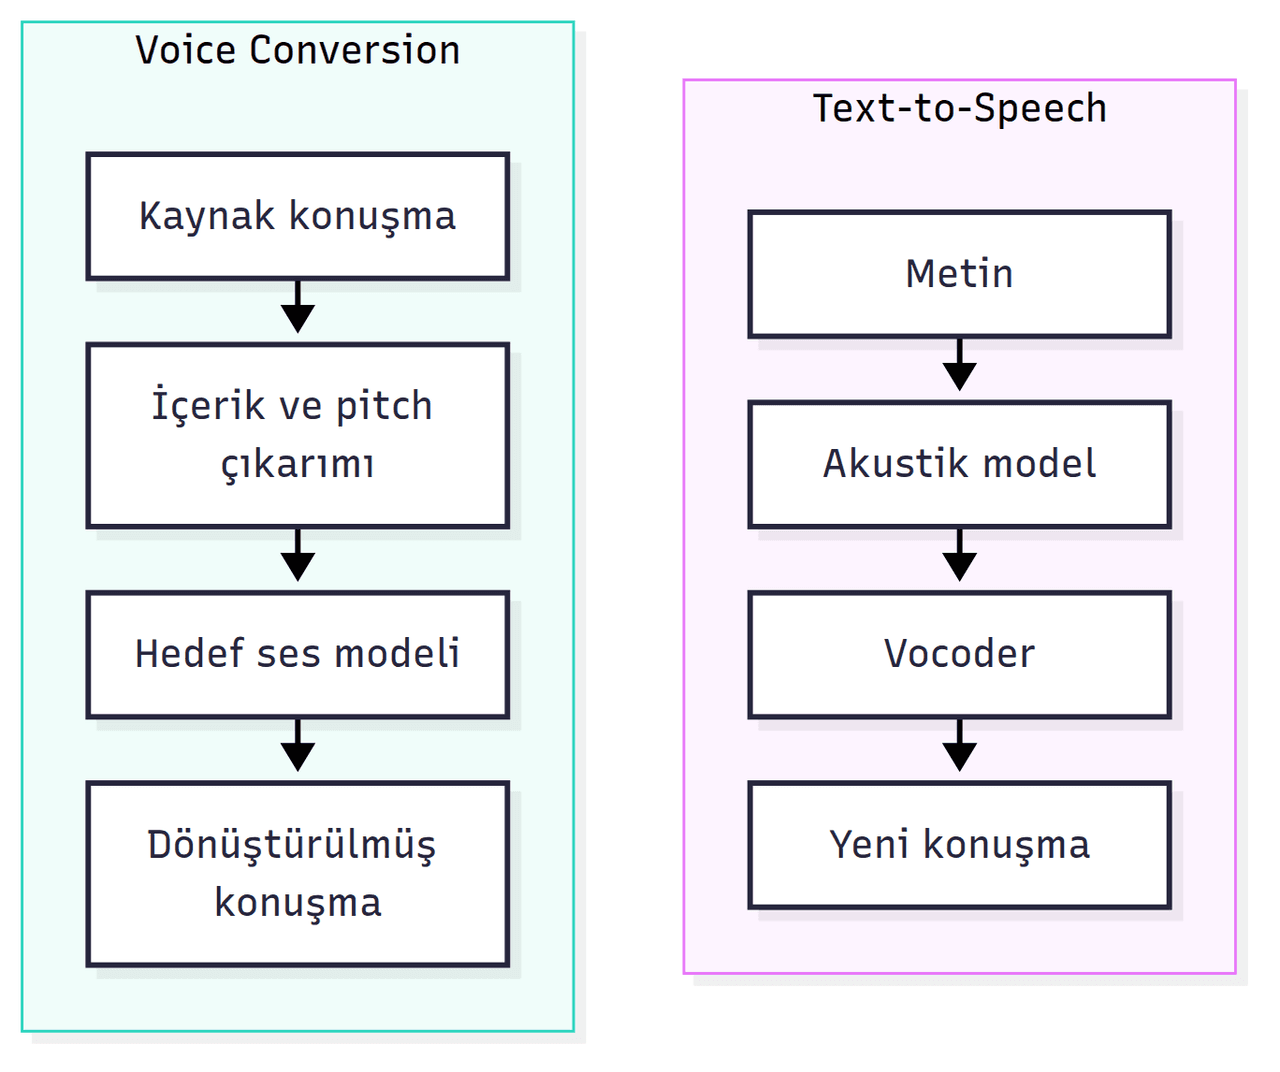
Voice Conversion ve Metinden Konuşma (TTS) Akışlarının Karşılaştırılması (Çizim: Büşra Medine Kurnaz)
TTS sisteminde dilsel içerik metinden alınır ve konuşma sıfırdan sentezlenir. Voice conversion sisteminde ise zamanlama ve ifade zaten kaynak ses içinde bulunur. Bu nedenle kaynak performansın büyük bölümü doğrudan taşınabilir.
DSP, İngilizce "digital signal processing" ifadesinin kısaltmasıdır ve Türkçede "sayısal sinyal işleme" olarak kullanılır. Bu yaklaşımda bir model tarafından yeni konuşmacı kimliği öğrenilmek zorunda değildir; mevcut ses dalgasına pitch shifting, formant shifting, EQ, compression veya çeşitli efektler doğrudan uygulanır. Bu nedenle DSP ile sesin karakteri değiştirilebilir ancak tek başına hedef bir konuşmacının bütün özelliklerinin aktarılması beklenmemelidir.
Voice cloning daha geniş bir terim olarak kullanılabilir. Kısa bir referans kayıttan speaker embedding çıkarılması, bir TTS modelinin hedef sese uyarlanması veya RVC için hedef konuşmacı modeli eğitilmesi bu başlık altında değerlendirilebilir.【3】 Bu nedenle her voice-cloning sistemi RVC değildir; her RVC kullanımında da sıfırdan bir kimlik çıkarılması gerekmez.
RVC hattı üç ana işleme ayrılabilir: analiz, eşleme ve yeniden sentezleme.
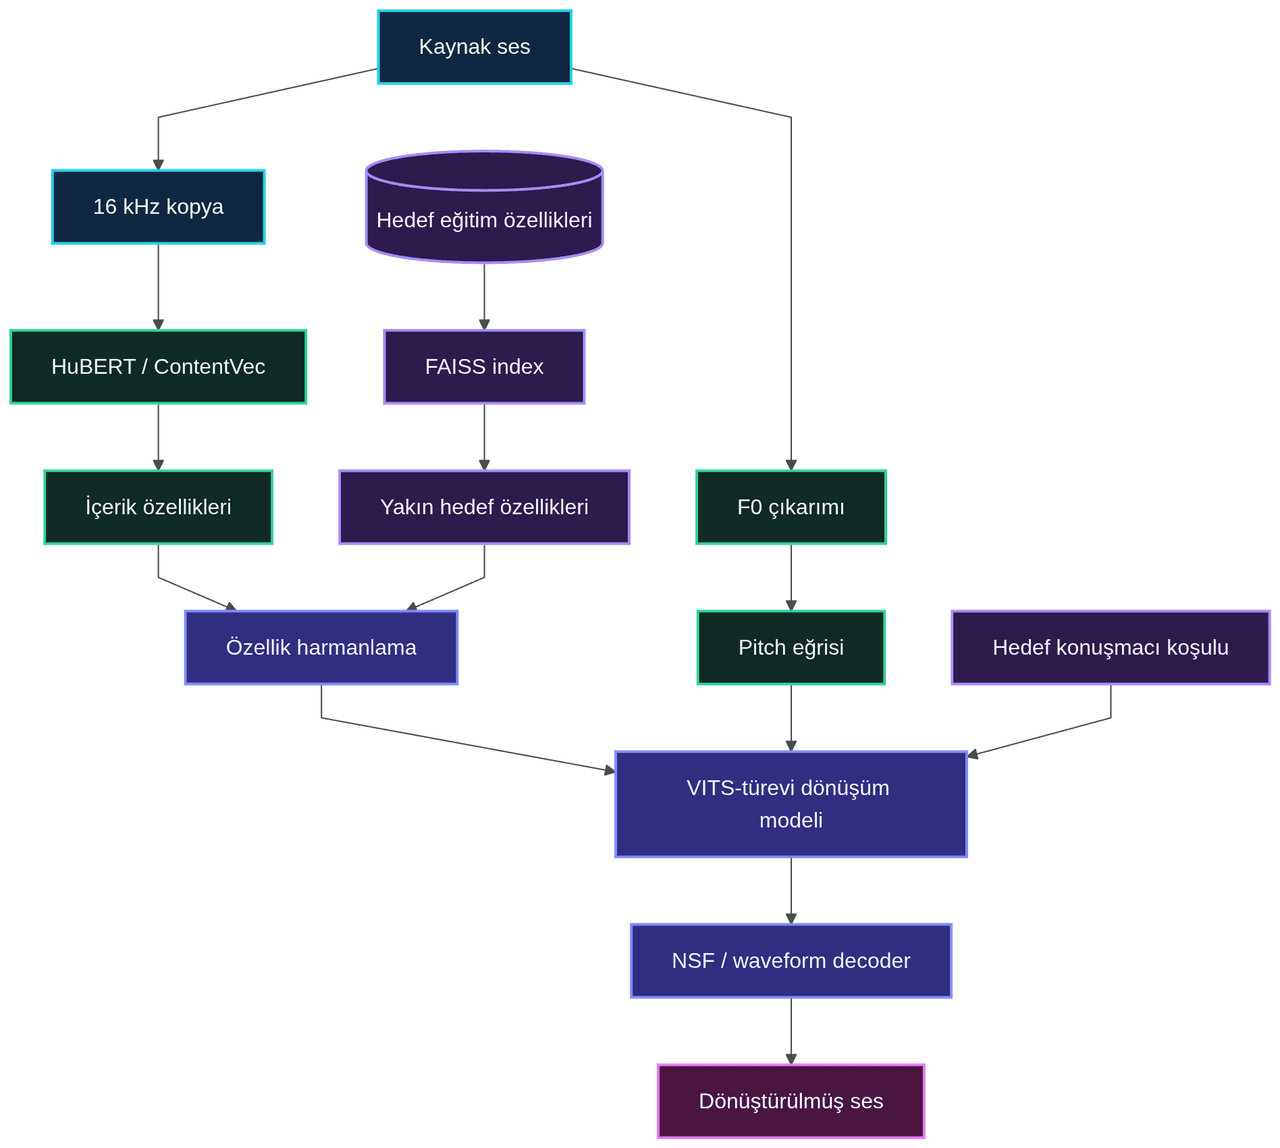
RVC Dönüşüm Hattının Analiz, Eşleme ve Yeniden Sentez Aşamaları (Çizim: Büşra Medine Kurnaz)
Resmî RVC uygulamasında HuBERT/ContentVec tabanlı özellikler kullanılmakta, eğitim özellikleri FAISS index içinde aranmakta ve VITS-türevi bir sentezleyiciyle ses üretilmektedir. Güncel model kodunda prior encoder (içerikten olası latent dağılımı çıkaran ağ), eğitim sırasında kullanılan posterior encoder (gerçek hedef sesten latent çıkaran ağ), normalizing flow (iki latent dağılım arasında tersinir dönüşüm kuran katmanlar), speaker embedding ve NSF tabanlı decoder (F0'dan üretilen harmonik kaynak sinyaliyle koşullandırılan, HiFi-GAN tarzı artık bloklar içeren waveform üreticisi) bileşenleri görülebilir.【4】
Eğitim sırasında gerçek hedef waveform veya spektrogramdan posterior latent değişkenler çıkarılabilir ve prior dağılımla hizalanabilir. Çıkarım sırasında gerçek hedef ses bulunmadığından prior encoder, kaynak sesten çıkarılan içerik özelliklerinden ve F0'dan “atent dağılımın parametrelerini üretir; bu dağılımdan örneklenen temsil ters flow üzerinden decoder'a gönderilir. VITS yaklaşımındaki variational yapı ve adversarial eğitim bu ayrımın temelini oluşturur.【5】
Ses üreten ağda HiFi-GAN yaklaşımından yararlanılır. Bu yaklaşımda kısa ve uzun süreli ses örüntülerinin birlikte işlenebilmesi için farklı genişlikte çalışan paralel bloklar kullanılır.【6】 Eğitim sırasında ise gerçek ses ile üretilen sesi karşılaştıran ayırt edici ağlara (discriminator) başvurulur. Ses dalgası farklı periyot aralıklarında incelenerek doğal konuşmadaki periyodik ve harmonik yapının öğrenilmesi desteklenir. Ayırt edici ağlar yalnızca eğitimde kullanılır; çıkarım sırasında ses üretimine katılmaz.【7】
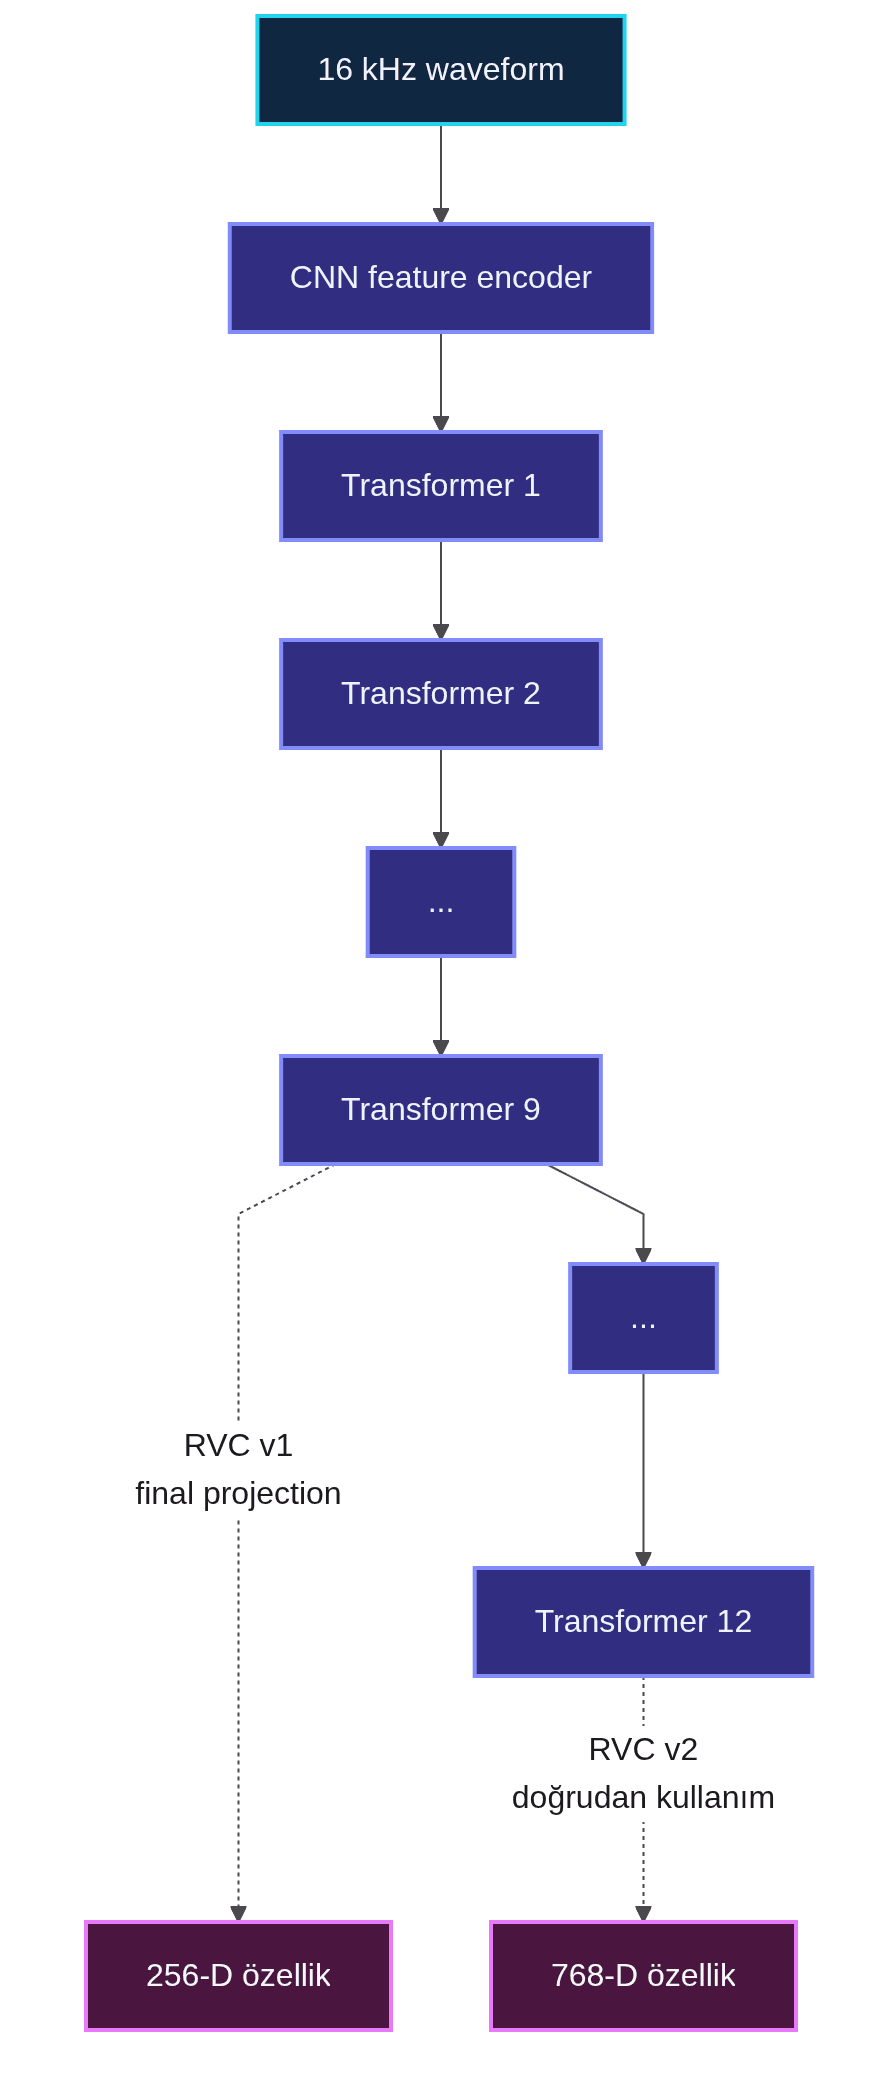
HuBERT/ContentVec Özellik Çıkarımının Katman Yapısı ve RVC v1/v2 Çıkış Noktaları (Çizim: Büşra Medine Kurnaz)
HuBERT, konuşma sinyalindeki fonetik ve akustik örüntüleri öğrenmek için kullanılan kendinden denetimli bir konuşma temsil modelidir. Waveform'dan, sesin zaman akışıyla hizalı latent özellikler çıkarılır. Ön eğitim sırasında maskelenmiş bölgeler için kümelenmiş gizli birimler tahmin edilir. Böylece fonetik ve akustik yapı hakkında bilgi taşıyan özellikler öğrenilir.【8】
Farklı katmanlarda farklı türde bilgi taşınabilir. Alt katmanlarda yerel akustik ayrıntılar daha baskın olabilirken üst katmanlarda içerikle ilişkili daha soyut örüntüler güçlenebilir.【9】 Bununla birlikte konuşmacı bilgisi tamamen yok edilmez. ContentVec'te içerik korunurken konuşmacı bilgisinin azaltılması amacıyla HuBERT üzerine ayrıştırma mekanizmaları eklenir.【10】
Güncel RVC kodunda iki özellik düzeni açıkça ayrılır:
HuBERT girdisinin 16 kHz'e dönüştürülmesi, feature encoder’ın eğitim düzeniyle uyum sağlanması için gerçekleştirilir.【11】 Nihai modelin 40 veya 48 kHz ses üretmesi, içerik encoder’ının da aynı örnekleme hızında çalışmasını gerektirmez. Aynı sesin farklı amaçlarla farklı örnekleme hızlarında kopyaları tutulabilir.
HuBERT özellikleri konuşmanın içeriğini temsil eder ancak cümlenin ses perdesi hareketlerini açık bir F0 eğrisi olarak sunmaz. Kaynak konuşmanın melodisinin korunabilmesi için F0 ayrı bir yöntemle çıkarılır ve RVC modeline ek bilgi olarak verilir.
Ötümlülük (voicing), ses üretilirken ses tellerinin titreşmesi durumudur. F0, bu titreşimin saniyedeki tekrar sayısını gösterir. Ünlüler gibi ötümlü bölgelerde ölçülebilir; s ve f gibi ötümsüz seslerde veya sessizlikte anlamlı bir F0 bulunmaz.
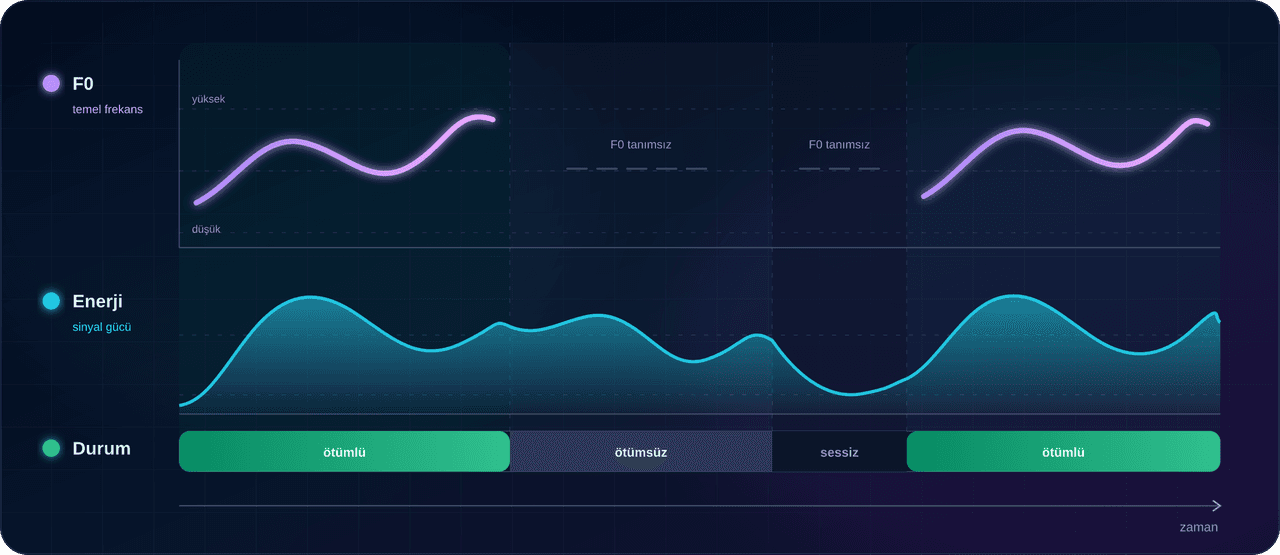
F0 Eğrisinin Yalnızca Ötümlü Bölgelerde Bulunduğunu, Enerji ve Ötümlülük Durumuyla Birlikte Gösteren Şema (Yapay Zeka ile Oluşturulmuştur.)
F0 tahmini sırasında üç sorunla sık karşılaşılır:
RVC arayüzlerinde görülen RMVPE, CREPE, Harvest ve DIO gibi adlar farklı voice-conversion modellerini değil, F0 eğrisini çıkaran yöntemleri belirtir.【12】 İç çalışma ayrıntılarının bilinmesi çoğu kullanım için gerekli değildir:
Uygun yöntem, aynı kısa kayıt birkaç seçenekle dönüştürülerek ve F0 kopmaları, ani perde sıçramaları ya da metalik bozulmalar dinlenerek seçilebilir. Kullanılan RVC sürümünde bu yöntemlerin yalnızca bir kısmı sunulabilir.
Pitch transpose işlemi yarım ses cinsinden uygulanabilir. n yarım seslik kaydırma için F0 değeri formülüyle dönüştürülür. RVC'de bu dönüşüm F0 eğrisine uygulanır.【16】 Ancak büyük kaydırmalar formant ve pitch arasındaki doğal ilişkiyi bozabilir. Bu nedenle transpose değeri, hedef konuşmacının doğal aralığı ve kaynak performans birlikte dinlenerek seçilmelidir.
RVC modellerinde .pth ve .index dosyaları farklı görevler üstlenir:
Tablo 2: RVC Modellerinde .pth ve .index Dosyalarının Görevleri
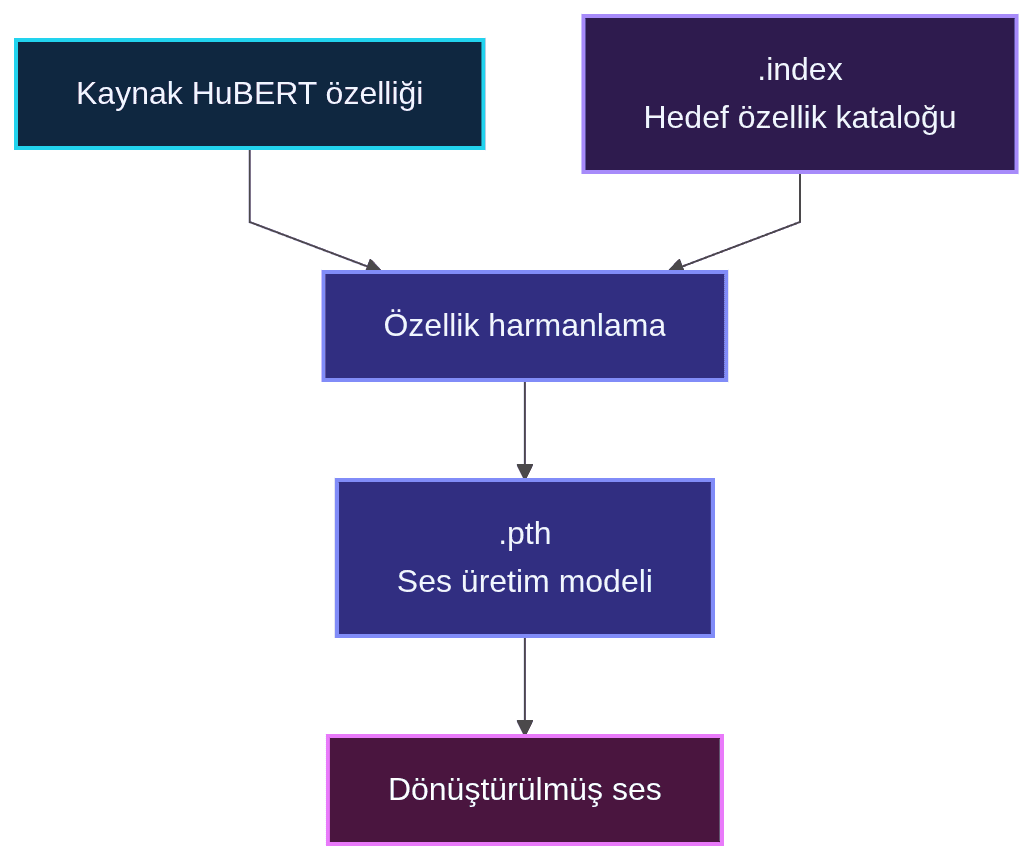
.pth ve .index Bileşenlerinin Özellik Harmanlaması ile Ses Üretimi (Çizim: Büşra Medine Kurnaz)
.pth, modelin öğrendiği ağırlıkları içerir ve ses üretiminin temelini oluşturur. .index ise hedef seslerden çıkarılan HuBERT özelliklerini aranabilir bir katalog hâline getirir. Kaynak sesten çıkarılan özellikler bu katalogdaki benzer hedef özelliklerle desteklenebilir.【17】 Bu harmanlama kavramsal olarak şöyle gösterilebilir:
Buradaki α, index_rate değeridir. 0 değeri .index kullanımını kapatır; değer yükseltildiğinde hedef özelliklerin etkisi artırılır. Ancak hedef veri kalitesizse gürültü ve artikülasyon sorunları da güçlendirilebilir.
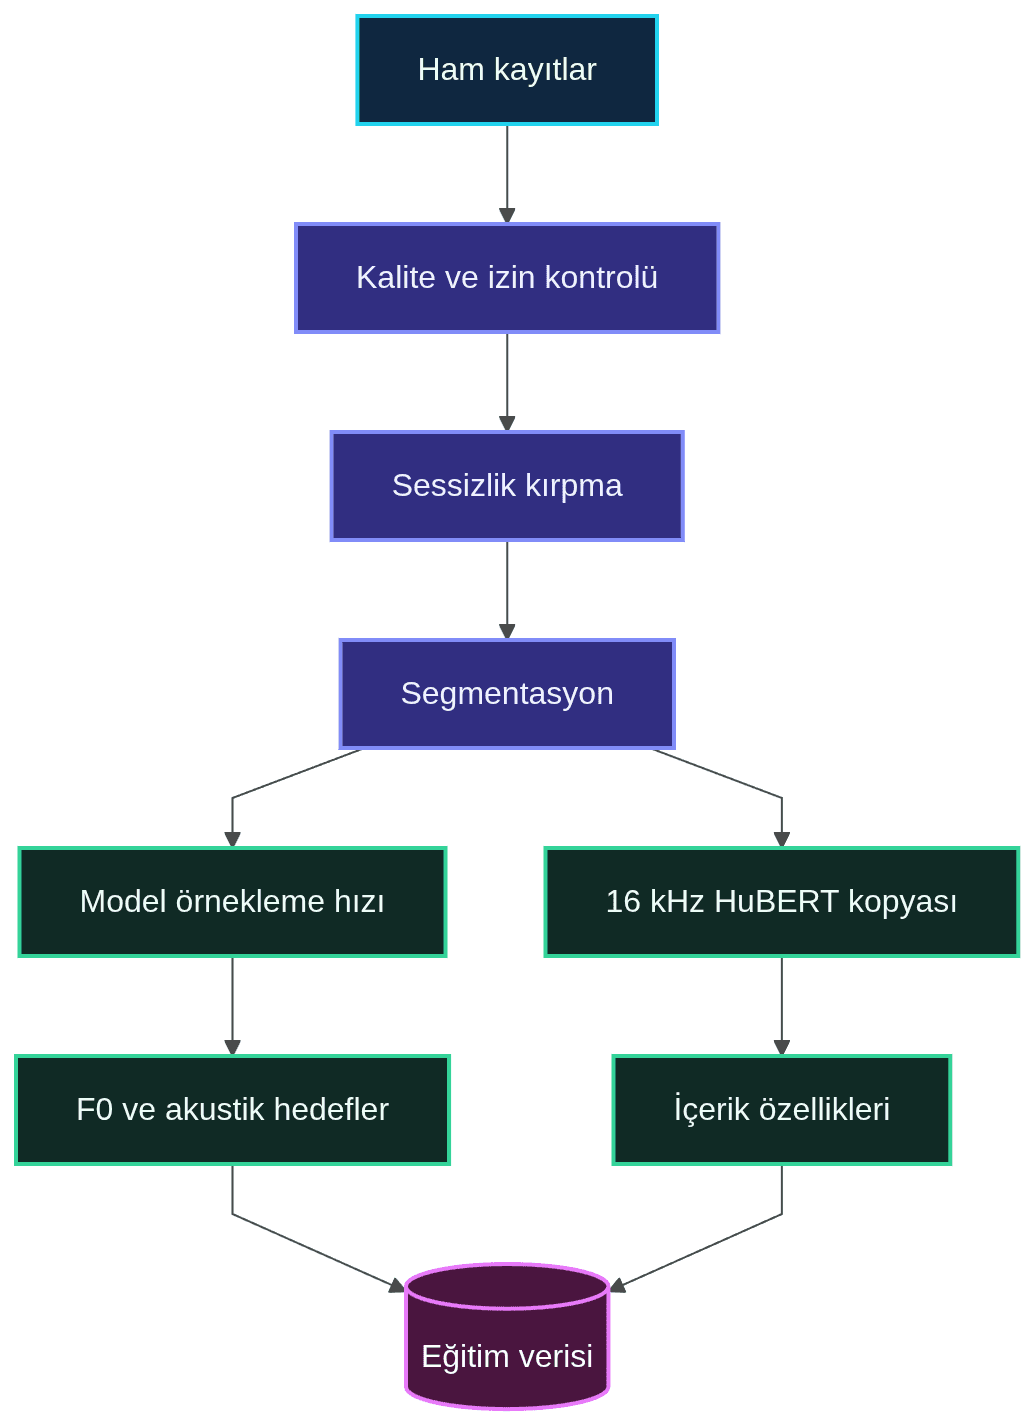
Ham Kayıtlardan Eğitim Verisine Veri Hazırlama Akışı (Çizim: Büşra Medine Kurnaz)
Model mimarisi kadar veri kümesinin tutarlılığı da önemlidir. Hedef konuşmacının yanında oda, mikrofon veya gürültü koşulları sürekli değişiyorsa hangi özelliğin öğrenileceği belirsizleşir.
Veri seçiminde gözetilmesi gereken özellikler şöyle özetlenebilir:
Resmî RVC README'sinde düşük gürültülü en az on dakikalık konuşma pratik bir başlangıç olarak önerilir.【18】 Bu değer kalite garantisi değildir. Fonetik çeşitlilik, kayıt temizliği ve hedeflenen kullanım alanı toplam süreden daha belirleyici olabilir.
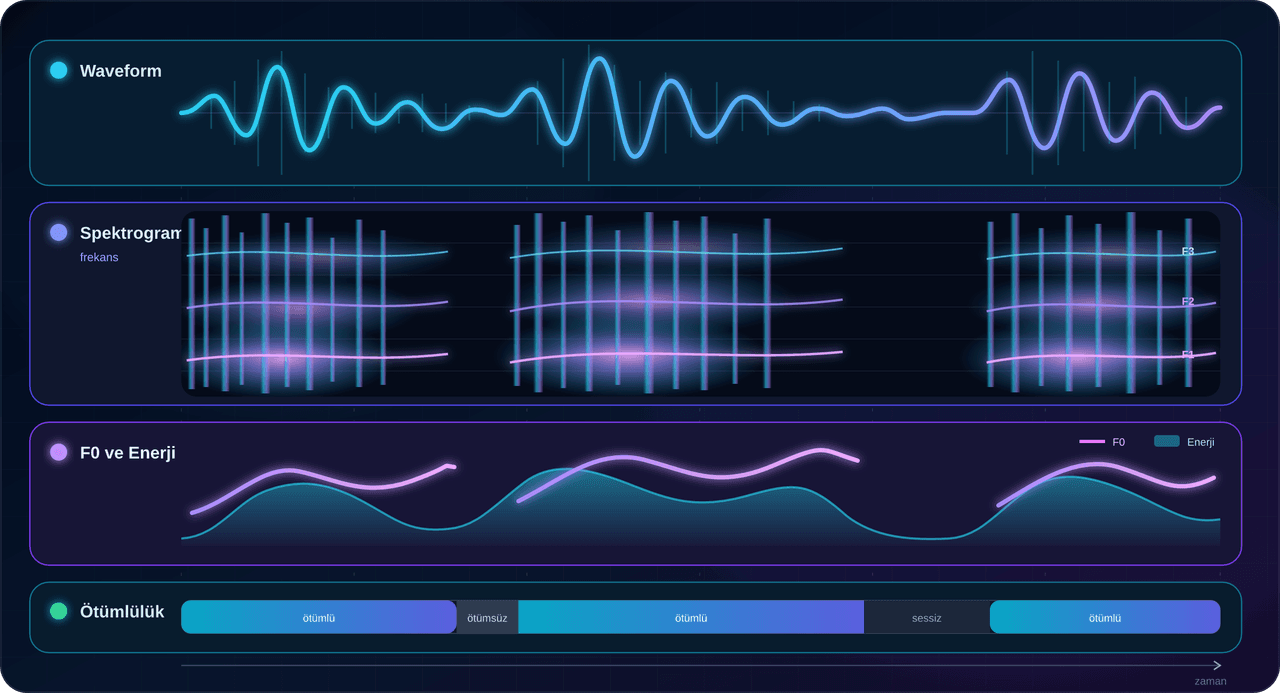
Aynı Konuşmanın Waveform, Spektrogram, F0 ve Enerji ile Ötümlülük Görünümleri (Yapay Zeka ile Oluşturulmuştur.)
Sessizlik kırpma, uzun kayıtları segmentlere ayırma, örnekleme hızını dönüştürme ve loudness kontrolü uygulanabilir. Ancak otomatik işlemlerin çıktısı dinlenmeden kabul edilmemelidir. Agresif bir trim işlemi kelime başındaki patlamalı ünsüzleri veya doğal nefesleri kesebilir. Aşırı kısa segmentlerde bağlam kaybedilebilir; aşırı uzun segmentlerde ise bellek tüketimi ve batch dengesizliği artabilir.
Özellik çıkarımından önce dosya-özellik hizası korunmalıdır. Waveform segmenti, F0 dizisi ve HuBERT matrisi aynı zaman aralığını temsil etmelidir. Yanlış dosya adları veya farklı hop uzunlukları (ardışık analiz çerçeveleri arasındaki örnek sayısı) sessiz fakat yıkıcı eğitim hatalarına yol açabilir.
Pratik Kontrol: Eğitim başlatılmadan önce rastgele seçilen birkaç segment için waveform, spektrogram, F0 ve feature uzunluğu birlikte çizdirilebilir.
Hedef kişiye ait yalnızca birkaç kısa konuşma bulunduğunda ses kimliği kısmen öğrenilebilir; ancak fonetik çeşitlilik, farklı cümle uzunlukları ve perde hareketleri yeterince temsil edilmeyebilir. RVC belgelerinde önerilen düşük gürültülü en az on dakikalık kayıt miktarına ulaşılamadığında, gerçek kayıtları tamamlamak amacıyla sentetik veriden yararlanılabilir. Burada önemli bir ayrım yapılmalıdır: Üretilen farklı metinler tek başına eğitim verisi değildir. Bu metinlerin, gerçek kısa kayıtları referans alabilen voice-cloning özellikli bir TTS sistemiyle hedef kişinin sesinde seslendirilmesi gerekir. Başka bir konuşmacıya ait sıradan bir TTS sesi hedef veri kümesine eklenirse RVC modeli iki farklı ses kimliğini birlikte öğrenmeye çalışır.
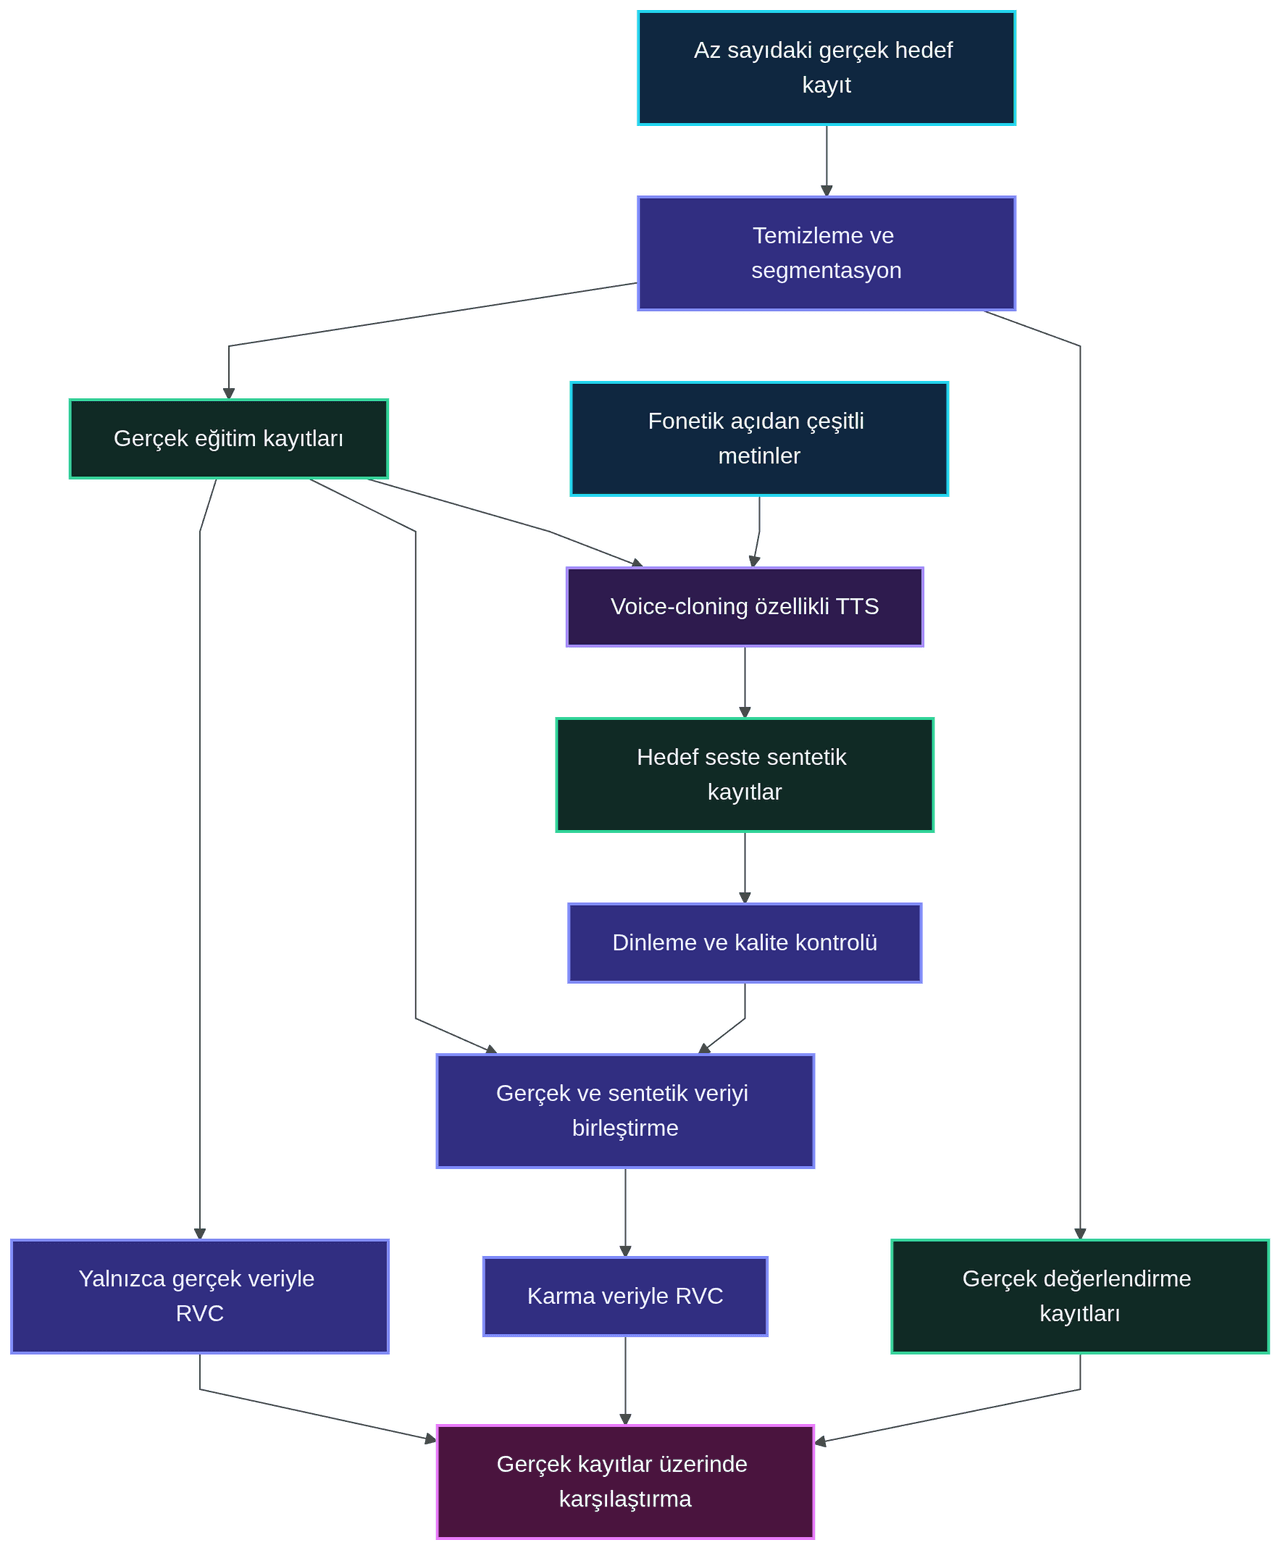
Az Kayıtlı Hedef Konuşmacı için Gerçek ve Sentetik Veri Ayrımı ve Değerlendirme Akışı (Çizim: Büşra Medine Kurnaz)
Uygulanabilecek akış şu şekildedir:
Sentetik kayıtların toplam veri içindeki payı sınırlı tutulmalı, gerçek kayıtların ağırlığı korunmalıdır. Gerekirse gerçek kayıtlar eğitim listesinde daha sık örneklenebilir. Doğrudan kontrol için biri yalnızca gerçek, diğeri gerçek ve sentetik kayıtlarla olmak üzere iki RVC modeli eğitilebilir. İki model de eğitim dışında bırakılan gerçek kayıtlarla karşılaştırıldığında sentetik verinin gerçekten yarar sağlayıp sağlamadığı görülebilir.
Sentetik veri, gerçek kayıtlarda bulunmayan yeni ve güvenilir konuşmacı ayrıntıları oluşturmaz; yalnızca mevcut kısa referanstan tahmin edilen ses kimliğini daha çeşitli cümlelere yayar. TTS sistemindeki yapay ritim, nefes eksikliği veya spektral bozulmalar da RVC tarafından öğrenilebilir. Bu nedenle veri miktarından önce hedef sese benzerlik ve kayıt kalitesi gözetilmelidir. İlk RVC modelinin kendi çıktılarının yeniden eğitim verisi yapılması da aynı hataların büyütülmesine yol açabileceğinden tercih edilmemelidir.
Inference zamanında metinden doğrudan hedef karakterde konuşma üretilmek istendiğinde TTS ve RVC art arda bağlanabilir. TTS tarafından dilsel içerik, telaffuz, süreler ve temel prozodi üretilir. RVC tarafından bu performansın konuşmacı kimliği hedef modele doğru dönüştürülür. RVC, TTS'nin yanlış telaffuzunu veya hatalı duraklamasını otomatik olarak düzeltmez; bu hatalar kaynak performansın parçası olarak taşınabilir.
İki aşama arasında aşağıdaki noktalar kontrol edilmelidir:
Ara WAV dosyası kayıpsız biçimde saklanırsa sorun TTS mi yoksa RVC kaynaklı mı daha kolay belirlenebilir. Üretim zinciri doğrudan bellekte çalıştırılsa bile hata ayıklama modunda ara çıktının kaydedilmesi yararlı olur.
Dosya tabanlı çıkarım işleminde bütün ses elde edildikten sonra dönüşüm yapılabilir. Gerçek zamanlı sistemde ise kısa parçalar (chunk) işlenip oynatma kuyruğuna aktarılmalıdır.
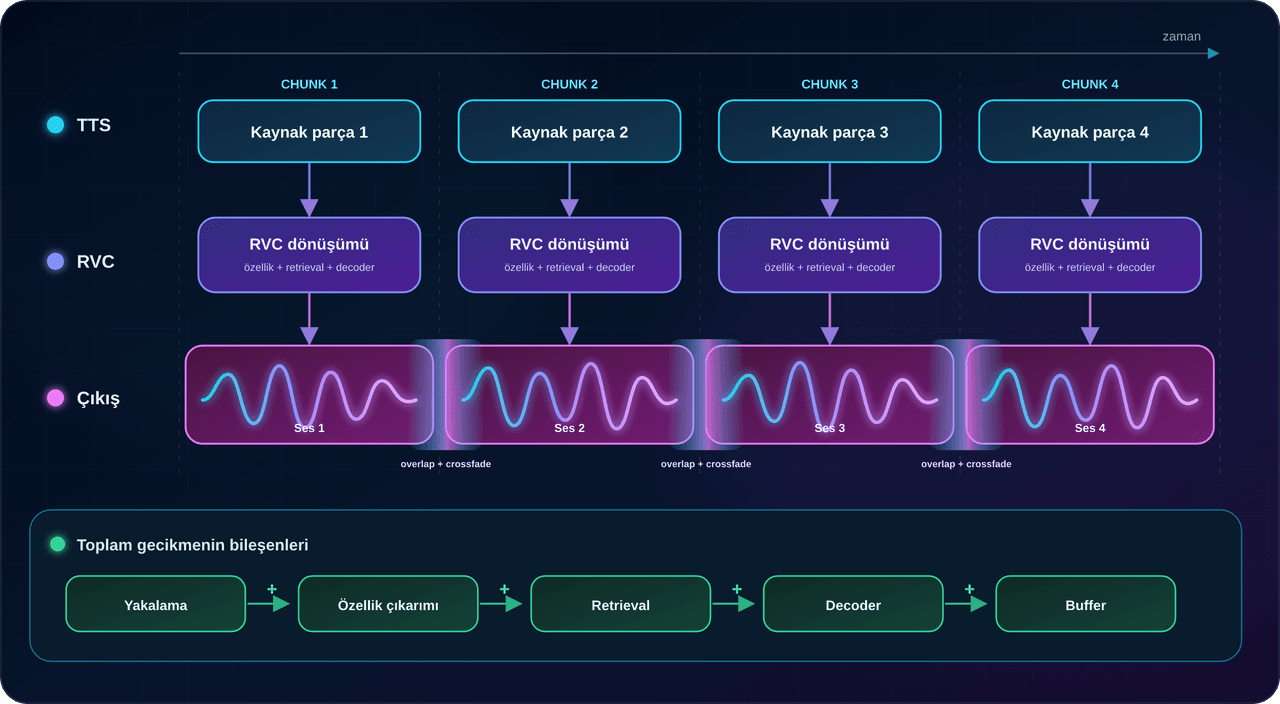
TTS Parçalarının RVC ile Gerçek Zamanlı Dönüştürülmesini, Overlap ve Crossfade Bölgelerini ve Gecikme Bileşenlerini Gösteren Streaming Şeması (Yapay Zeka ile Oluşturulmuştur.)
Chunk çok kısa seçildiğinde yeterli fonetik ve akustik bağlam bulunmayabilir. Çok uzun seçildiğinde ilk ses gecikmesi büyür. Ayrıca iki chunk sınırında waveform fazı, F0, loudness veya model bağlamı farklılaşabilir. Klik, kopma ve tını sıçramaları bu nedenle oluşabilir.
Bu sorunları azaltmak için:
Gerçek zamanlılık yalnızca GPU çıkarım süresiyle belirlenmez. Ses yakalama tamponu, resampling, feature extraction, retrieval, decoder, crossfade ve ses sürücüsü gecikmeleri birlikte ölçülmelidir.
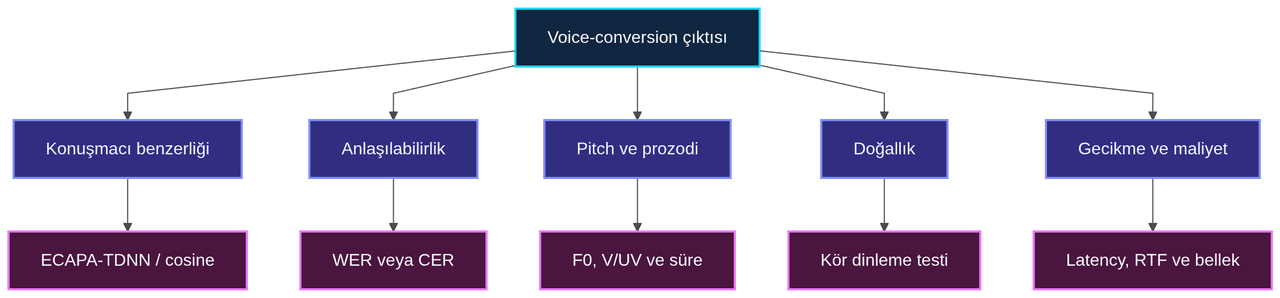
Voice Conversion Çıktısının Değerlendirme Ölçütlerine Göre Ayrılması (Çizim: Büşra Medine Kurnaz)
Voice conversion kalitesi tek bir sayıyla özetlenmemelidir. Hedef konuşmacıya benzer fakat anlaşılmaz bir çıktı da çok doğal fakat yanlış kişiyi andıran bir çıktı da başarısız sayılabilir.
RVC’de kaynak konuşmadan HuBERT veya ContentVec aracılığıyla çıkarılan içerik temsilleri, ayrı olarak elde edilen F0 bilgisi, hedef konuşmacı koşulu ve retrieval ile bulunan hedef özelliklerle birleştirilerek yeni bir ses dalgası üretilir. Elde edilen kalite yalnızca model mimarisine değil; temiz ve çeşitli eğitim verisine, dikkatle denetlenmiş sentetik kayıtlara, uygun çıkarım ayarlarına ve tutarlı değerlendirme ölçütlerine de bağlıdır. Bu nedenle RVC, tek adımlı bir ses efekti olarak değil, her bileşeni ayrı ayrı incelenmesi gereken çok aşamalı bir yapay zekâ sistemi olarak değerlendirilmelidir.
Baas, Matthew, Benjamin van Niekerk ve Herman Kamper. “Voice Conversion With Just Nearest Neighbors.” arXiv 2023. Erişim: 31 Ekim 2026. https://arxiv.org/abs/2305.18975
Desplanques, Brecht, Jenthe Thienpondt ve Kris Demuynck. “ECAPA-TDNN: Emphasized Channel Attention, Propagation and Aggregation in TDNN Based Speaker Verification.” arXiv 2020. Erişim: 3 Kasım 2026. https://arxiv.org/abs/2005.07143
Facebook Research. “Faiss.” GitHub. Erişim: 4 Kasım 2026. https://github.com/facebookresearch/faiss
Hsu, Wei-Ning, Benjamin Bolte, Yao-Hung Hubert Tsai, Kushal Lakhotia, Ruslan Salakhutdinov ve Abdelrahman Mohamed. “HuBERT: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units.” arXiv 2021. Erişim: 29 Ekim 2026. https://arxiv.org/abs/2106.07447
Jia, Ye, Yu Zhang, Ron J. Weiss, Quan Wang, Jonathan Shen, Fei Ren, Zhifeng Chen, Patrick Nguyen, Ruoming Pang, Ignacio Lopez Moreno ve Yonghui Wu. “Transfer Learning from Speaker Verification to Multispeaker Text-To-Speech Synthesis.” arXiv 2019. Erişim: 1 Kasım 2026. https://arxiv.org/abs/1806.04558
Johnson, Jeff, Matthijs Douze ve Hervé Jégou. “Billion-Scale Similarity Search With GPUs.” arXiv 2017. Erişim: 2 Kasım 2026. https://arxiv.org/abs/1702.08734
Kim, Jaehyeon, Jungil Kong ve Juhee Son. “Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech.” Proceedings of the 38th International Conference on Machine Learning, PMLR 139 (2021): 5530-5540. Erişim: 4 Kasım 2026. https://proceedings.mlr.press/v139/kim21f.html
Kim, Jong Wook, Justin Salamon, Peter Li ve Juan Pablo Bello. “CREPE: A Convolutional Representation for Pitch Estimation.” arXiv 2018. Erişim: 25 Ekim 2026. https://arxiv.org/abs/1802.06182
Kong, Jungil, Jaehyeon Kim ve Jaekyoung Bae. “HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Synthesis.” Advances in Neural Information Processing Systems 33 (NeurIPS 2020): 1-12. Erişim: 5 Kasım 2026. https://proceedings.neurips.cc/paper/2020/hash/c5d736809766d46260d816d8dbc9eb44-Abstract.html
Morise, Masanori, Fumiya Yokomori ve Kenji Ozawa. “WORLD: A Vocoder-Based High-Quality Speech Synthesis System for Real-Time Applications.” IEICE Transactions on Information and Systems E99-D (7). (2016): 1877-1884. Erişim: 1 Kasım 2026. https://doi.org/10.1587/transinf.2015EDP7457
Qian, Kaizhi, Yang Zhang, Heting Gao, Junrui Ni, Cheng-I Lai, David Cox, Mark Hasegawa-Johnson ve Shiyu Chang. “ContentVec: An Improved Self-Supervised Speech Representation by Disentangling Speakers.” Proceedings of the 39th International Conference on Machine Learning, PMLR 162. (2022): 18003-18017. Erişim: 2 Kasım 2026. https://proceedings.mlr.press/v162/qian22b.html
RVC-Project. “Retrieval-based Voice Conversion WebUI.” GitHub. Erişim: 26 Ekim 2026. https://github.com/RVC-Project/Retrieval-based-Voice-Conversion-WebUI
Wang, Xin, Shinji Takaki ve Junichi Yamagishi. “Neural Source-Filter-Based Waveform Model for Statistical Parametric Speech Synthesis.” arXiv 2019. Erişim: 31 Ekim 2026. https://arxiv.org/abs/1810.11946
Wei, Haojie, Xueke Cao, Tangpeng Dan ve Yueguo Chen. “RMVPE: A Robust Model for Vocal Pitch Estimation in Polyphonic Music.” Interspeech. (2023): 5421-5425. Erişim: 3 Kasım 2026. https://www.isca-archive.org/interspeech_2023/wei23b_interspeech.pdf
[1]
RVC Project, "Retrieval-based Voice Conversion WebUI," GitHub, Erişim: 26 Ekim 2026. https://github.com/RVC-Project/Retrieval-based-Voice-Conversion-WebUI
[2]
Matthew Baas, Benjamin van Niekerk ve Herman Kamper, “Voice Conversion With Just Nearest Neighbors,” arXiv 2023, 1-2, Erişim: 31 Ekim 2026. https://arxiv.org/abs/2305.18975
[3]
Ye Jia, Yu Zhang, Ron J. Weiss, vd., “Transfer Learning from Speaker Verification to Multispeaker Text-To-Speech Synthesis,” arXiv 2019, 1-2, Erişim: 1 Kasım 2026. https://arxiv.org/abs/1806.04558; RVC-Project, “Retrieval-based Voice Conversion WebUI.”
[4]
RVC-Project, “Retrieval-based Voice Conversion WebUI.”
[5]
Jaehyeon Kim, Jungil Kong ve Juhee Son, “Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech,” Proceedings of the 38th International Conference on Machine Learning, PMLR 139 (2021), 5531–5532, Erişim: 4 Kasım 2026. https://proceedings.mlr.press/v139/kim21f.html
[6]
Jungil Kong, Jaehyeon Kim ve Jaekyoung Bae, “HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Synthesis,” Advances in Neural Information Processing Systems 33 (NeurIPS 2020), 2-3, Erişim: 5 Kasım 2026. https://proceedings.neurips.cc/paper/2020/hash/c5d736809766d46260d816d8dbc9eb44-Abstract.html
[7]
Jungil Kong, Jaehyeon Kim ve Jaekyoung Bae, “HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Synthesis,” 3-4.
[8]
Wei-Ning Hsu, Benjamin Bolte, Yao-Hung Hubert Tsai, Kushal Lakhotia, Ruslan Salakhutdinov ve Abdelrahman Mohamed, “HuBERT: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units,” arXiv 2021, 1-3, Erişim: 29 Ekim 2026. https://arxiv.org/abs/2106.07447
[9]
Wei-Ning Hsu vd., “HuBERT: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units,” 7-8.
[10]
Kaizhi Qian, Yang Zhang, Heting Gao, vd., “ContentVec: An Improved Self-Supervised Speech Representation by Disentangling Speakers,” Proceedings of the 39th International Conference on Machine Learning, PMLR 162 (2022), 18003–18007, Erişim: 2 Kasım 2026. https://proceedings.mlr.press/v162/qian22b.html
[11]
RVC-Project, “Retrieval-based Voice Conversion WebUI.”
[12]
RVC-Project, “Retrieval-based Voice Conversion WebUI.”
[13]
Haojie Wei, Xueke Cao, Tangpeng Dan ve Yueguo Chen, “RMVPE: A Robust Model for Vocal Pitch Estimation in Polyphonic Music,” Interspeech, (2023), 5421, 5423–5424, Erişim: 3 Kasım 2026. https://www.isca-archive.org/interspeech_2023/wei23b_interspeech.pdf
[14]
Jong Wook Kim, Justin Salamon, Peter Li ve Juan Pablo Bello, “CREPE: A Convolutional Representation for Pitch Estimation,” arXiv 2018, 1-3, Erişim: 25 Ekim 2026. https://arxiv.org/abs/1802.06182
[15]
Masanori Morise, Fumiya Yokomori ve Kenji Ozawa, “WORLD: A Vocoder-Based High-Quality Speech Synthesis System for Real-Time Applications,” IEICE Transactions on Information and Systems E99-D (7), (2016), 1877-1884, Erişim: 1 Kasım 2026. https://doi.org/10.1587/transinf.2015EDP7457
[16]
RVC-Project, “Retrieval-based Voice Conversion WebUI.”
[17]
RVC-Project, “Retrieval-based Voice Conversion WebUI.”
[18]
RVC-Project, “Retrieval-based Voice Conversion WebUI.”
[19]
Brecht Desplanques, Jenthe Thienpondt ve Kris Demuynck, “ECAPA-TDNN: Emphasized Channel Attention, Propagation and Aggregation in TDNN Based Speaker Verification,” arXiv 2020, 1, 3-4, Erişim: 3 Kasım 2026. https://arxiv.org/abs/2005.07143

Ses Dönüşümünde Ne Korunur, Ne Değişir?
TTS, Voice Cloning ve Voice Conversion: Temel Farklar
RVC Dönüşüm Hattının İç Yapısı
Eğitim ve Çıkarım Aşamaları
HuBERT ve ContentVec ile İçerik Temsili
RVC’de F0 Neden Ayrı Çıkarılır?
.pth Modeli ile .index Arasındaki Fark
Hedef Ses Verisi Nasıl Hazırlanır?
Ön İşleme
Az Kayıtla RVC Verisi Nasıl Çeşitlendirilir?
TTS ve RVC Entegrasyonu
Gerçek Zamanlı Dönüşüm ve Streaming
RVC Çıktısı Nasıl Değerlendirilir?
Sonuç