
Bir dil modelinin yanlış cevabı her zaman dağınık veya anlamsız görünmez. Model doğru bir şiirin ritmini sürdürebilir, var olmayan bir yayına akademik bir başlık verebilir ya da kaynaktaki bir bilgiyi kendinden emin biçimde değiştirebilir. Halüsinasyon problemi, bu yüzey akıcılığı ile doğruluk arasındaki ayrımda ortaya çıkar. Güvenilirlik için yalnız cevabın nasıl göründüğünü değil, hangi iddiaları taşıdığını, bunların neye dayandığını ve üretim sırasında ne zaman müdahale gerektiğini değerlendirmek gerekir.
Bu yazı, iki bölümlük Dil Modellerinde Halüsinasyon serisinin ilk bölümüdür. Halüsinasyonun nedenleri dil modelleme hedefinden başlanarak açıklanmakta; tespit ve müdahale yöntemleri ile doğru cevapların korunmasına ilişkin değerlendirme ölçütleri ele alınmaktadır. Ana örnek olarak Gemma 4 modelleriyle yürüttüğümüz İstiklal Marşı denemesi kullanılmaktadır. İkinci bölümde, geliştirdiğimiz Özsezi mimarisinin kontrol katmanları ve uygulama adımları açıklanmaktadır. Özsezi adıyla, modelin iç işleyişinden elde edilen belirtilerin üretim kararlarına bağlanması ifade edilmektedir.
Bu ilk yazının sonunda okur, kendi uygulamasında neyi yanlış sayacağını tanımlayabilecek, token belirsizliğini doğrulukla karıştırmadan okuyabilecek ve bir azaltma yöntemini uygun ölçütlerle sınayabilecektir. Olasılık dağılımı ve temel model çıkarımı bilgisi yeterlidir; denklemlerde kullanılan her değişken ilgili bölümde açıklanır. İkinci yazıda bu temel; model erişimi, kontrol varlıkları ve üretim kararlarının uygulamaya nasıl bağlandığı üzerinden geliştirilir.
Büyük dil modeli (Large Language Model, LLM) bağlamında halüsinasyon, gerçekmiş gibi sunulan fakat olgusal olarak yanlış olan veya görevde esas alınan kaynakla uyuşmayan içerikleri tanımlamak için kullanılır. Tanımın kapsamı çalışmalara göre değişir. Bu nedenle bir tespit sistemi kurulmadan önce hangi yanlışlığın hedeflendiği belirlenmelidir. Dünya bilgisine ilişkin doğruluk ile verilen belgeye sadakat aynı değerlendirme ekseni değildir.【1】
Olgusal doğruluk, bir iddianın güvenilir dış bilgiyle uyuşmasını sorgular. Kaynağa sadakat ise cevabın verilen metni doğru temsil edip etmediğini inceler. Gerçekte doğru olan bir bilgi, yalnız belirli bir belgeyi özetleme görevinde belgede bulunmadığı hâlde belgeye atfedilirse yine sorun oluşturur. Tersine bir belgede yanlış bilgi yazıyor olabilir; belgeyi sadakatle aktarmak bu bilgiyi dış dünya açısından doğru kılmaz.
“Desteklenemedi” etiketi de dikkatle kullanılmalıdır. Eldeki belgede bir iddianın bulunmaması, onun yanlış olduğunu kanıtlamaz. İddia için doğrulanmış, çelişen ve mevcut kanıtla değerlendirilemeyen durumlar ayrılmalıdır. Sistem, kanıt yokluğunu yanlışlıkla eşitlerse gerçek ama kaynakta geçmeyen bilgileri gereksiz yere bastırır.
Tablo 1: Hata Türü ile Doğrulama İşinin Eşleştirilmesi
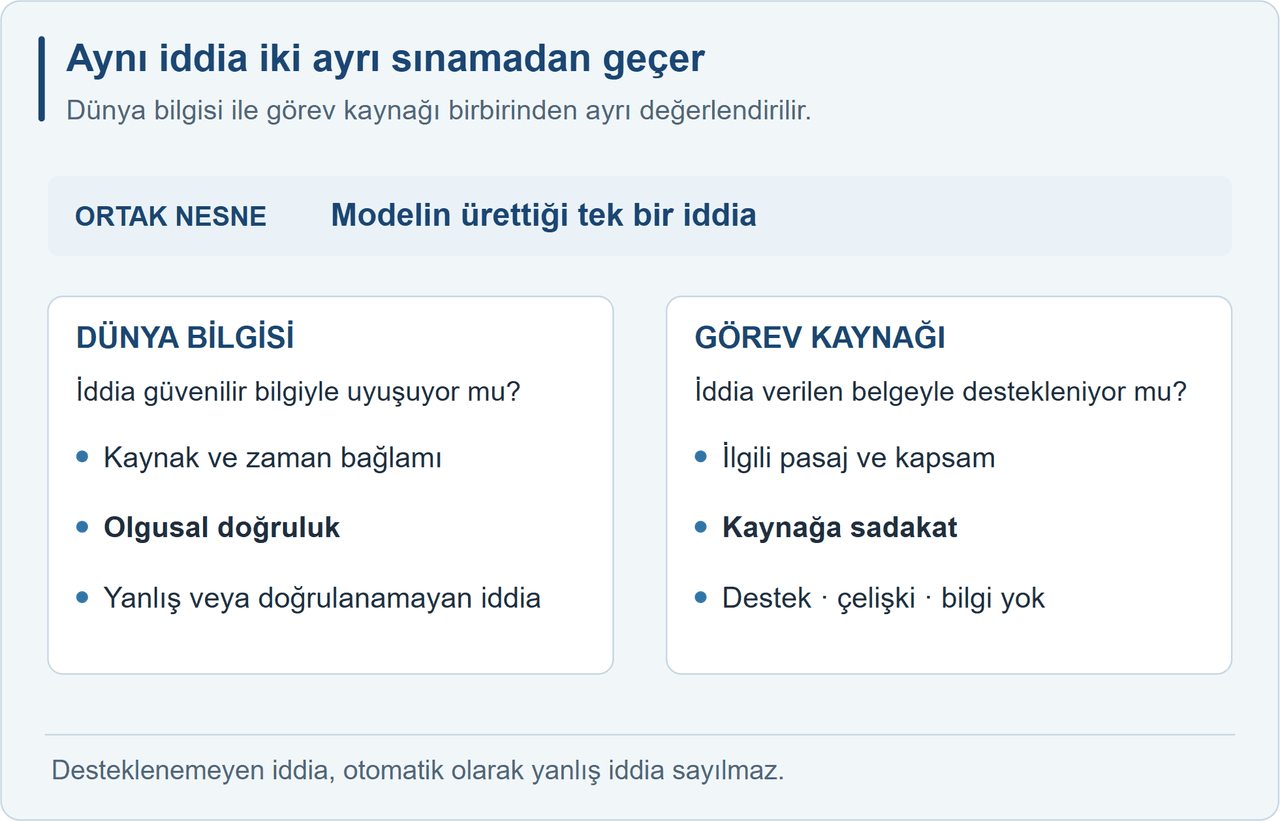
Doğruluk ve Kaynağa Sadakat (Yapay Zekâ ile Oluşturulmuştur.)
Bu ayrım özellikle çok bileşenli sistemlerde önemlidir. Biçim doğrulayıcısı JSON çıktısının geçerli olduğunu gösterebilir; içerikteki tarih veya kaynak iddiasının doğruluğunu göstermez. Benzer biçimde zararlı bir isteği reddetmek, olgusal doğruluk ölçümünden farklı bir karardır. Bir sistemin bu görevlerin hepsine müdahale edebilmesi, bunları tek hata sınıfı saymayı gerektirmez.【2】
Yürüttüğümüz denemede, modellerden İstiklal Marşı’nın ilk iki kıtasını yazmaları istendi. Küçük model google/gemma-4-E4B-it【3】 ile ilk kıtanın aktarılmasında güçlük yaşandığı, ikinci kıtada ise özgün dizeler yerine kafiyeli fakat yanlış cümleler üretildiği gözlendi. google/gemma-4-31B-it【4】 ile ilk kıta doğru aktarılmasına rağmen ikinci kıtada benzer bir bozulmayla karşılaşıldı. Model kimlikleri resmî model kartlarındaki adlarıyla kullanıldı; E4B adındaki etkin büyüklük ifadesi toplam parametre sayısıyla eşitlenmedi.
Bu görev yaratıcı şiir yazımı değildir. İstenen, var olan bir metnin doğru biçimde aktarılmasıdır. Dolayısıyla bir dizenin anlamlı olması, önceki dizeyle kafiyelenmesi veya millî bir şiirin üslubunu çağrıştırması başarı ölçütü olamaz. Değerlendirme, seçilmiş bir referans sürümün dizelerine sadakat üzerinden yapılmalıdır. İlerideki tekrarlar için resmî bir referans metnin【5】 önceden sabitlenmesi gerekir.
Denemenin sonraki aşamasında küçük modelin ağırlıkları değiştirilmeden, geliştirdiğimiz üç denetim katmanı birlikte etkinleştirildi. Doğru metin isteme veya dışarıdan alınan bir kaynağa eklenmedi. Söz Süzgeci, Yön Dengesi ve Yol Sezgisi adlarını verdiğimiz bu katmanlarda sırasıyla logits işlemcileri, davranış ekseninde aktivasyon denetimi ve üretim yolunun beklenen sonucunu kestirme çalışmalarından yararlanıldı; bu fikirler uygulamamızın gereksinimlerine göre uyarlandı. Üç katmanın birlikte etkinleştirildiği koşulda küçük modelle ilk iki kıtanın hatasız üretildiği görüldü. Böylece aynı ağırlıklarla elde edilen sonucun, üretim sürecine uygulanan denetimle değiştirilebildiği gözlendi.
Vakanın önemli çıkarımı şudur: Bir modelin ilk denemede yanlış cevap vermesi, o cevabı üretme kapasitesinin kesinlikle bulunmadığını göstermez. Aynı ağırlıklarla ve kaynak metin eklenmeden doğru cevaba ulaşılması, doğru metnin modelden çıkarılabildiği yorumunu destekler. Bununla birlikte bu sonuç, ön eğitim korpusunun içeriğini doğrudan gözlemlemekle eşdeğer değildir. Metnin eğitimde hangi biçimde bulunduğu ile modelin belirli bir çıkarım düzeninde onu doğru üretebilmesi farklı iddialardır.
Bu bölümde, belirli bir görevde elde ettiğimiz nitel sonuç ele alınmaktadır. Tekrarlı bir başarı oranı sunulmadığından bu denemeden küçük modelin genel olarak 31B modelden üstün olduğu veya her soruda aynı kazanımın sağlanacağı sonucu çıkarılmamalıdır. İkinci bölümde, denememizde etkinleştirilen üç katman ile geniş mimarimizdeki isteğe bağlı bileşenler ayrı ayrı açıklanmaktadır.
Bir otoregresif dil modeli, verilen soru ve önceki token’lar altında sıradaki token’ın dağılımını üretir. Modelin logits adı verilen ham skorları softmax dönüşümüyle olasılıklara çevrilir. Bir yanıtın olasılığı, ardışık koşullu token olasılıklarının çarpımı olarak yazılabilir.
Denklem 1: Yanıt Olasılığı
Burada q soru veya istemi, y yanıtı, T yanıt uzunluğunu ve θ model parametrelerini gösterir. Ön eğitimde yaygın hedef, veri içindeki sonraki token’lara verilen negatif log olasılığı azaltmaktır.
Denklem 2: Dil Modelleme Kaybı
Bu hedefi “model yalnız kelime tamamlar, bilgi öğrenmez” biçiminde yorumlamak yanıltıcıdır. Sonraki token’ı iyi tahmin etmek için dilsel yapıların yanında olgular, ilişkiler ve dünya düzenlilikleri de öğrenilebilir. Sorun, bu öğrenmenin her üretimde doğruluğu denetleyen açık bir sözleşmeye dönüşmemesidir. Veri içindeki yanlışlıklar, seyrek olgular veya birden çok olası açıklama da aynı öğrenme sürecine girer.【6】
İstiklal Marşı örneğinde modelin öğrendiği şiirsel biçim, doğru metni aktarma hedefiyle çatışabilir. İlk yanlış dize üretildiğinde sonraki token’lar artık bu yanlış devamı da bağlam olarak görür. Model, özgün metne dönmek yerine yeni oluşan şiiri tutarlı biçimde sürdürmeye başlayabilir. Denememizde gözlenen davranış için bu mekanizma olası bir açıklama olarak değerlendirilmektedir. Burada iç aktivasyon analizi sunulmadığından, bu yorum doğrudan ölçülmüş bir mekanizma bulgusu olarak ele alınmamalıdır.
Üretim sırasında seçilen yol da önemlidir. Greedy decoding her adımda en yüksek olasılıklı token’ı seçer. Örneklemeli üretim ise olasılık dağılımından seçim yapar. Greedy seçim, tüm yanıtın en olası dizisini bulmayı garanti etmediği gibi en doğru cevabı da garanti etmez. Sıcaklığı azaltmak üretim çeşitliliğini daraltabilir; güçlü ama yanlış bir devamın baskın olduğu durumda aynı hatayı daha kararlı hâle de getirebilir.
Greedy seçimin sınırı küçük bir ağaçta görülebilir. İlk adımda A yolunun olasılığı 0,60, B yolununki 0,40 olsun. A’dan sonraki en olası devam 0,50, B’den sonraki en olası devam 0,95 ise iki adımlı yolların olasılıkları sırasıyla 0,30 ve 0,38 olur. Greedy ilk adımda A’yı seçer ve ikinci adımın sonucunu önceden hesaba katmaz. Bu tamamen açıklayıcı bir olasılık örneğidir; bir Gemma çalıştırmasının ölçümü değildir. Ayrıca en olası tam diziyi bulmak bile olgusal doğruluğu garanti etmez: Modelin olasılık hedefi ile görevin doğruluk ölçütü ayrı kalır.
Yanlış devamın bağlamı değiştirmesi de bu ayrımla ilgilidir. Bir metni birebir aktarma görevinde model bir dizeyi değiştirdiğinde, sonraki adımın sorusu artık yalnız “Özgün şiirde sırada ne var?” değildir; üretilmiş yanlış dizeye hangi devamın uyacağı da koşullamaya girer. Hata, tek bir sözcükte durmak yerine yeni bir örüntüyü besleyebilir. Aşağıdaki şema bu olası mekanizmayı gösterir; geçmiş İstiklal Marşı denemesinin kaydedilmiş token izi değildir.【7】
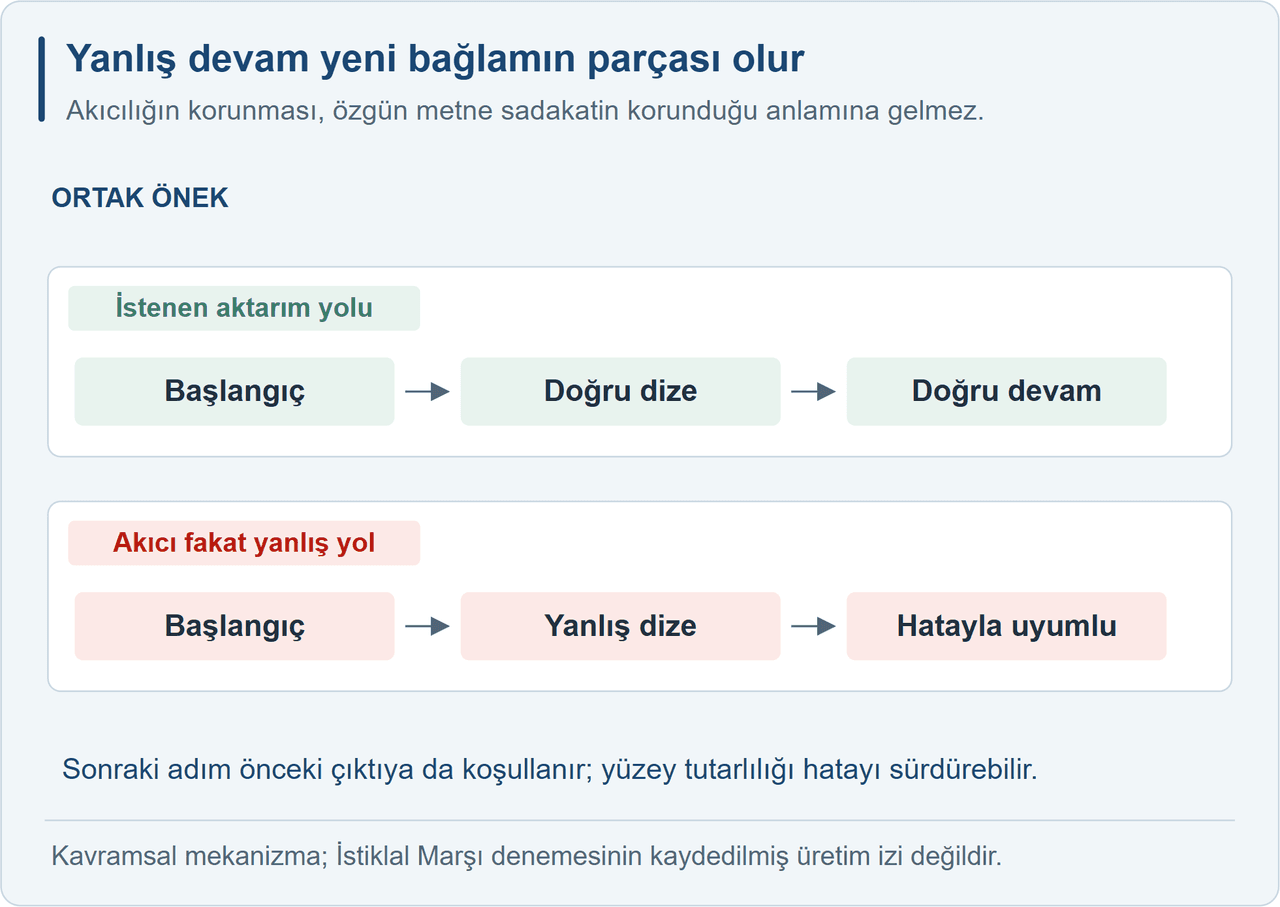
Yanlış Devamın Üretim Bağlamına Etkisi (Yapay Zekâ ile Oluşturulmuştur.)
Her olgu eğitim verisinde yeterince temsil edilmez. Model, sık karşılaştığı ilişkilerde başarılıyken seyrek bir eser adı, yerel tarih ayrıntısı veya özel bir kişi hakkında benzer kalıplardan hareketle yanlış bir tamamlama yapabilir. Bilginin eğitim kesiminden sonra değişmesi de başka bir durumdur: Modelin bir zamanlar doğru olan cevabı, sorunun tarihine göre yanlış hâle gelebilir.
Çelişkili veri ayrıca ele alınmalıdır. Aynı olay hakkında farklı tarihler, adlandırmalar veya rivayetler bulunabilir. Model bu farklılıkların hangisinin yetkili kaynak, hangisinin eski sürüm veya yorum olduğunu güvenilir biçimde ayıramayabilir. Çözüm yalnız daha fazla veri eklemek değildir; kaynağın niteliğini ve zamansal kapsamını değerlendirmek de gerekir.
Bir bilgiyi eğitimde öğrenmiş olmak, her istem biçiminden aynı güvenilirlikle çağırabilmek anlamına gelmez. Sorunun dili, kullanılan adlandırma, bağlamın sırası ve istenen çıktı biçimi üretimi etkileyebilir. Bu yüzden “model bilmiyor” ile “bu istemde doğru bilgiyi kullanamadı” ayrımı araştırılmalıdır.
Bu ayrım, Zeyuan Allen-Zhu’nun bilgi saklama, çağırma ve kullanma üzerine dersinde daha da açılır: Doğru bir sonuca ulaşılması, sonucun hangi beceriyle üretildiğini tek başına göstermez. Benzer bir soru-cevap eğitimde görülmüş olabilir; aynı sonuç, ayrı ayrı öğrenilmiş bilgilerin yeni bir soruda birleştirilmesiyle de üretilebilir. Yanlış bir cevapta ise bilginin hiç öğrenilmemesi, bu istemde çağırılamaması ve doğru çağırılan bilgi üzerinde yanlış işlem yapılması ayrı olasılıklar olarak değerlendirilmelidir.【8】
Bu ayrım Türkçe bir örnekle somutlaştırılabilir. Tamamen kurmaca bir eğitim kaydında “Deniz Kaya 1984 yılında doğdu.” bilgisinin bulunduğu varsayılsın. “Deniz Kaya çift bir yılda mı doğdu?” sorusunun doğru cevabı “evet”tir. Ancak bu cevabın, doğum yılının çağırılıp çift sayı kuralının uygulanmasıyla mı yoksa eşdeğer bir soru-cevabın daha önce görülmesiyle mi üretildiği yalnız sonuca bakılarak belirlenemez. Aşağıdaki şema, aynı soruda karşılaşılabilecek başarı ve hata nedenlerini ayırır; gerçek bir modelin iç işleyişine ilişkin tanı sunmaz.【9】
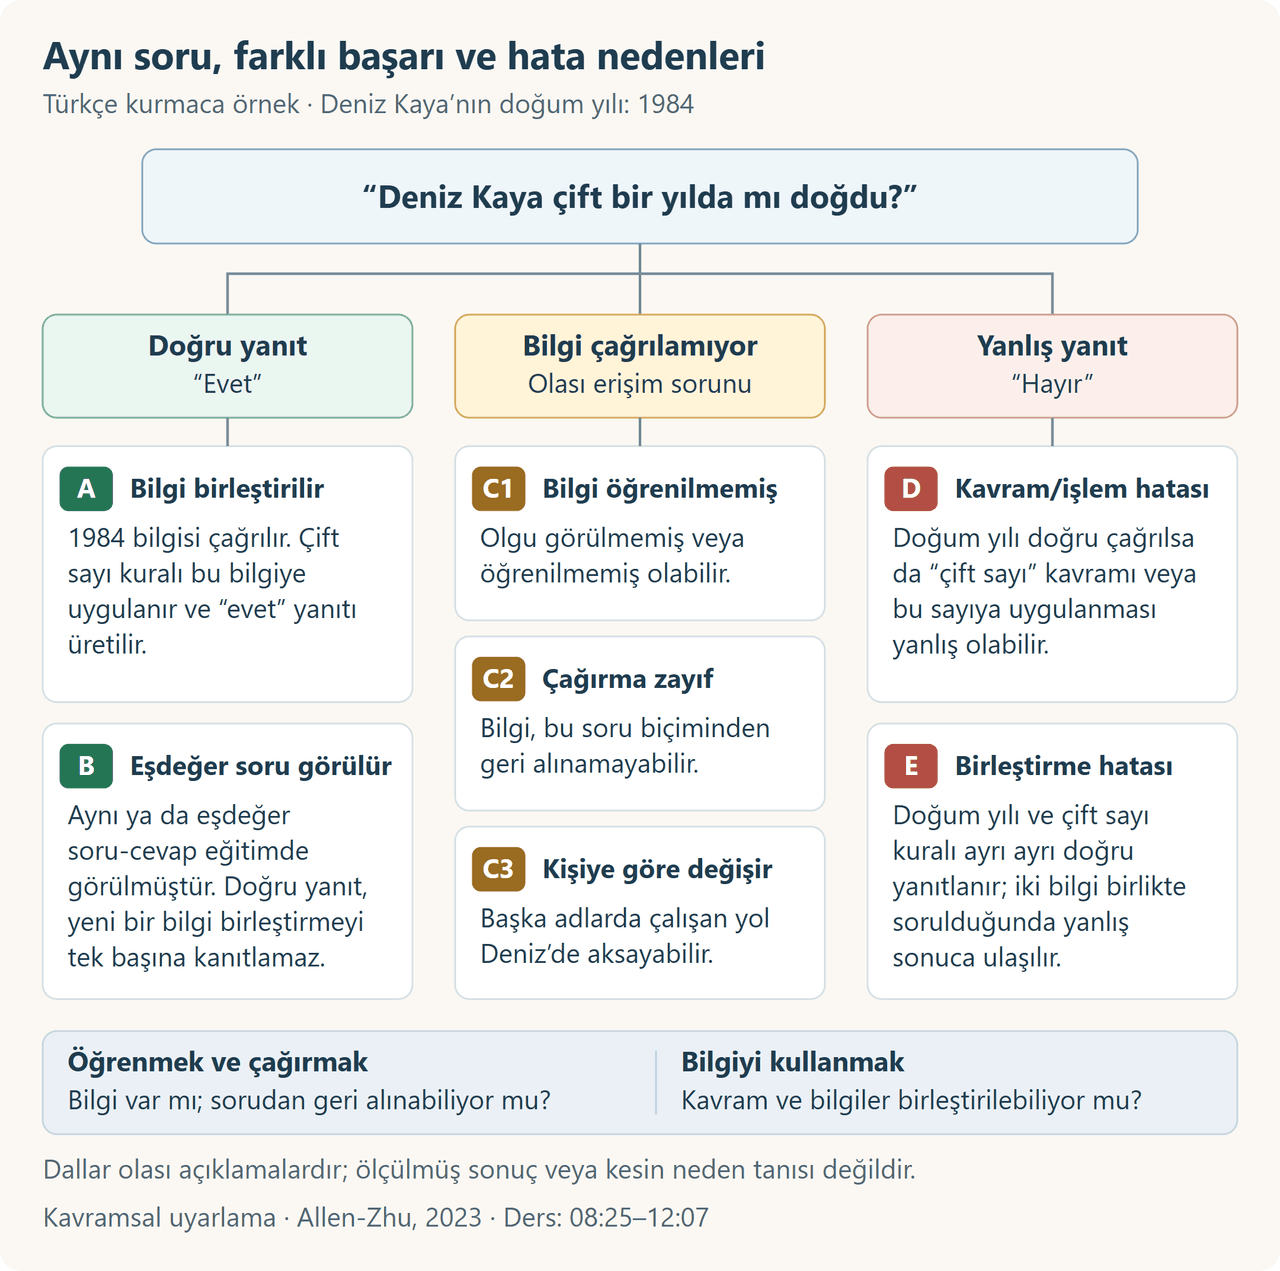
Bilgiyi Öğrenme, Çağırma ve Kullanma (Yapay Zekâ ile Oluşturulmuştur.)
Eğitim açısından kritik nokta, aynı bilginin yalnız tekrar edilmesiyle farklı anlatım ve soru biçimlerinde kullanılabilir hâle gelmesinin eş tutulmamasıdır. Allen-Zhu ve Li’nin kontrollü, sentetik biyografi deneylerinde; bilginin farklı ifadelerle sunulması, cümle sırasının değiştirilmesi ve kişiyle ilişkisinin belirginleştirilmesi, sonraki soru-cevap görevlerinde bilgiyi çağırma başarısını etkiler.【10】 İkinci çalışmada ise çağırılabilen bilgi üzerinde basit bir sınıflandırma veya karşılaştırma yapılırken de güçlük yaşanabildiği gösterilir. Bu görevlerde uygun ara bilgilerin üretilmesiyle iyileşme görülmesi, her modelde her halüsinasyonun aynı yolla giderileceği anlamına gelmez.【11】
Kendi değerlendirme düzenimizde bu ayrım üç kısa kontrolle somutlaştırılabilir: Önce “Deniz Kaya hangi yıl doğdu?”, ardından “1984 çift midir?”, son olarak iki bilgiyi birleştiren soru sorulur. Ayrı sorular doğruyken birleşik sorunun yanlış yanıtlanması, araştırılması gereken yerin bilgi birleştirme aşaması olabileceğini düşündürür. Soru biçimleri, kişi adları ve görülmemiş örnekler değiştirilerek bu örüntü sınanmalıdır. Bu kontroller olası hata alanını daraltır; ağırlıklarda hangi bilginin nasıl saklandığını tek başına kanıtlamaz.
İstiklal Marşı denememizde aynı ağırlıklardan doğru metnin alınabilmesi de bu çerçevede ele alınmalıdır. Gözlediğimiz sonuç, başarısız bir cevabın modelin kullanılabilir kapasitesini bütünüyle tanımlamadığını gösteren görev özelinde bir bulgudur. Ancak hangi eğitim örneğinin görüldüğü veya hangi iç mekanizmanın başarıyı belirlediği bu sonuçtan tek başına çıkarılamaz. İstem çeşitleri, tekrarlı çalıştırmalar ve kaynak metin içermeyen kontrol koşullarıyla yorumun kapsamı araştırılmalıdır.
Bir soru, gerçekte var olmayan bir kitabın özetini isteyebilir. Model, önce kitabın varlığını sorgulamak yerine özetleme biçimine uyum sağlarsa tüm yanıt yanlış bir öncülün etrafında kurulabilir. Benzer biçimde uzun bir çözümdeki yanlış ara sonuç, sonraki adımların kendi içinde tutarlı ama bütünüyle yanlış olmasına yol açabilir.
Burada doğrulama, yalnız son cümlenin puanlanmasından ibaret olmamalıdır. Kaynak kimliği, ara hesap, varlık eşleştirmesi veya dayanak belgenin sürümü gibi hata taşıyan parçalar ayrıca denetlenebilir. Bir hesap makinesinin aritmetiği doğrulaması ile bir arama sisteminin yayının gerçekten var olduğunu göstermesi farklı araç katkılarıdır.
Yanlış cevap ile “bilmiyorum” yanıtının aynı şekilde puansız kaldığı bir değerlendirmede, belirsiz durumda tahmin yürütmek beklenen puanı artırabilir. Kalai ve arkadaşları, ön eğitimdeki istatistiksel hata nedenlerini ve değerlendirmelerin belirsizliği kabul etmek yerine tahmini ödüllendirebilmesini birlikte inceler. Buradan çıkan mühendislik sonucu, güvenilirliği yalnız doğru cevap oranına indirgememektir.【12】
Çekimserlik de tek başına amaç olamaz. Her soruyu reddeden bir sistem yanlış üretimi azaltabilir ama yararlı bir asistan olmaz. İstenen, cevaplanabilir soruları korurken riskli durumlarda doğrulama, yeniden üretim veya çekimserlik seçebilen bir politikadır.
Bir token için yüksek olasılık, o devamın modelin dağılımında güçlü olduğunu gösterir. Bu değer doğrudan “bu cümle gerçektir” olasılığı değildir. Birden çok doğru anlatımın bulunduğu durumda dağılım geniş olabilir. Buna karşılık modelin güçlü biçimde öğrendiği yanlış bir ilişki, yüksek olasılıkla üretilebilir.
Bu ayrımı bir üretim satırı üzerinde görmek yararlıdır. Aşağıdaki sözcük kartlarında, en olası devamın temsili olasılığı çubuklarla gösterilmiştir. Çubuğun kısalması, seçimin daha az baskın hâle geldiğini anlatır; renkler olgusal doğruluk etiketi değildir. Bu görünüm, özellikle sayı ve özel ad üretilirken hangi noktaların inceleneceğini sezdirir. Kartlar okunurluk için sözcük düzeyinde gösterilmiştir; gerçek model aynı sözcüğü birkaç token’a ayırabilir.
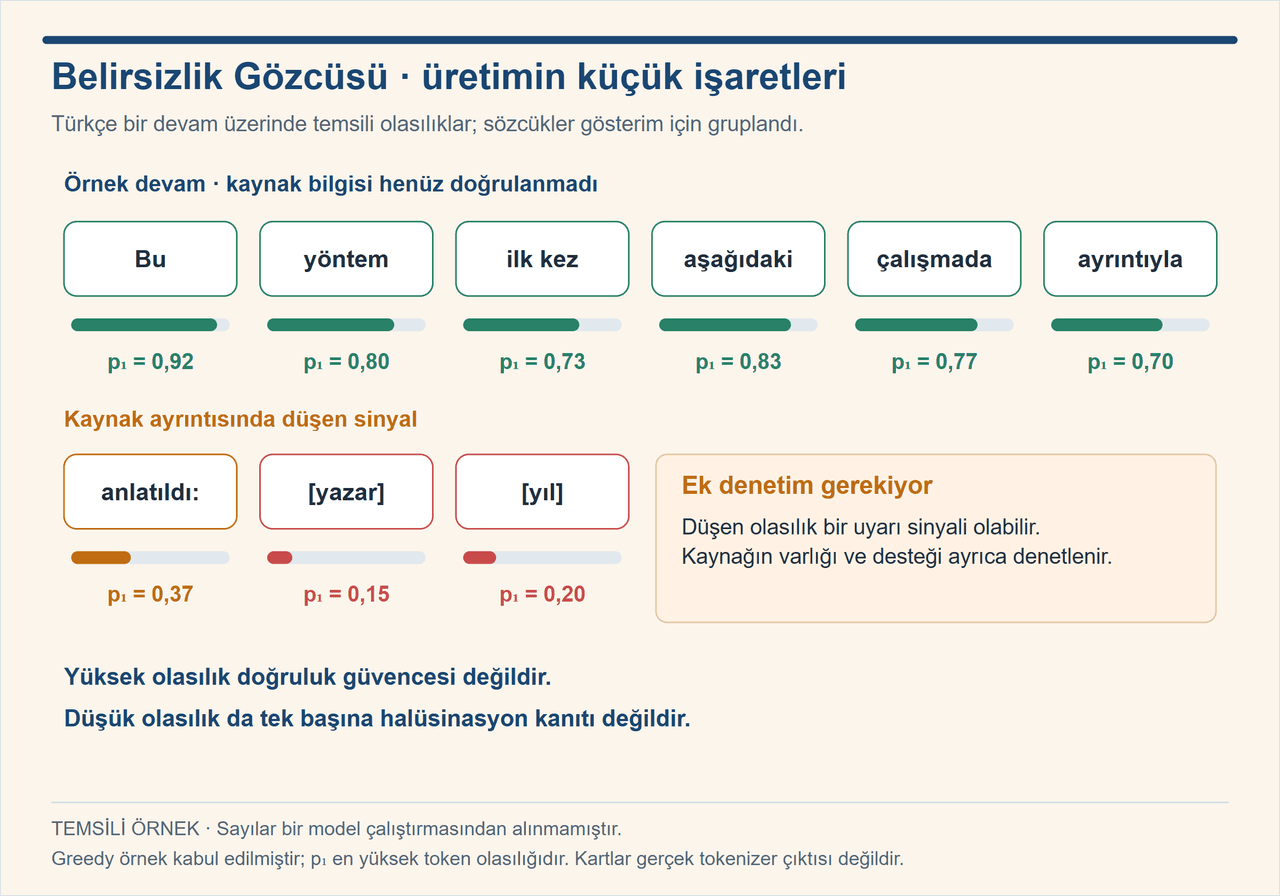
Belirsizlik Gözcüsünün Sözcük Kartları (Yapay Zekâ ile Oluşturulmuştur.)
Belirsizlik gözcüsü bu tür sinyalleri kaydeder. Müdahalenin gerekip gerekmediği sonraki politika katmanının işidir. Böylece bir olasılık düşüşü ile yanlış cevaba hükmetmek arasındaki adım görünür kalır.
Üretim telemetrisinde en olası token’ın olasılığı p₁, ikinci token’ın olasılığı p₂ ve aralarındaki marj izlenebilir.
Denklem 3: Olasılık Marjı
Entropi ise tek bir adımda dağılımın ne kadar yaygın olduğunu özetler:
Denklem 4: Token Entropisi
Yüksek entropi alternatiflerin birbirine yakın olduğunu gösterebilir; bunun nedeni bilgi eksikliği, dilsel çeşitlilik veya zor bir üretim noktası olabilir. Düşük entropi de modelin yanlış bilgiden emin olmasını dışlamaz. Ayrıca tokenizer, sıcaklık, logit müdahaleleri ve metin bölgesi bu değerleri değiştirir. Başka modelde ayarlanmış bir eşik, aynı anlamı taşımadan yeni modele aktarılabilir.
Üç adayın bulunduğu yapay bir üretim adımında olasılıklar 0,70, 0,20 ve 0,10 olsun. İlk iki aday arasındaki marj 0,50; doğal logaritmayla hesaplanan entropi yaklaşık 0,802 nat’tır. Daha yaygın bir dağılımda olasılıklar 0,40, 0,35 ve 0,25 seçilirse marj 0,05’e düşer, entropi yaklaşık 1,081 nat’a çıkar. İkinci dağılımda seçimin daha kararsız olduğu söylenebilir; doğru adayın hangisi olduğu ise bu sayılardan öğrenilemez.
Tablo 2: İki Yapay Token Dağılımında Marj ve Entropi
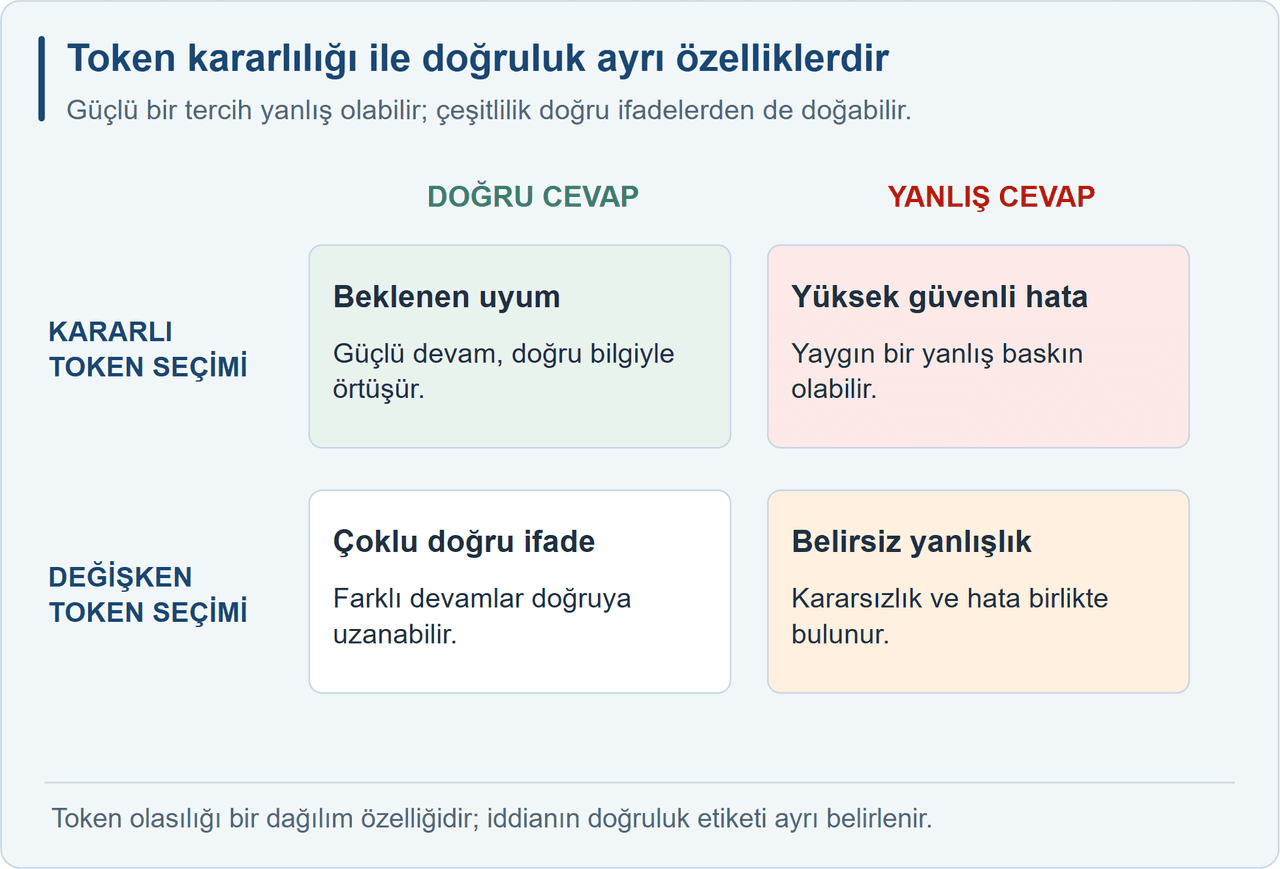
Token Kararlılığı ve Cevap Doğruluğu (Yapay Zekâ ile Oluşturulmuştur.)
Bu sayılar herhangi bir modelden alınmış deney sonucu değildir. Baskın aday yanlış bir özel ad olabilir; yakın olasılıklı farklı başlangıçlar ise aynı doğru cevaba uzanabilir. Gerçek bir tokenizer’ın sözcükleri kaç parçaya böldüğü de sonucu değiştirir. Bu nedenle monitörün token düzeyindeki kararsızlığı ölçtüğü, doğruluk etiketinin ise görev düzeyinde ayrı belirlendiği unutulmamalıdır.
Kalibrasyon farklı bir soruyu cevaplar: Sistem benzer örneklere belirli bir güven verdiğinde, bu güven gözlenen doğrulukla uyuşuyor mu? Doğru cevapları yanlışlardan iyi sıralayan bir skor yine de olasılık olarak yanlış kalibre edilmiş olabilir. Bu nedenle sıralama başarısı, olasılık uyumu ve karar eşiğinin etkisi ayrı ölçülmelidir.
Türkçe için eklemeli yapı, özel adların farklı token’lara bölünmesi ve yazım çeşitleri de dikkate alınmalıdır. Bir sözcüğün birkaç parçayla üretilmesi sırasında görülen düşük token olasılığı, o sözcük hakkındaki bilginin yanlış olduğunu tek başına göstermez. Bu, Türkçe için ayrı eşik ve hata analizi yapmayı gerektiren bir tasarım gerekçesidir; bütün Türkçe modeller hakkında ölçülmüş bir başarısızlık oranı değildir.
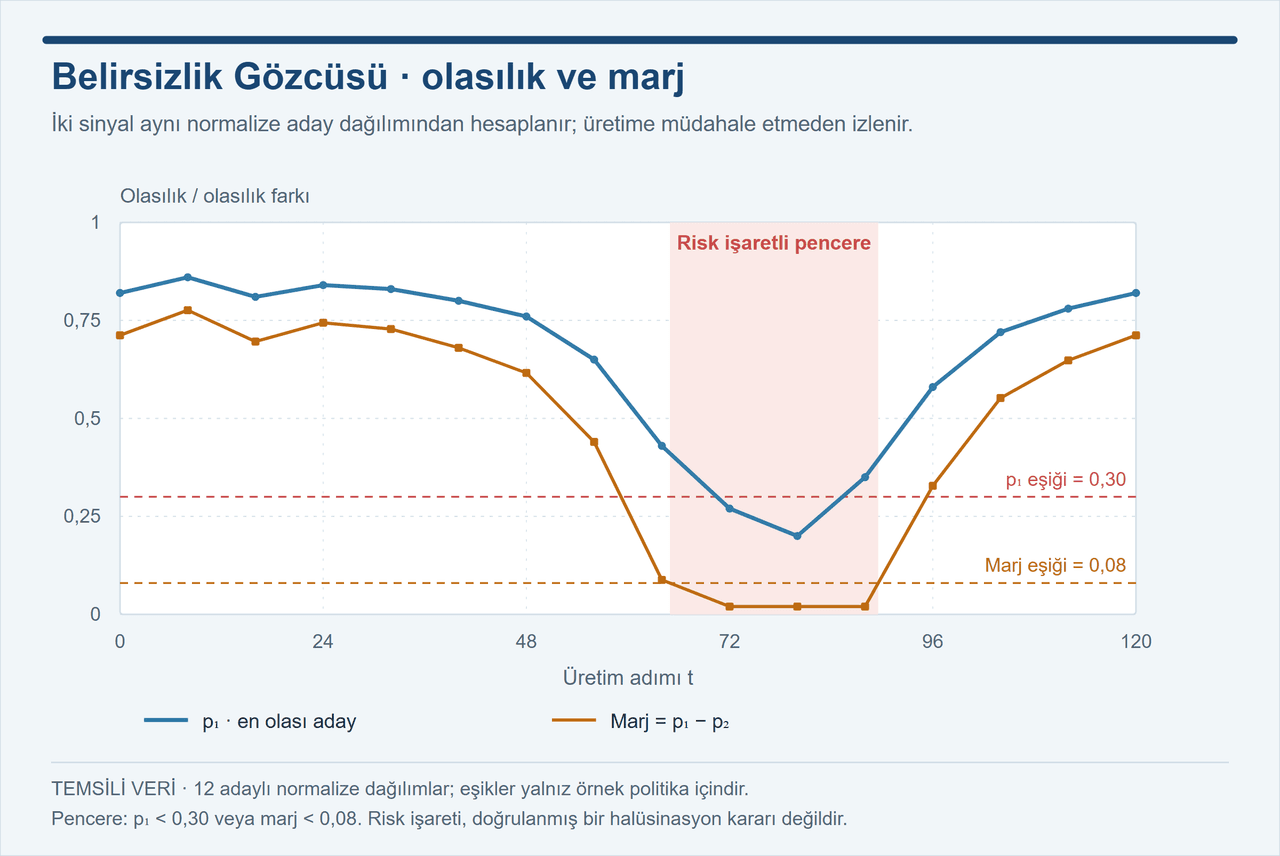
Token Olasılığı ve Marjının Değişimi (Yapay Zekâ ile Oluşturulmuştur.)
Tek bir adımın dağılımı anlık bir fotoğraftır; üretim boyunca çizilen eğri ise kararsızlığın ne zaman başladığını ve ne kadar sürdüğünü gösterir. Aşağıdaki örnekte en yüksek olasılık ile marj aynı normalize edilmiş, sentetik token dağılımlarından hesaplanmıştır. Taralı bölüm, tanımlanan eşik kuralına uyan adımları gösterir; bu alan bir halüsinasyon etiketi olarak kullanılmamıştır.
Eğriyi okurken üç soru ayrılır: Dağılım ne kadar kararsız, bu kararsızlık kaç adım sürüyor ve görev açısından hangi iddia üretiliyor? İlk iki soru telemetriyle yanıtlanabilir; üçüncüsü için görev bilgisi veya kanıt gerekir. İkinci bölümde söz süzgecinin bu ölçümleri müdahale kararına nasıl bağladığı açıklanmaktadır.
Getirim destekli üretim (retrieval augmented generation, RAG), cevabı yalnız parametrik bilgiye dayandırmak yerine ilgili dış belgeleri bağlama ekler. Lewis ve arkadaşlarının çalışması, parametrik model ile erişilebilir dış belleği bir araya getiren bu yaklaşımın temel örneklerindendir. Kaynak kullanımı, güncel veya alana özgü bilgiye erişim sağlayabilir.【13】
Ancak belge getirmek ile iddiayı doğrulamak aynı adım değildir. Getirilen belge yanlış, eski, konu dışı veya soruya yalnız kısmen ilişkin olabilir. Model ayrıca doğru belgeyi yanlış yorumlayabilir. Bu yüzden kaynak kimliği, ilgili pasaj, iddianın kapsamı ve zaman bilgisi birlikte korunmalıdır. Cevabın sonuna bir URL eklemek, bütün cümlelerin o kaynakla desteklendiğini göstermez.
Belgeye dayalı kısa bir örnek bu ayrımı gösterir. Kaynak yalnızca “Başvuru 15 Mayıs’ta kapanır” diyorsa, cevapta sonuçların da aynı gün açıklanacağını söylemek kaynakta olmayan bir takvim ilişkisi eklemektir. Sistem, doğrudan desteklenen kapanış tarihini aktarabilir; sonuç açıklama tarihi için bilgi bulunmadığını belirtmelidir. Bu örnek temsili bir görevdir, proje deneyinden alınmış bir ham çıktı değildir.
Bu ayrımı üç iddiaya açmak daha açıklayıcıdır. Öğretici örneğin belgesinde yalnız “Son başvuru günü 15 Mayıs” ifadesi bulunsun. “Son başvuru günü 15 Mayıs” doğrudan desteklenir. “Son başvuru günü 16 Mayıs” belgeyle çelişir. “Sonuçlar 15 Mayıs’ta açıklanır” ise belgede bulunmayan bir iddiadır. Son iddianın yanlışlığı henüz gösterilmemiştir; kaynakta desteklenmediği gösterilmiştir. Bu üç durumun farklı etiketlenmesi, denetleyicinin hem gerçek yanlışları hem gereksiz bastırmaları daha doğru analiz etmesini sağlar.
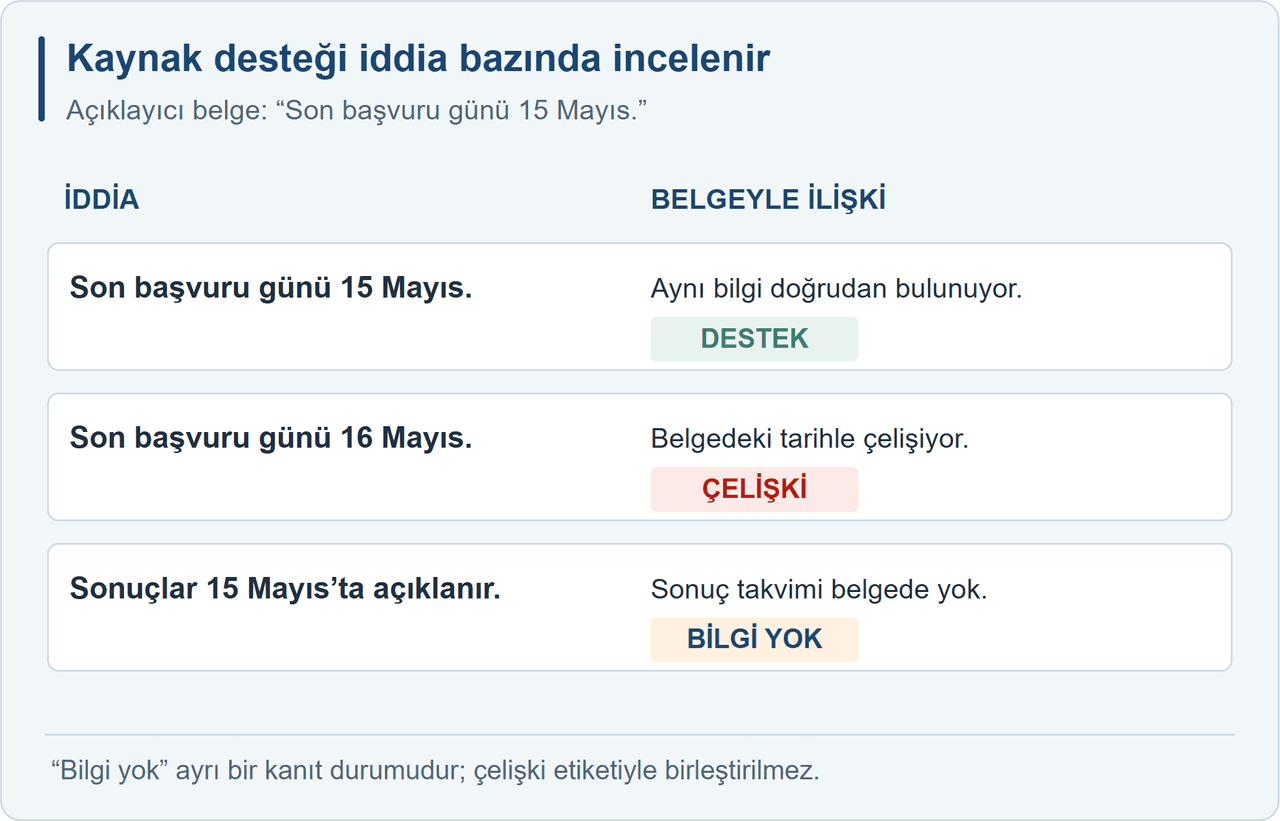
Belgeye Dayalı İddia Türleri (Yapay Zekâ ile Oluşturulmuştur.)
Türkçe bir bilgi sorusunda kaynak uydurma da benzer biçimde ayrıştırılabilir. Kullanıcı belirli bir yöntemin ilk Türkçe yayını ile DOI numarasını istediğinde, model akademik görünümlü bir künye üretebilir. Denetimin ilk işi başlığın, yazarların, yayın yılının ve tanımlayıcının gerçekten aynı esere ait olduğunu sınamaktır. İkinci iş, bulunan eserin ilgili iddiayı gerçekten destekleyip desteklemediğini kontrol etmektir. Var olan bir DOI’yi konu dışı bir yayına bağlamak, yalnız varlık kontrolünden geçebilen başka bir yanlışlıktır.
Bu nedenle kaynak doğrulama iki kapıdan oluşur: önce kaynağın kimliği, sonra iddia ile pasaj arasındaki destek ilişkisi. Bir aramanın sonuç vermemesi, yayının kesinlikle bulunmadığını kanıtlamaz. Elde yeterli kanıt yoksa sistemin vereceği doğru tepki, doğrulanmış bir künye gibi sunmak yerine bu sınırı açık bırakmak veya ek doğrulama istemektir. Bu örnekler yöntemi açıklamak için kurulmuştur; projeden alınmış ham model cevapları değildir.
Bir entegrasyonun ilk çıktısı, hangi durumda cevabın kabul edileceğini belirleyen kısa bir görev sözleşmesidir. Özgün şiiri aktarma, belgeden tarih bulma ve açık uçlu açıklama yapma aynı doğrulayıcıyla ölçülmez. İstiklal Marşı görevinde istenen çıktı iki kıtanın özgün dizeleridir; bir sözcüğün eş anlamlısını yazmak da sadakat hatasıdır. Belge sorusunda ise aynı anlam farklı cümlelerle doğru ifade edilebilir. Önce bu ayrım yapılır, sonra denetleyici seçilir.
Belge örneğinin uçtan uca uygulanışı da aynı sözleşmeyle tanımlanabilir. Uygulama “Son başvuru günü ne zaman?” sorusuna, kimliği ve sürümü saklanan belgenin “Son başvuru günü 15 Mayıs” pasajından cevap üretecektir. Üreticinin girdisi soru, ilgili pasaj ve çıktı biçimidir. Değerlendiricinin kaydı ise üretilen iddia, pasajın tam konumu ve destek etiketidir. Cevap “Başvuru 15 Mayıs’ta kapanır” olduğunda tarih iddiası desteklenir. Cevaba “Sonuçlar da aynı gün açıklanır” eklenirse ikinci iddia için bilgi yoktur. Birinci iddianın doğruluğu, ikincinin kanıt eksikliğini gidermez.
Sözleşmede ayrıca kanıtın yeterli sayılacağı koşul, eksik bilgiye verilecek yanıt ve çekimserliğin biçimi bulunur. Belgeyle sınırlı bir asistan, tarih bilgisi olmayan pasaj karşısında tarih tahmin etmemelidir. Kullanıcıya “Verilen belgede son başvuru tarihi bulunmuyor” diyebilir. Açık bilgi görevinde ise ek kaynak arama izni varsa önce o yol denenebilir. Bu kararlar ürün davranışını belirler; yalnız istemin sonuna “Emin değilsen söyle” eklemekten daha açık bir kontrol sağlar.
Başlangıç için küçük fakat çeşitli bir görev kümesi hazırlanabilir: doğrudan desteklenen iddialar, kaynağa ters tarihler, kaynakta bulunmayan ayrıntılar ve yanlış öncüllü sorular birlikte yer alır. Her örneğe beklenen karar da eklenir. Böylece yalnız doğru cevabı bulan sistem değil, eksik kanıtta uygun biçimde duran sistem de ölçülebilir. Örnek sayısı hedef hata oranı hakkında sonuç çıkarmaya yetmiyorsa çalışma bir ön deneme olarak raporlanır.
Aynı soru için farklı cevaplar üretmek, modelin hangi noktalarda kararsız kaldığını gösterebilir. Fakat sözcük düzeyindeki farklılık ile anlam düzeyindeki uyuşmazlık ayrılmalıdır. “Ankara” ve “Türkiye’nin başkenti Ankara’dır” farklı metinler olsa da aynı temel cevabı taşır. Anlamsal entropi, üretimleri anlam kümelerinde değerlendirerek bu ayrımı ele alır.
Çok sayıda adayın aynı cevabı vermesi yine de doğruluk garantisi değildir. Ortak bir yanlış bilgi, bütün adaylarda tekrarlanabilir. İstiklal Marşı görevinde farklı adayların aynı uydurma dize üzerinde anlaşması mümkündür. Dolayısıyla çoklu üretim, kaynak doğrulamasını veya bağımsız hata analizini ortadan kaldırmaz; ek hesaplama maliyeti karşılığında başka bir gözlem kanalı sağlar.
Modelin gizli durumları ve dikkat örüntüleri, yalnız seçilmiş token’dan daha zengin bilgi taşıyabilir. Gnosis’in özgün çalışmasında, donmuş modellerin iç izlerinden doğruluk tahmini elde etmek için küçük bir öğrenilmiş yapı kullanılır. Gizli durum ve dikkat akışlarının özetleri bu yapıda birleştirilir.【14】 Özsezi için tasarladığımız doğruluk başlığında kullanılan özellikler ve özgün çalışmadan ayrılan noktalar ikinci bölümde açıklanmaktadır.
Bu tür bir başlık, doğruluk için eğitilmiş bir kestiricidir. Verdiği skor, eğitim etiketlerinin ve değerlendirme dağılımının sınırlarını taşır. Bir model ailesinde veya görev türünde yararlı olan sinyal, başka aileye veya üretim biçimine aynı başarıyla aktarılmayabilir. Yanıtı değerlendiren sistemin de hata yapabileceği kabul edilmeden güvenilir bir karar politikası kurulamaz.
Logits işlemcileri, bir sonraki token seçilmeden önce dağılıma müdahale eder. Düşük güven devam ettiğinde üretimi bitirmek, alternatif bir token’a yönlendirmek veya güvenli bir geri dönüş ifadesi kullanmak mümkündür. NVIDIA logits processor zoo bu tür müdahaleler için bir uygulama yüzeyi sunar; sınıf adındaki “halüsinasyon önleme” ifadesi tek başına olgusal doğruluk güvencesi değildir.【15】
Aktivasyon sınırlama başka bir düzeyde çalışır: Gizli temsil, belirli bir davranış doğrultusunda sınırlandırılır. Assistant Axis çalışması, asistan kişiliğinin kaymasını inceleyip bu doğrultudaki müdahalelerle davranış kararlılığı sağlamayı hedefler. Bu yaklaşımı bir kaynak doğrulayıcısı gibi sunmak doğru olmaz; olgusal katkısı, hedeflenen uygulamada ayrıca değerlendirilmelidir.【16】
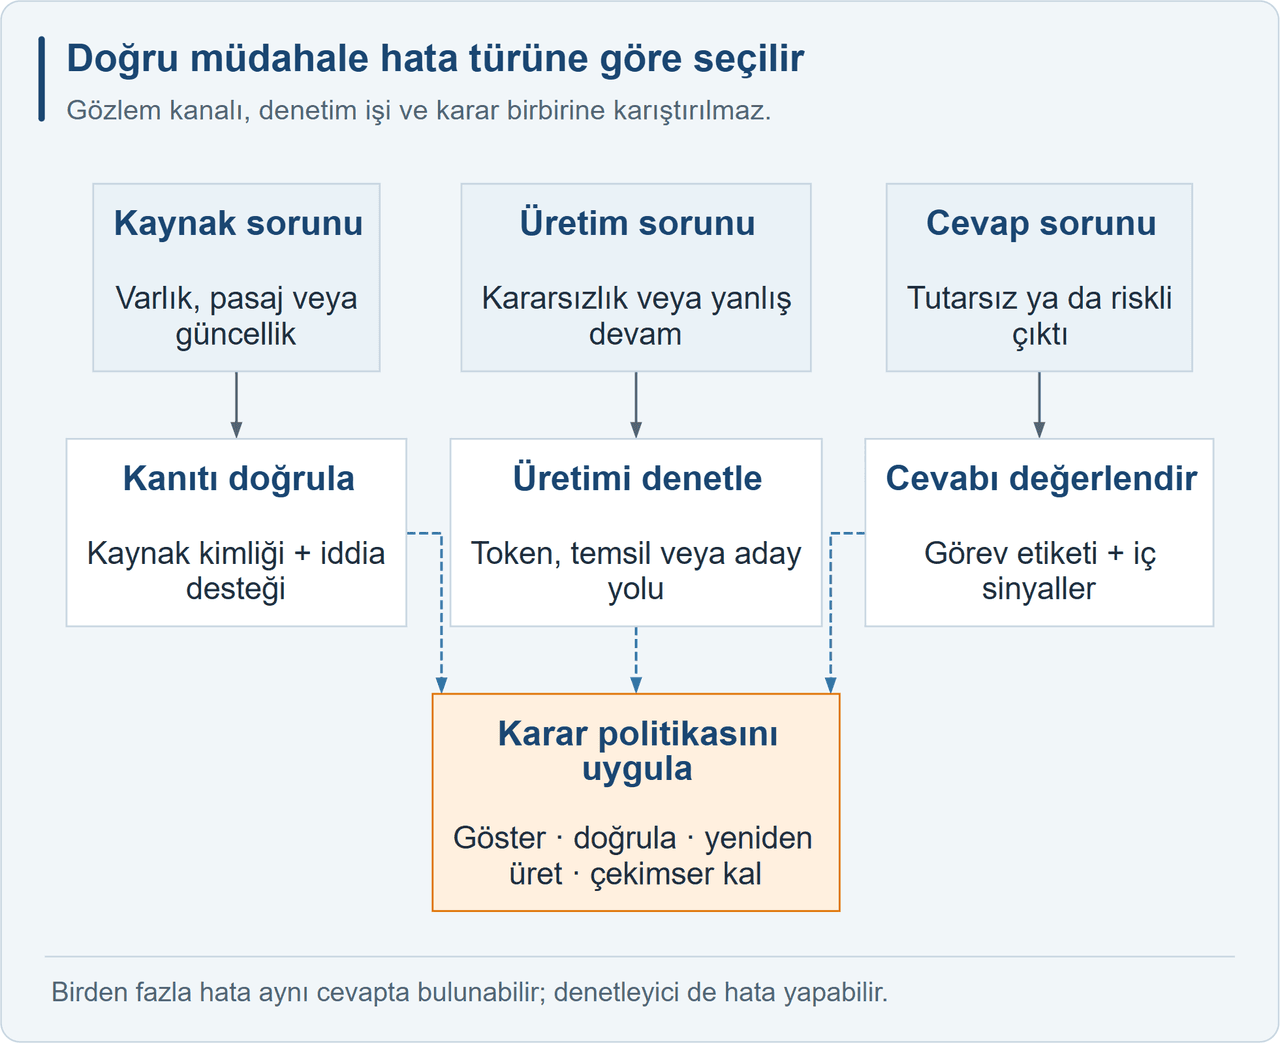
Tespit Sinyalleri ve Kontrol Eylemleri (Yapay Zekâ ile Oluşturulmuştur.)
ZIP-RC ise bir üretim önekinin sonundaki ödül ve kalan uzunluk hakkında tahminler üretir. Bu sinyaller, hangi yola devam edileceğini, hangi yolun budanacağını veya ne zaman yeni bir aday başlatılacağını belirlemek için kullanılabilir. Özgün yöntemin ek ileri geçiş gerektirmemesi, aday üretimi ve kontrol mantığının toplam maliyetinin sıfır olduğu anlamına gelmez.【17】
Özsezi tasarımımızda bu araştırmalardan yararlanılarak sinyaller aynı üretim zincirinde birleştirildi; müdahale sırası tanımlandı, düşünme ve nihai cevap bölgeleri için farklı eşikler ele alındı ve son karar kanıt bağlamıyla ilişkilendirildi. Kaynak yöntemlerin hedef uygulamamızdaki gereksinimleri tek başlarına karşılamadığı noktalarda uyarlamalar geliştirildi. İkinci bölümde, hangi fikrin hangi çalışmadan alındığı ve mimarimizde nasıl tamamlandığı somutlaştırılmaktadır.
Bir tespit sistemi için pozitif sınıfın ne olduğu açıkça yazılmalıdır. Pozitif sınıf “yanlış cevap” ise yüksek skorun yanlışlık mı doğruluk mu gösterdiği metrik kodunda tutarlı tutulmalıdır. AUROC farklı eşiklerdeki sıralamayı özetler; AUPRC ise seçilen pozitif sınıfın yaygınlığına duyarlıdır. Bu nedenle sınıf tanımı ve örneklerin dağılımı verilmeden metrikler karşılaştırılmamalıdır.
Doğruluk olasılığı tahminleri için Brier skoru şu biçimdedir:
Denklem 5: Brier Skoru
Burada yᵢ doğru cevap için 1, yanlış cevap için 0’dır. Skor hem hatalı güveni hem de yanlış tahminleri cezalandırır; tek başına bütün kalibrasyon özelliklerini açıklamaz. Tahmin edilen güven skorlarına göre bölmelere ayrılmış güvenilirlik diyagramları ve görev bazındaki sonuçlar ek bilgi sağlar. Kalibrasyon verisi, karar eşiğinin seçildiği veri ve nihai test verisi arasındaki ayrım da korunmalıdır.
Karar politikasının başarısı için kapsama oranı, sistemin cevap verdiği isteklerin tüm isteklere oranıdır. Seçici risk ise cevaplanan alt kümedeki hata oranını gösterir.
Denklem 6: Kapsama Oranı ve Seçici Risk
aᵢ, sistem i numaralı isteğe cevap verdiğinde 1’dir. Hiç cevap verilmezse ikinci ifadenin paydası sıfırdır; risk değeri otomatik olarak sıfır başarı diye raporlanamaz. Yanlış cevap oranının düşmesi, çok daha fazla sorunun reddedilmesiyle elde edildiyse bu bedel görünür olmalıdır.
Aşağıdaki altı cevap, ölçütleri açıklamak için yapay olarak seçilmiştir. Her satırda sabit bir aday cevap, ona verilen doğruluk skoru ve bağımsız referans değerlendirmesi vardır. Bu tablo Özsezi'nin veya Gemma modellerinin başarısını bildirmez.
Tablo 3: Eşik Hesabında Kullanılan Altı Yapay Aday
Skoru en az 0,80 olan cevaplar gösterilirse ilk üç satır seçilir. Kapsama 3/6, yani yüzde 50’dir. Seçilen üç cevabın biri yanlış olduğundan seçici risk 1/3, yaklaşık yüzde 33,3 olur. Eşik 0,60’a indirildiğinde dördüncü cevap da seçilir: Kapsama 4/6, yaklaşık yüzde 66,7; risk ise 1/4, yüzde 25 olur. Bu küçük kümede eşiği gevşetmek riski düşürmüştür; çünkü yeni kabul edilen cevap doğrudur. Sonlu bir örnek kümesinde riskin eşikle her zaman tek yönde değişeceği varsayılamaz.
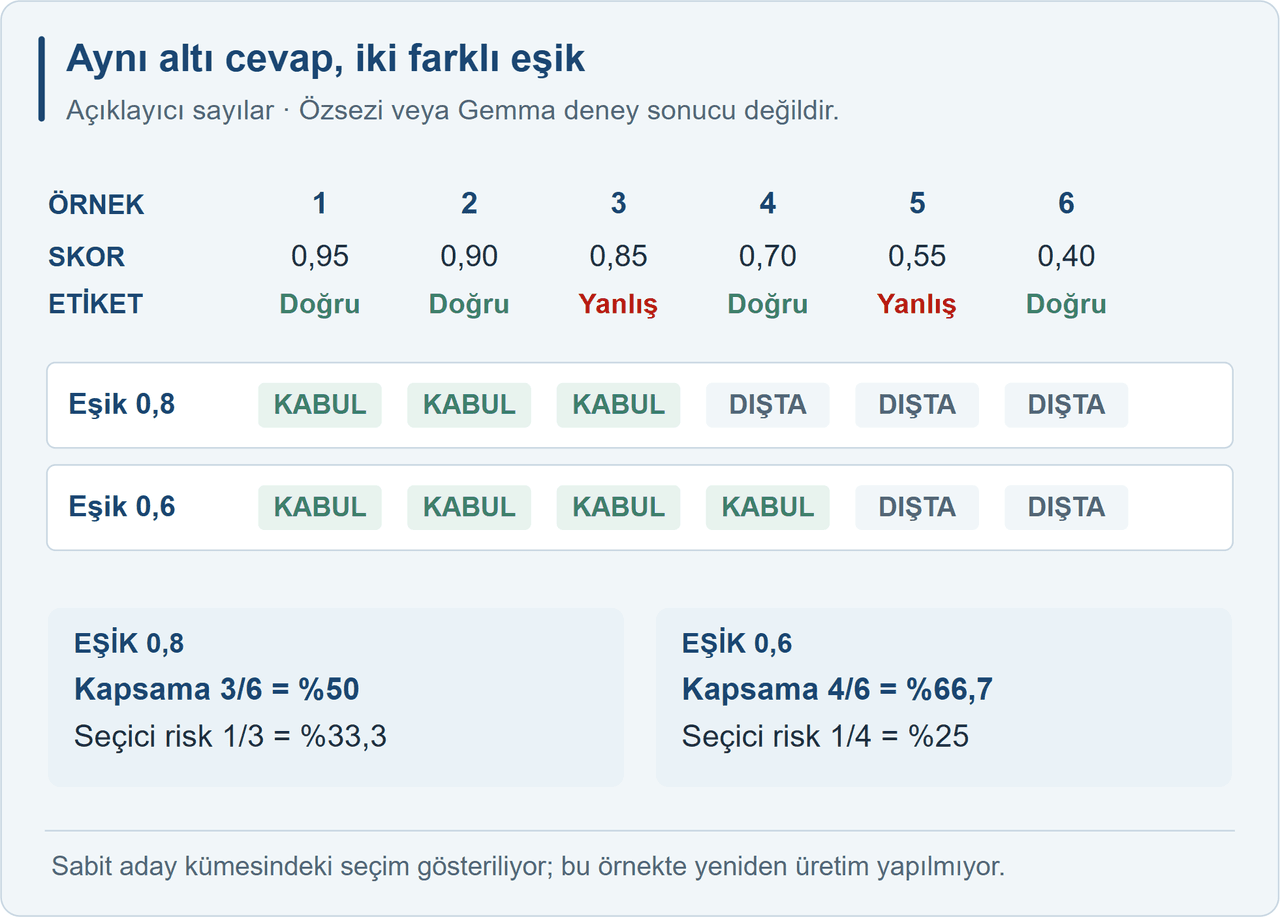
Karar Eşiği, Kapsama ve Risk (Yapay Zekâ ile Oluşturulmuştur.)
Aynı altı skorun Brier hesabında her satırın tahmini ile 0 veya 1 etiketi arasındaki farkın karesi alınır. Kare hataların toplamı 1,4875; altıya bölümü yaklaşık 0,2479’dur. Tek bir yüksek güvenli yanlış cevap olan üçüncü satır, tek başına 0,7225 katkı yapar. Bu örnek, doğru ile yanlışı sıralama, olasılıkların kalibrasyonu ve seçilen eşikteki karar başarısının neden ayrı sorular olduğunu gösterir.
Yanlış bastırmayı değerlendirirken payda da açık olmalıdır. Burada toplam dört doğru aday vardır. Eşik 0,80 iken bunlardan ikisi, 0,60 iken biri gösterilmez. Bu sabit aday kümesinde doğru cevapların bastırılma oranları sırasıyla 2/4 ve 1/4’tür. Üretimi de değiştiren bir müdahalede ise aynı soru için yeni bir aday oluşabilir; o deneyde ham aday doğruluğu ile kullanıcıya gösterilen cevabın doğruluğu ayrıca saklanmalıdır.
Tablo 4: Birlikte Raporlanacak Kalite ve Maliyet Ölçütleri
İstiklal Marşı gibi birebir aktarım görevlerinde ayrıca dize bazında doğruluk, dize sırası ve eksik ya da ek içerik ölçülebilir. Noktalama ve Unicode normalizasyonu önceden belirlenmeli; normalizasyon, yanlış sözcükleri doğruya dönüştürecek kadar geniş tutulmamalıdır. Yakın anlamlı bir dize, görev özgün metni istediği için doğru kabul edilmez.
Bir sonraki deneyde iki modelin müdahalesiz koşulları ve küçük modelin müdahaleli koşulları aynı görev kümesinde tekrarlanmalıdır. Tam bileşim yanında bileşenlerin tek tek çıkarıldığı koşullar da bulunmalıdır. Tek bir şiirden genel sonuç çıkarmamak için farklı uzunluktaki sabit metinler, olgusal sorular ve belgeye dayalı görevler eklenebilir. Başarı oranları, tekrar sayıları ve maliyetler birlikte raporlandığında ana vakanın ne ölçüde genellendiği anlaşılabilir.
Eşik seçimi, en yüksek doğruluk yüzdesini tek başına aramak değildir. Önce uygulamanın kabul edeceği cevaplanan-küme riski, doğru cevabı bastırma payı ve gecikme sınırı tanımlanır. Amaç, bu sınırları sağlayan politikalar arasında daha çok isteğe cevap verebilmektir. Örneğin θ; eşikler, sabır ve müdahale büyüklüğü gibi birlikte seçilen ayarları göstersin. Açıklayıcı bir seçim problemi şöyle yazılabilir:
Denklem 7: Kapsama Oranını En İyileme
Bu amaç aşağıdaki kısıtlarla birlikte değerlendirilir:
Denklem 8: Risk, Bastırma ve Gecikme Kısıtları
Burada ρ kabul edilen risk, η doğru cevapları bastırma sınırı, B ise yüzde 95’lik gecikme diliminin bütçesidir. FS’nin paydası bağımsız referansla doğru bulunan adaylardır. Sınırlar kullanım alanına göre belirlenir; bu yazıdaki 0,50 ve 0,80 gibi öğretici eşikler üretim önerisi değildir. Belirlenen sınırları sağlayan bir aday yoksa sonuç “Uygun politika bulunamadı”dır; nihai test üzerinde ayar değiştirilerek hedef sağlanmış gibi gösterilmez.
Uygulamada önce hazırlama verisinden kontrol varlıkları öğrenilir. Ayrı geliştirme verisinde aday politikalar denenir; kalibrasyon için yeterli veri varsa skor dönüşümüne de ayrılmış bir bölüm kullanılır. Yalnız son cevapları filtrelemek, değişmeyen aday kümesinde yeniden hesaplanabilir. Token veya aktivasyon müdahalesi ise cevabı değiştirdiğinden her aday politika gerçek üretim zinciriyle yeniden çalıştırılmalıdır. Ayarlar seçildikten sonra bütün varlıklar kilitlenir ve dokunulmamış test kümesinde bir kez değerlendirilir.
Sonuçlarla birlikte örnek sayısı ve belirsizlik aralıkları verilmelidir. Özellikle az sayıdaki kabul edilmiş cevapta hiç hata görülmemesi, gerçek riskin sıfır olduğu anlamına gelmez. Görev türlerine göre ayrılmış sonuçlar da gereklidir: şiir aktarımında işe yarayan bir eşik, Türkçe kaynaklı soru-cevapta aynı kapsamı korumayabilir. Bu yaklaşım, etkileyici tek bir örneği çalıştırılabilir bir mühendislik kararına dönüştürür.
Halüsinasyonun tek nedeni veya her görevde çalışan tek çözümü yoktur. Veri eksikliği, yanlış öncül, kaynakla uyuşmazlık ve üretim sırasında yanlış bir devamın güçlenmesi farklı müdahaleler gerektirir. Model büyüklüğü bu sorunların tümünü tek başına belirlemez. Kaynak erişimi, uygun denetleyici, kalibrasyon ve karar politikası da sistemin davranışını değiştirir.
İstiklal Marşı vakasının önemi, aynı küçük modelin değiştirilmemiş ağırlıklarıyla doğru çıktıya ulaşılabilmesidir. Bu gözlem, yanlış bir cevabın her zaman yalnız bilgi yokluğuyla açıklanamayacağına işaret eder. Serinin ikinci bölümü, Özsezi ile üretim denetimi, bu ayrımdan hareketle Söz Süzgeci, Yön Dengesi ve Yol Sezgisinin aynı üretim döngüsünde nasıl birleştiğini açıklar. Doğruluk başlığı, çoklu üretim ve nihai karar katmanları da geniş mimari içindeki yerleriyle ele alınır.
Aşağıdaki sözde kodda, yöntemin sınanması için önerdiğimiz değerlendirme düzeni açıklanmaktadır. Bu akış bir deney sonuç kaydı olarak sunulmamaktadır. Müdahalesiz temel koşulun ham cevabı ile müdahaleli cevap ayrı saklanır. Referans yalnız değerlendirmede kullanılır; kaynak metinsiz koşulda modele verilmez.
Tablo 5: Algoritma 1-Değerlendirme Düzeni
Bu düzenin kritik özelliği, başarısız cevapları veya erken durdurulan denemeleri veri dışına atmamasıdır. Yalnız başarılı örneklerin gösterilmesi, kontrol politikasının yararını olduğundan büyük gösterebilir. Aynı nedenle en iyi görünen istemin sonradan seçilmesi, keşif aşaması ile doğrulama aşamasının ayrılmasını gerektirir.
Bu ilk bölüm, halüsinasyonu azaltmak için önce doğru cevabın tanımlanması, belirsizlik sinyallerinin görev doğruluğundan ayrılması ve müdahalenin kapsam ile maliyetinin birlikte ölçülmesi gerektiğini ortaya koydu. Açık kalan uygulama sorusu, bu ilkelerin çalışan bir üretim düzenine nasıl dönüştürüleceğidir.
Serinin devamı olan Dil Modellerinde Halüsinasyon Bölüm 2: Özsezi ile Üretim Denetimi, bu soruyu İstiklal Marşı vakasına dönerek ele alır. Söz Süzgeci'nin token seçimine, Yön Dengesi'nin iç temsile ve Yol Sezgisi'nin üretim yoluna nasıl müdahale ettiği adım adım açıklanır. Hangi model erişiminin gerektiği, kontrol sırasının nasıl kurulduğu ve riskli bir devamın kullanıcıya gösterilmeden nasıl sonlandırıldığı somutlaştırılır.
Yöntemi kendi projesine taşımak isteyen okur için ikinci bölümde veri ve durum sözleşmeleri, karar akışı ve denetim katmanlarının entegrasyonu bir araya getirilir. İlk bölümde kurulan nedenler ve değerlendirme çerçevesi, böylece uygulanabilecek bir entegrasyon tasarımına dönüşür.
Allen-Zhu, Zeyuan ve Yuanzhi Li. “Physics of Language Models: Part 3.1, Knowledge Storage and Extraction.” Proceedings of the 41st International Conference on Machine Learning, PMLR 235 (2024): 1067–1077. Erişim 16 Kasım 2026. https://proceedings.mlr.press/v235/allen-zhu24a.html
Allen-Zhu, Zeyuan ve Yuanzhi Li. “Physics of Language Models: Part 3.2, Knowledge Manipulation.” arXiv 2023. Erişim 17 Kasım 2026. https://arxiv.org/html/2309.14402v2
Farquhar, Sebastian, Jannik Kossen, Lorenz Kuhn ve Yarin Gal. “Detecting Hallucinations in Large Language Models Using Semantic Entropy.” Nature 630 (2024): 625–630. Erişim 12 Kasım 2026. https://www.nature.com/articles/s41586-024-07421-0
Ghasemabadi, Amirhosein ve Di Niu. “Can LLMs Predict Their Own Failures? Self-Awareness via Internal Circuits.” arXiv 2026. Erişim 12 Kasım 2026. https://arxiv.org/html/2512.20578v2
Google DeepMind. “Gemma 4 31B IT.” Model kartı. Hugging Face. Erişim 12 Kasım 2026. https://huggingface.co/google/gemma-4-31B-it
Google DeepMind. “google/gemma-4-E4B-it.” Model kartı. Hugging Face. Erişim 12 Kasım 2026. https://huggingface.co/google/gemma-4-E4B-it
Huang, Lei, Weijiang Yu, Weitao Ma, vd. “A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions.” arXiv 2024. Erişim 17 Kasım 2026. https://arxiv.org/pdf/2311.05232v2
Kalai, Adam Tauman, Ofir Nachum, Santosh S. Vempala, vd. “Why Language Models Hallucinate.” arXiv 2025. Erişim 17 Kasım 2026. https://arxiv.org/html/2509.04664v1
Lewis, Patrick, Ethan Perez, Aleksandra Piktus, vd. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” arXiv 2021. Erişim 17 Kasım 2026. https://arxiv.org/pdf/2005.11401v4
Lu, Christina, Jack Gallagher, Jonathan Michala, vd. “The Assistant Axis: Situating and Stabilizing the Default Persona of Language Models.” arXiv 2026. Erişim 12 Kasım 2026. https://arxiv.org/html/2601.10387v1
Manvi, Rohin, Joey Hong, Tim Seyde, vd. “Zero-Overhead Introspection for Adaptive Test-Time Compute.” arXiv 2025. Erişim 12 Kasım 2026. https://arxiv.org/html/2512.01457v4
NVIDIA. “logits-processor-zoo.” GitHub. Erişim 12 Kasım 2026. https://github.com/NVIDIA/logits-processor-zoo
T.C. Millî Eğitim Bakanlığı. “TBMM’nde İstiklâl Marşı Görüşmeleri ve Kabulü.” Erişim 12 Kasım 2026. https://meb.gov.tr/istiklalmarsi/istiklalmarsi/Meclisten/Kabulu
Zeyuan Allen-Zhu, Sc.D. “Physics of LM: Part 3.1 + 3.2, Knowledge Storage, Extraction and Manipulation.” YouTube, 4 Kasım 2023. Erişim 16 Kasım 2026. https://www.youtube.com/watch?v=YSHzKmEianc
[1]
Lei Huang, Weijiang Yu, Weitao Ma, vd., “A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions,” arXiv 2024, 5-7, Erişim 17 Kasım 2026. https://arxiv.org/pdf/2311.05232v2
[2]
Huang, Yu, Ma vd., “A Survey on Hallucination in Large Language Models,” 5–7.
[3]
Google DeepMind, “google/gemma-4-E4B-it,” Model kartı, Hugging Face, Erişim 12 Kasım 2026. https://huggingface.co/google/gemma-4-E4B-it
[4]
Google DeepMind, “Gemma 4 31B IT,” Model kartı, Hugging Face, Erişim 12 Kasım 2026. https://huggingface.co/google/gemma-4-31B-it
[5]
T.C. Millî Eğitim Bakanlığı, “TBMM’nde İstiklâl Marşı Görüşmeleri ve Kabulü,” Erişim 12 Kasım 2026. https://meb.gov.tr/istiklalmarsi/istiklalmarsi/Meclisten/Kabulu
[6]
Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala, vd., “Why Language Models Hallucinate,” arXiv 2025, Erişim 17 Kasım 2026. https://arxiv.org/html/2509.04664v1
[7]
Kalai, Nachum, Vempala vd., “Why Language Models Hallucinate.”
[8]
Zeyuan Allen-Zhu, Sc.D., “Physics of LM: Part 3.1 + 3.2, Knowledge Storage, Extraction and Manipulation,” YouTube, 4 Kasım 2023, Erişim 16 Kasım 2026. https://www.youtube.com/watch?v=YSHzKmEianc
[9]
Zeyuan Allen-Zhu, “Physics of LM: Part 3.1 + 3.2, Knowledge Storage, Extraction and Manipulation,” Youtube.
[10]
Zeyuan Allen-Zhu ve Yuanzhi Li, “Physics of Language Models: Part 3.1, Knowledge Storage and Extraction,” Proceedings of the 41st International Conference on Machine Learning, PMLR 235 (2024): 1067–1077, Erişim 16 Kasım 2026. https://proceedings.mlr.press/v235/allen-zhu24a.html
[11]
Zeyuan Allen-Zhu ve Yuanzhi Li, “Physics of Language Models: Part 3.2, Knowledge Manipulation,” arXiv 2023, Erişim 17 Kasım 2026. https://arxiv.org/html/2309.14402v2
[12]
Kalai, Nachum, Vempala, vd., “Why Language Models Hallucinate.”
[13]
Patrick Lewis, Ethan Perez, Aleksandra Piktus, vd., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,” arXiv 2021, 2-3, Erişim 17 Kasım 2026. https://arxiv.org/pdf/2005.11401v4
[14]
Amirhosein Ghasemabadi ve Di Niu, “Can LLMs Predict Their Own Failures? Self-Awareness via Internal Circuits,” arXiv 2026, Erişim 12 Kasım 2026. https://arxiv.org/html/2512.20578v2
[15]
NVIDIA, “logits-processor-zoo,” GitHub, Erişim 12 Kasım 2026. https://github.com/NVIDIA/logits-processor-zoo
[16]
Christina Lu, Jack Gallagher, Jonathan Michala, vd., “The Assistant Axis: Situating and Stabilizing the Default Persona of Language Models,” arXiv 2026, Erişim 12 Kasım 2026. https://arxiv.org/html/2601.10387v1
[17]
Rohin Manvi, Joey Hong, Tim Seyde, vd., “Zero-Overhead Introspection for Adaptive Test-Time Compute,” arXiv 2025, Erişim 12 Kasım 2026. https://arxiv.org/html/2512.01457v4

Halüsinasyon Hangi Hatayı Tanımlar?
İstiklal Marşı Denemesinde Görülen Ayrım
Dil Modelleme Hedefi Doğruluğu Nasıl Öğrenir?
Halüsinasyonu Besleyen Farklı Nedenler
Eksik ve Çelişkili Bilgi
Bilgiye Erişim ve İstem Biçimi
Yanlış Öncül ve Hata Birikimi
Tahmin Yürütmeyi Teşvik Eden Değerlendirme
Token Güveni ile Cevap Doğruluğu Neden Ayrılır?
Marj ve Entropiyi Küçük Bir Örnekte Okumak
Tespit ve Azaltma Yöntemleri Nasıl Tamamlanır?
Kaynak Destekli Üretim ve İddia Doğrulama
Kendi Uygulamasında Doğruluk Sözleşmesini Kurmak
Çoklu Cevap ve Anlamsal Belirsizlik
İç Temsillerden Doğruluk Sinyali Çıkarma
Üretim Sırasında Müdahale ve Hesaplama Kontrolü
Müdahalenin Yararı Hangi Ölçütlerle Anlaşılır?
Eşiğin Etkisini Aynı Cevap Kümesinde Hesaplamak
Eşik Bir Ürün Kısıtı Altında Nasıl Seçilir?
Çıkarım Sürecini Yönetmek Neden Önemlidir?
Ek Olarak, Örnek Bir Değerlendirme Akışı
İkinci Bölümde Özsezi ile Üretim Denetimi