Bu içerik Türkçe olarak yazılmış olup yapay zeka ile otomatik olarak İngilizceye çevrilmiştir.
Büyük Dil Modelleri (Large Language Model, LLM) eğitildikten sonra kullanıcı isteklerine yanıt üretmek üzere bir sunucuda çalıştırılır. Bu süreç çıkarım (inference), modelin istekleri alıp yanıt üretecek biçimde hizmete sunulması ise model servisi (model serving) olarak adlandırılır. Çıkarım sırasında yanıt, token (metnin model tarafından işlenen en küçük birimi) adı verilen parçalar hâlinde, her adımda bir token üretilerek oluşturulur. Her adım modelin ağırlıklarının GPU belleğinden okunmasını gerektirdiğinden üretim hızı genellikle bellek erişimiyle sınırlanır.
Servis edilen modellerde yanıt süresini kısaltmak ve aynı donanımla daha fazla isteği karşılamak için çeşitli hızlandırma yöntemleri kullanılır; ağırlıkların daha düşük sayısal duyarlılıkla tutulması, modelin birden fazla GPU'ya bölünmesi ve ara sonuçların önbelleğe alınması bunlar arasındadır.
Spekülatif kod çözme (speculative decoding) bu yöntemlerden biridir. Küçük ve hızlı bir taslak model (draft model) sıradaki birkaç token'ı önceden önerir; asıl model (hedef model, target model) bu önerileri tek bir ileri geçişte doğrular ve doğru olan kısmı kabul eder. Böylece hedef model her adımda birden fazla token üretmiş olur. vLLM dokümantasyonuna göre yöntem, donanımın kayan nokta hassasiyeti sınırları içinde teorik olarak kayıpsızdır.【1】 Yöntemin genel bir incelemesi için bkz.【2】
Bu yazı, GLM-5.3-Flash modelinde spekülatif kod çözmenin iki metodunu, vLLM 0.32.0rc0 üzerinde aynı donanım ve aynı iş yüküyle karşılaştırmayı amaçlamaktadır. 17.280 karşılaştırmalı değerlendirme testi (benchmark) isteğinden oluşan ölçümlerde en yüksek çıktı hızı (output throughput), ölçülen bütün eşzamanlılık (concurrency) düzeylerinde ayrı eğitilmiş DFlash2 taslak modeliyle elde edilmiştir; modelin kendi MTP katmanıyla ise kısa bağlam (context) sınırlarında daha fazla anahtar–değer önbelleği (KV cache) kapasitesi korunmuştur. Sonuçlar tek koşuya, tek donanım yapılandırmasına (2× B200, iki GPU'ya bölünmüş tensör paralelliği — tensor parallelism, TP=2) ve bir sürüm adayına (release candidate) dayanır; çıktı kalitesi ölçülmemiştir.
GLM-5.3-Flash ile spekülatif kod çözme iki yöntemle gerçekleştirilebilir:
vLLM 0.32.0rc0 sürümünden itibaren iki yöntem de yamasız vLLM üzerinde çalıştırılabilir. Bu yazıda ikisi birbiriyle ve spekülasyonsuz çalışmayla (baseline) karşılaştırılır. Yazıda dört soru yanıtlanır: 1 ile 32 arasında eşzamanlı istekte hızın nasıl değiştiği, kaç taslak token kullanılması gerektiği, hangi yöntemin ne kadar KV önbelleği kapasitesi tükettiği ve uzun girdilerde nelerin değiştiği.
Spekülatif kod çözmede düşük maliyetli bir taslak model, sıradaki k token'ı önceden önerir. Asıl üretimi yapan hedef model bu önerilerin hepsini tek bir ileri geçişte doğrular: Önerilerin baştan itibaren doğru olan en uzun kısmını kabul eder ve ayrıca kendisi bir token üretir. Hedef modelin her adımda ürettiği token sayısına kabul uzunluğu (acceptance length, AL) denir. Elde edilen hızlanma, bu uzunluğa ve tahmin ile doğrulamanın maliyetine bağlıdır.
İki yöntem, taslağı nereden ve nasıl ürettikleri bakımından ayrışır. MTP, hedef modelin son gizli durumunu (hidden state) kullanırken DFlash2 hedef modelin beş katmanından gelen gizli durumlarla çalışır ve kayan pencereli dikkat (sliding window attention) kullanır.【5】
Tablo 1: MTP ve DFlash2 Yöntemlerinin Yapısal Karşılaştırması
DFlash2 için bkz.【6】
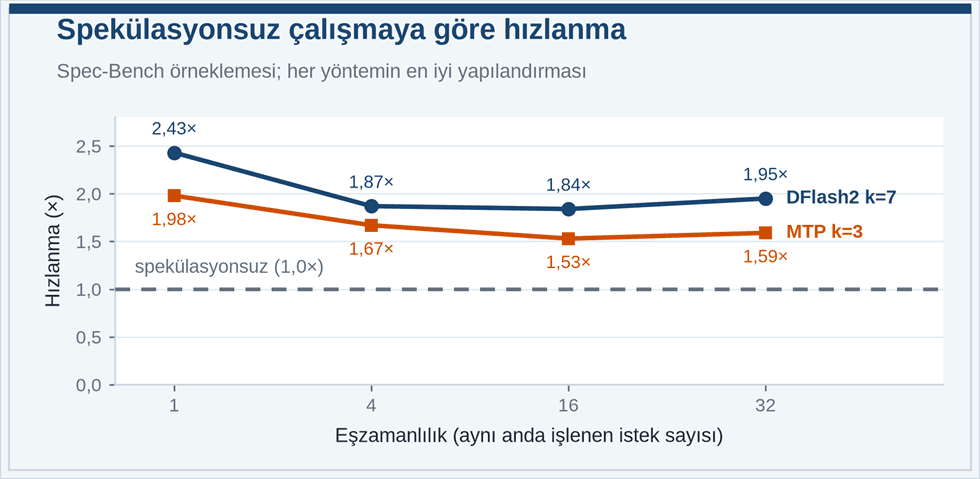
Spec-Bench Örneklemesinde Spekülasyonsuz Çalışmaya Göre Hızlanma (Yapay Zeka ile Oluşturulmuştur.)
Hızlanma tek akışta en yüksektir; eşzamanlılık 4–32 aralığında ise DFlash2 k=5 için 1,8–1,9× civarına inmiştir. Bu düşüş büyük olasılıkla, aynı anda işlenen istek sayısı arttıkça GPU'da taslak token'ları doğrulamak için kalan boş hesap kapasitesinin azalmasından kaynaklanmaktadır. Buna rağmen 32 eşzamanlı istekte bile spekülasyonla belirgin bir kazanç sağlanmıştır.
Tablo 2: Spec-Bench Örneklemesinde Çıktı Token/sn Değerleri
Parantez içinde spekülasyonsuz çalışmaya göre hızlanma verilmiştir. Kalın satırlar her yöntemin önerilen yapılandırmasıdır.
Kabul uzunluğu metnin türüne göre belirgin biçimde değişmiştir. Açgözlü kod çözmede ve eşzamanlılık 1'de DFlash2 k=7, matematik kategorisinde 5,95 kabul uzunluğuna ulaşmıştır (598 token/sn); beşeri bilimler sorularında ise 2,79'da kalmıştır (301 token/sn). Bu iki kategorinin her biri 10 istem içerir. Bütün istemler birlikte ele alındığında açgözlü kod çözmede DFlash2 k=7, spekülasyonsuz çalışmadan 2,77 kat hızlı (407'ye karşı 147 token/sn).
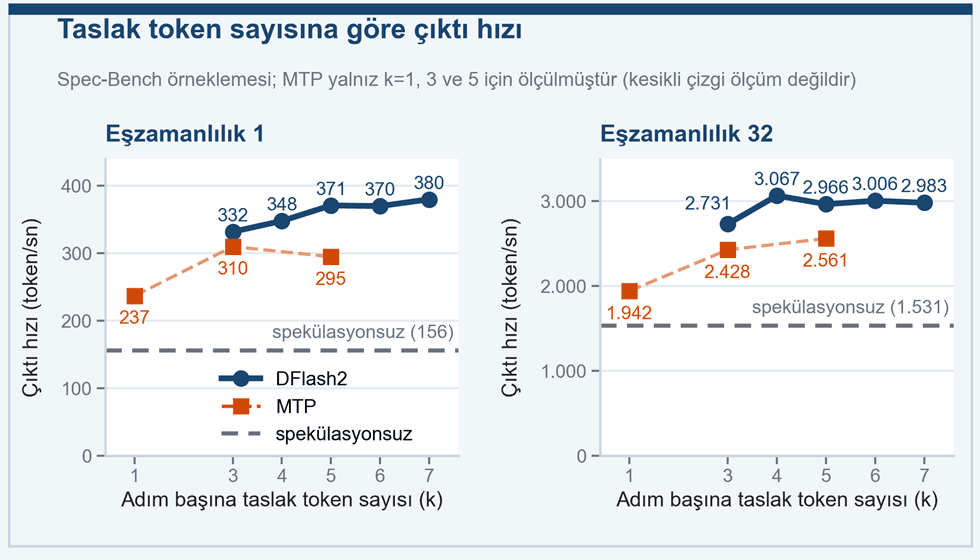
Taslak Token Sayısına (k) Göre Çıktı Hızı (Yapay Zeka ile Oluşturulmuştur.)
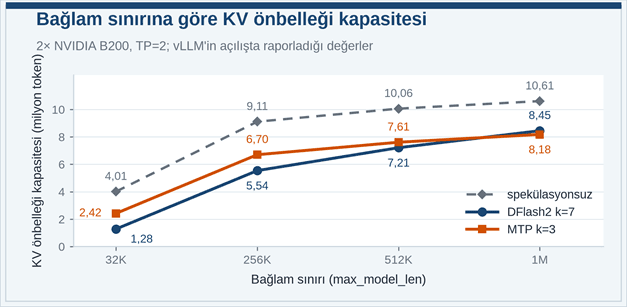
Bağlam Sınırına (max_model_len) Göre vLLM'in Açılışta Raporladığı KV Önbelleği Kapasitesi (Yapay Zeka ile Oluşturulmuştur.)
KV önbelleği, modelin daha önce işlediği token'lara ait dikkat anahtar ve değerlerini tutan GPU belleğidir. Spekülasyon, taslak modelin ağırlıklarının ötesinde bu bellekte ek yer gerektirir. Bu ek yerin iki kaynağı vardır:
Her iki maliyet de token başına değil, istek başına ortaya çıkar. vLLM 32K sınırında çok sayıda eşzamanlı isteğe yer ayırdığından maliyet burada baskın hâle gelir; 1M'de ise payı küçülür.
Tablo 3: vLLM'in Açılışta Raporladığı KV Önbelleği Token Kapasitesi
Parantez içinde o bağlam sınırındaki en yüksek eşzamanlılık gösterilmiştir.
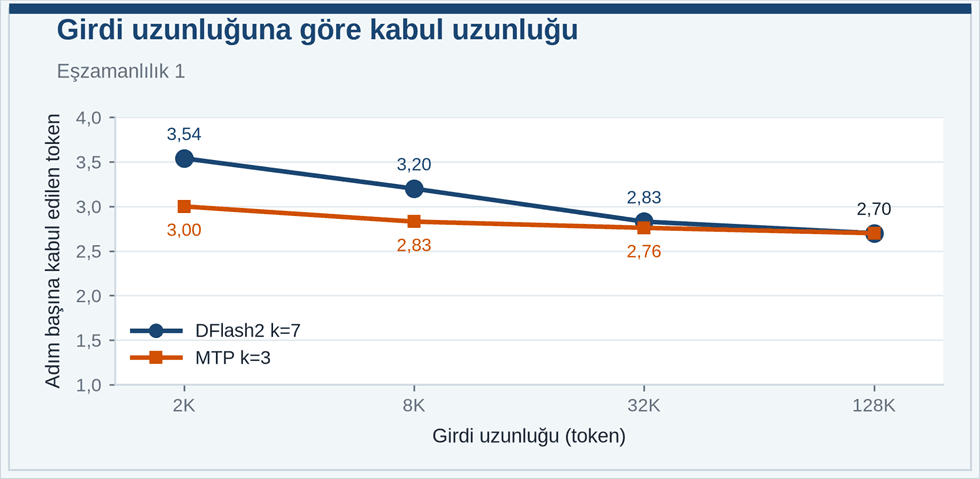
Girdi Uzunluğuna Göre Kabul Uzunluğu (Eşzamanlılık 1) (Yapay Zeka ile Oluşturulmuştur.)
Uzun girdide kabul uzunluğunun nasıl değiştiğini görmek için her uzunlukta Savaş ve Barış'tan 4 bölüm gönderildi. Her bölümün ardından "metni özetle" talimatı yer aldı ve istekler tek tek (eşzamanlılık 1) işlendi. Üretim aşaması hızı yanıt akışından, kabul uzunluğu ise vLLM'in `/metrics` sayaçlarındaki farklardan ölçüldü.
Tablo 4. Girdi Uzunluğuna Göre Üretim Aşaması Token/sn ve Kabul Uzunluğu (AL), eşzamanlılık 1.
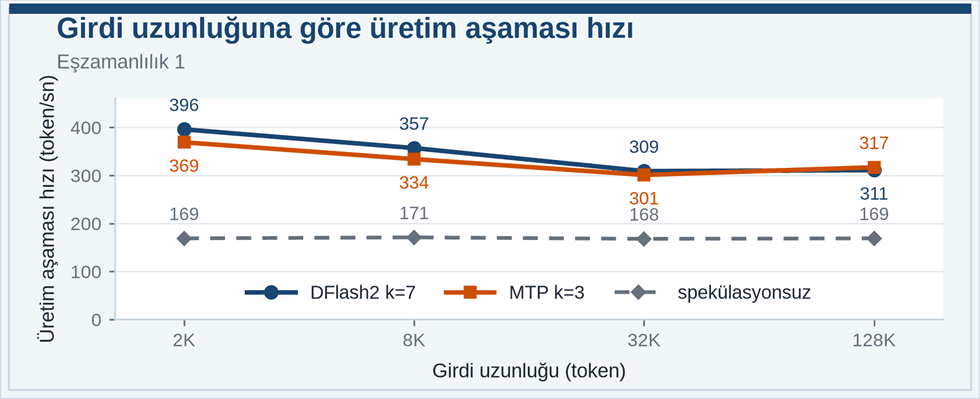
Girdi Uzunluğuna Göre Üretim Aşaması Hızı (Eşzamanlılık 1) (Yapay Zeka ile Oluşturulmuştur.)
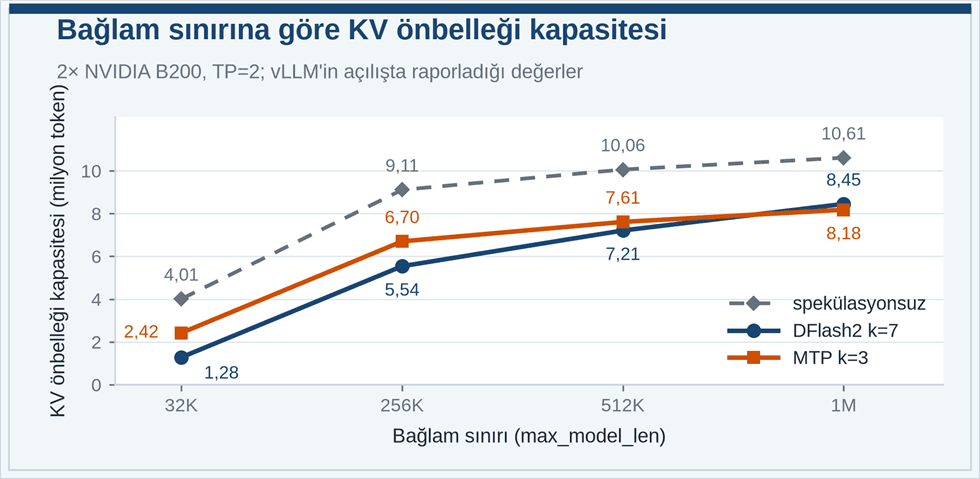
KV Cache Capacity Reported by vLLM at Startup According to Context Limit (max_model_len) (Generated by Artificial Intelligence.)
GLM-5.3-Flash'ı yamasız vLLM 0.32.0rc0 üzerinde servis ederken DFlash2 k=5, ölçülen bütün eşzamanlılık düzeylerinde spekülasyonsuz çalışmaya göre 1,8–2,4× çıktı hızı sağlayan ve KV önbelleği maliyeti k=7'den düşük olan dengeli seçenektir. MTP ise ek model gerektirmemesi ve kısa bağlam sınırında daha fazla kapasite bırakması nedeniyle, çok sayıda eşzamanlı uzun isteğin önemli olduğu servislerde öne çıkar. Bu sonuçlar tek koşuya, tek donanım yapılandırmasına ve bir sürüm adayına dayanır. Sonraki adım olarak ölçümlerin tekrarlı koşularla, farklı tensör ve uzman paralelliği yapılandırmalarında yinelenmesi uygun olacaktır.
Chen, J., Y. Liang, Z. Liu. "DFlash: Block Diffusion for Flash Speculative Decoding." *arXiv*. 2026. Accessed October 26, 2026.https://arxiv.org/abs/2602.06036
Dovis01. "[Spec Decode][Model] Support DFlash2 draft models with GLM-5.3-Flash." GitHub. Accessed October 26, 2026.https://github.com/vllm-project/vllm/pull/56983
NVIDIA. "GLM-5.3-Flash-NVFP4." Hugging Face. Accessed October 26, 2026.https://huggingface.co/nvidia/GLM-5.3-Flash-NVFP4
Xia, H., Z. Yang, Q. Dong et al. "Unlocking Efficiency in Large Language Model Inference: A Comprehensive Survey of Speculative Decoding." *arXiv*. 2024. Accessed October 26, 2026.https://arxiv.org/abs/2401.07851
andakai. "[KV Cache] GLM-5.3-Flash: use the generic packed KV layout; CircularBufferSpec tail with speculative ring slots." GitHub. Accessed October 26, 2026.https://github.com/vllm-project/vllm/pull/57169
hemingkx. "Spec-Bench." GitHub. Accessed October 26, 2026.https://github.com/hemingkx/Spec-Bench
inco.ai. "DFlash 2: Keep Drafting Parallel." inco.ai. Accessed October 26, 2026.https://inco.ai/blog/dflash2/
incoai. "GLM-5.3-Flash-DFlash2." Hugging Face. Accessed October 26, 2026.https://huggingface.co/incoai/GLM-5.3-Flash-DFlash2
ischencheng. "[Bugfix][Spec Decode] Fix GLM-5.3-Flash DFlash2/EAGLE3 aux hidden-state capture with the upstream config." GitHub. Accessed October 26, 2026.https://github.com/vllm-project/vllm/pull/60763
vLLM. "Speculative Decoding." vLLM. Accessed October 26, 2026.https://docs.vllm.ai/en/latest/features/speculative_decoding/
[1]
vLLM, "Speculative Decoding," vLLM, Erişim Tarihi: 26 Ekim 2026. https://docs.vllm.ai/en/latest/features/speculative_decoding/
[2]
H. Xia, Z. Yang, Q. Dong vd., "Unlocking Efficiency in Large Language Model Inference: A Comprehensive Survey of Speculative Decoding," arXiv, 2024, Erişim Tarihi: 26 Ekim 2026. https://arxiv.org/abs/2401.07851
[3]
incoai, "GLM-5.3-Flash-DFlash2," Hugging Face, Erişim Tarihi: 26 Ekim 2026. https://huggingface.co/incoai/GLM-5.3-Flash-DFlash2
[4]
inco.ai, "DFlash 2: Keep Drafting Parallel," inco.ai, Erişim Tarihi: 26 Ekim 2026. https://inco.ai/blog/dflash2/
[5]
Dovis01, "[Spec Decode][Model] Support DFlash2 draft models with GLM-5.3-Flash," GitHub, Erişim Tarihi: 26 Ekim 2026. https://github.com/vllm-project/vllm/pull/56983; vLLM, "Speculative Decoding."
[6]
incoai, "GLM-5.3-Flash-DFlash2," Hugging Face; inco.ai, "DFlash 2: Keep Drafting Parallel," inco.ai, Erişim Tarihi: 26 Ekim 2026. https://inco.ai/blog/dflash2/
[7]
nvidia, "GLM-5.3-Flash-NVFP4," Hugging Face, Erişim Tarihi: 26 Ekim 2026. https://huggingface.co/nvidia/GLM-5.3-Flash-NVFP4
[8]
incoai, "GLM-5.3-Flash-DFlash2." Hugging Face.
[9]
inco.ai, "DFlash 2: Keep Drafting Parallel," inco.ai.
[10]
hemingkx, "Spec-Bench," GitHub, Erişim Tarihi: 26 Ekim 2026. https://github.com/hemingkx/Spec-Bench
[11]
nvidia, "GLM-5.3-Flash-NVFP4." Hugging Face.
[12]
Dovis01, "[Spec Decode][Model] Support DFlash2 draft models with GLM-5.3-Flash," GitHub; ischencheng, "[Bugfix][Spec Decode] Fix GLM-5.3-Flash DFlash2/EAGLE3 aux hidden-state capture with the upstream config," GitHub; andakai, "[KV Cache] GLM-5.3-Flash: use the generic packed KV layout; CircularBufferSpec tail with speculative ring slots," GitHub.
[13]
vLLM, "Speculative Decoding," vLLM.
[14]
incoai, "GLM-5.3-Flash-DFlash2," Hugging Face.

MTP ve DFlash2 Taslak Token'ları Nasıl Üretir?
Yöntem
Temel Bulgular
Eşzamanlılık Arttıkça Çıktı Hızı Nasıl Değişir?
Kaç Taslak Token Kullanılmalıdır?
Spekülasyon KV Önbelleği Kapasitesini Nasıl Etkiler?
Uzun Girdi Kabul Uzunluğunu ve Üretim Aşaması Hızını Nasıl Etkiler?
Hangi Yapılandırma Önerilir?
Kapsam ve Sınırlılıklar
Sonuç