

Bir çocuk dünyaya gözlerini açtığında kendisini bekleyen ilk şey bir sözlük değildir. Ona kimse fiil çekimleriyle “hoş geldin” demez. Dil, çocuğa evvela bir ses olarak gelir: annesinin ninnisinden, babasının hitabından, evin içindeki telaştan, sokağın uğultusundan… Sonra masallar karışır bu seslere; okul zili, mahalle arkadaşları, şarkılar, dualar, kızgınlıklar ve şakalar…
Çocuk yalnızca kelimeleri öğrenmez. Bir sözün ne zaman teselli ne zaman sitem ne zaman tehdit olduğunu da sezer. Türkçeyi öğrenirken, Türkçenin içinde taşınan bir dünyayı öğrenir.
Bir yapay zekânın ise ne beşiği vardır ne mahallesi. Sokaktan geçen simitçinin seslenişini duymaz; bir ninenin aynı masalı her anlatışında biraz değiştirmesine şaşırmaz. Türkçe, ona insanların bıraktığı dijital izler hâlinde ulaşır: internet sayfaları, sayısallaştırılmış kitaplar, haberler, altyazılar, forumlar, resmî belgeler, sözlükler, akademik yayınlar, konuşma kayıtları ve geliştiricilerin hazırladığı veri kümeleri… İnsan yavrusu dili yaşayarak edinirken dil modeli, büyük ölçüde metinlerdeki örüntülerden öğrenir.
Bu sebeple “Bir yapay zekâ Türkçeyi nereden öğrenir?” sorusu, ilk bakışta göründüğünden daha büyük bir sorudur. Mesele yalnızca bir makinenin ekleri doğru kullanması, “de” ve “ki”yi yerinde yazması değildir. Asıl mesele, Türkçe konuşan bir yapay zekânın Türkiye’ye, tarihimize, kültürümüze ve bugün tartıştığımız meselelere dair bilgisini hangi metinlerden kurduğudur. Hangi sesleri duymuş, hangilerine hiç rastlamamıştır? Önüne konulan dijital hafızada neler vardır; neler raflarda, sandıklarda yahut henüz kayda geçmemiş hatıralarda kalmıştır? Bir dil modeli Türkçeyi yalnızca kelimelerimizden değil, dijital dünyaya taşıdığımız —ve taşımadığımız— bilgilerden öğrenir.
Yapay zekâ hakkında konuşurken sıkça “Bütün interneti okudu” deriz. Bu, meseleyi kolay anlatan fakat hakikati biraz örten bir cümledir. Büyük dil modelleri, internetin tamamını aynı anda ve aynı dikkatle okuyan sınırsız hafızalar değildir. Geliştiriciler çeşitli kaynaklardan veriler toplar; bunları ayıklar, filtreler, tekrarları azaltır ve belirli ölçütlerle eğitim sürecine dâhil eder. Örneğin GPT-3’ün yayımlanan teknik çalışmasında filtrelenmiş web taramaları, kitap veri kümeleri ve Vikipedi gibi farklı kaynakların birlikte kullanıldığı açıklanmıştı.【1】 Bu, bütün modellerin aynı kaynaklarla eğitildiği anlamına gelmez; fakat önemli bir gerçeği gösterir: Yapay zekânın öğretmeni internetin kendisi değil, internetten ve başka kaynaklardan seçilerek oluşturulan müfredattır.
Bir okulda hangi kitapların okutulduğu ve hangi örneklerin seçildiği nasıl öğrencinin dünyasını etkiliyorsa, veri seçimi de modelin karşılaşacağı bilgi çevresini belirler. Üstelik internet bir kütüphane gibi düzenlenmiş değildir. Bilimsel bir makale ile kim tarafından yazıldığı belli olmayan bir söylenti, ekranda birbirine benzeyen iki sayfa olarak durabilir. Büyük web veri kümelerini inceleyen araştırmacıların beklenmedik kaynaklara, makine ürünü metinlere ve filtreleme tercihlerinin doğurduğu temsil sorunlarına rastlaması da “çok veri” ile “iyi veri”nin aynı şey olmadığını gösteriyor.【2】 Hangi sayfanın nitelikli, hangisinin gereksiz sayıldığına dair her karar, görünür yahut görünmez bir tercihtir.
Kütüphanelerin ise kendine mahsus bir zamanı vardır. Kitap, rafta sabırla bekler. Bir okurun onu bulması, kapağını açması ve yüzlerce sayfanın arasında dolaşması gerekir. Bu yavaşlık kusur değildir; düşüncenin demlenmesine imkân veren bir tarafı vardır. Ne var ki makinenin dünyasında erişilemeyen sayfa, çoğu zaman mevcut değilmiş gibi sessizdir. Bir kitabın yapay zekâ tarafından kullanılabilmesi için sayısallaştırılması, metninin okunabilir hâle getirilmesi ve doğru künyeyle kaydedilmesi gerekir. El yazmaları, eski dergiler, yerel gazeteler, sözlü tarih kayıtları ve şahsi arşivler söz konusu olduğunda bu emek daha da büyür.
Elbette basılı olan her şey doğru, dijital olan her şey şüpheli değildir. Mürekkep, yanlışı hakikate dönüştürmez; ekran da doğru bilgiyi kendiliğinden bozmaz. Esas ayrım, bilginin hangi ortamda bulunduğunda değil; kaynağının görülebilir, iddialarının denetlenebilir ve yanlışlarının düzeltilebilir olmasındadır. Türkçenin farklı dönemleri, ağızları ve meslek dilleri dijital dünyada yeterince temsil edilmezse, yapay zekânın Türkçesi düzgün cümleler kurduğu hâlde hafızası eksik kalabilir. Dijitalde görünmeyen bilgi, yapay zekâ için çoğu zaman yazılmamış bilgiye benzer.
Yapay zekâların en şaşırtıcı tarafı, tereddüt etmeden konuşabilmeleridir. Bir insan hatırlamadığında susabilir, “Emin değilim,” diyebilir veya kitaplığına uzanabilir. Dil modeli ise akıcı bir cevap kurar. Bu cevap doğru da olabilir, yanlış da. Üstelik yanlış olduğunda dahi grameri yerli yerinde, üslubu kendinden emin ve ayrıntıları ikna edici görünebilir.
Amerika Birleşik Devletleri Ulusal Standartlar ve Teknoloji Enstitüsü, üretken yapay zekânın yanlış veya hatalı içeriği kendinden emin biçimde sunmasını “confabulation” kavramıyla ele alıyor; gerçekte bulunmayan atıf ve kaynakların da üretilebileceğini özellikle belirtiyor.【3】 Türkçede buna çoğu zaman “halüsinasyon” deniliyor. Adı ne olursa olsun, bize düşen ders açıktır: Yapay zekânın cevap verme hızı, cevabın doğruluğuna ilişkin bir belge değildir.
Fakat mesele burada daha ince bir hâl alır. Bir cümlenin sonunda dipnot bulunması da o cümleyi otomatik olarak doğru yapmaz. Kaynak eski olabilir; yazar eksik belge görmüş olabilir; bir tanığın sözü bağlamından çıkarılmış, tartışmalı bir yorum kesin hüküm gibi aktarılmış olabilir. Hatta bir çalışma, kendisinden önceki başka bir çalışmanın yanlışını tekrar edebilir. Aynı iddia, birbirine atıf yapan metinler arasında dolaşa dolaşa sonunda doğruymuş gibi görünebilir. Kaynak göstermek, bilginin doğruluğuna vurulmuş bir mühür değil; bilginin nereden geldiğini gösteren bir izdir. İz, araştırmacıyı başlangıç noktasına götürür. Orada sorular yeniden sorulur: Kaynak iddiayı gerçekten destekliyor mu? Birincil belge var mı? Başka tanıklıklar ne söylüyor? Metin daha sonra düzeltilmiş mi? Kaynakça, düşünme zahmetini ortadan kaldırmaz; o zahmeti mümkün kılar. Güvenilir dijital bilgi de yalnızca bol dipnotlu değil; yazarı görünen, dayanakları izlenebilen, farklı delillerle sınanabilen ve yanlışlandığında düzeltilebilen bilgidir.
İnternetteki her yanlış, kötü niyetle doğmaz. Bir tarih yanlış yazılır, eski bir istatistik güncel sanılır, aceleyle hazırlanan bir haber eksik kalır. Fakat bütün yanlışlar da masum değildir. Bilginin güç anlamına geldiği bir çağda hangi anlatının görünür olacağı, hangi kavramın nasıl adlandırılacağı ve hangi şüphenin büyütüleceği üzerine de mücadele yürütülür.
"Bağlamından koparılan bir cümle, hakikati söylemeyebilir" ifadesini yansıtan bir görsel. (Yapay zekâ ile oluşturulmuştur.)
Yapay zekâ bu mücadelenin hem hedefi hem de aracı olabilir. Yanlış bilgi onun aracılığıyla büyük bir hızla çoğaltılabilir; sahte belgeler, görüntüler ve tanıklıklar üretilebilir. Daha derinde ise eğitim veya başvuru verisine kasıtlı biçimde yanıltıcı içerik yerleştirilmesi, yani “veri zehirleme” saldırıları söz konusu olabilir. NIST, saldırganların eğitim verisini model çıktısını yönlendirmek amacıyla bozabileceğine dikkat çekiyor. UNESCO ise bu risklere karşı güvenilir ve çoğulcu bilgi kaynaklarını, şeffaflığı ve medya okuryazarlığını öne çıkarıyor.【4】
Bu tehlikeden korunmak, dünyaya sırtımızı dönmek değildir. Kapalı bir bilgi çevresi de kendi yanlışlarını durmadan tekrar eden bir yankı odasına dönüşebilir. Bir iddia Türkçe yazıldığı için bize ait, bize ait olduğu için de doğru sayılamaz. Millî kabiliyet, farklı kaynaklara ulaşabilmek, onları karşılaştırabilmek, çelişkileri görebilmek ve gerektiğinde kendi kaynaklarımızı da eleştirebilmektir.
Bilgi savaşında en kırılgan toplum, dışarıdan bilgi alan değil, aldığı bilginin nereden geldiğini, nasıl üretildiğini ve hangi maksatla dolaşıma sokulduğunu sorgulayamayan toplumdur. Mesele, yabancı bilgiyi kapının dışında bırakmak değil; kendi bilgimizi ortak bilgi masasındaki yerinden mahrum etmemektir.
Hakikatin milliyeti yoktur; fakat hakikati kendi dilinde üretme, doğrulama, koruma ve dijital dünyaya taşıma kabiliyeti millîdir.
Bir ülkenin kendi uydusunu, aracını ya da savunma sistemini geliştirmesi, teknoloji üretme kabiliyetinin somut bir göstergesidir. Yapay zekâda ise bağımsızlığın ölçüsü bu kadar açık değildir. Sunucular ülke içinde kurulmuş, model burada geliştirilmiş ve ona yerli bir ad verilmiş olabilir. Fakat Türkiye’nin tarihi, hukuku, şehirleri ve kavramları hakkında başvuracağı güvenilir Türkçe kaynaklar yetersizse, makinenin gövdesi bize ait görünürken hafızasının önemli bir bölümü dışarıda şekillenebilir. Bu da bağımlılığın daha sessiz bir biçimidir.
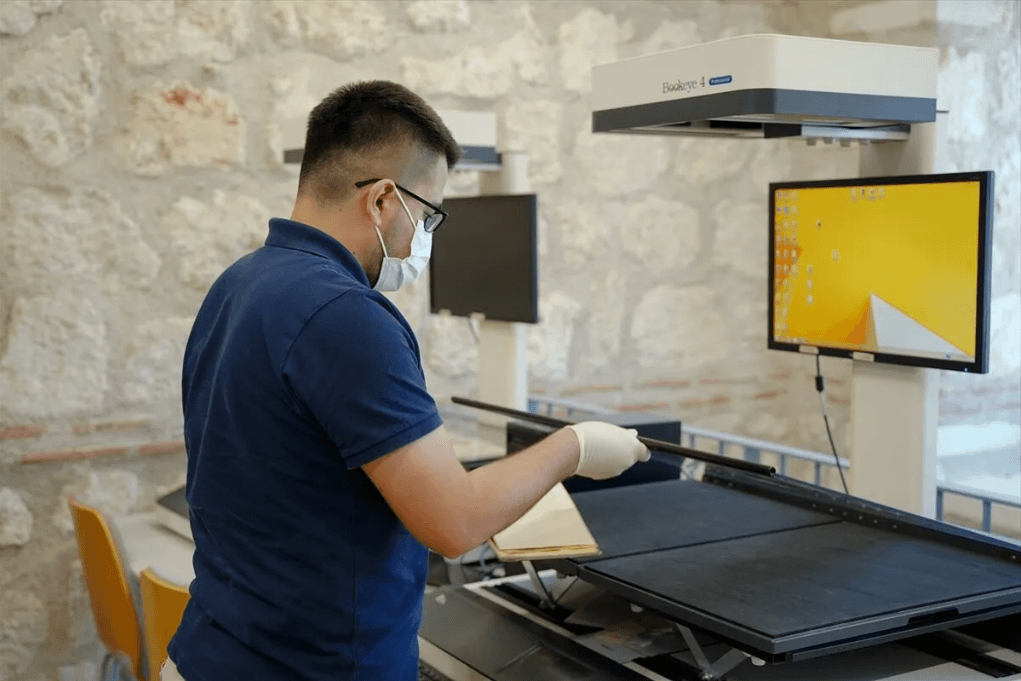
Rami Kütüphanesi, kültürel mirası dijital ortama taşıyor. (Anadolu Ajansı)
Millî Teknoloji Hamlesi yüksek teknoloji ve inovasyonun yanı sıra dijital dönüşümü, girişimciliği, insan kaynağını ve altyapıyı birbirini tamamlayan unsurlar olarak ele alıyor.【5】 Yapay zekâ söz konusu olduğunda altyapı denilince çoğu zaman işlemciler, veri merkezleri ve hesaplama gücü akla geliyor. Oysa teknolojik bağımsızlık bunların yanında modeli geliştirecek yazılım kabiliyetine, onu besleyecek nitelikli veriye ve verdiği cevapları sınayacak insanlarla kurumlara da ihtiyaç duyar. Bu halkalardan biri eksik olduğunda zincir tamamlanmaz.
Millî Teknoloji Hamlesi yalnızca makinelerimizi üretmek değil, o makinelerin başvuracağı hafızayı da kurmaktır. Bazen bu hafızanın inşası, gösterişli bir laboratuvardan önce yıllardır ihmal edilmiş bir arşivin doğru biçimde sayısallaştırılmasıyla başlar.
Bir yapay zekâ modelinin kodunu yazan mühendis ile eski bir yazmayı doğru künyeyle sayısallaştıran kütüphaneci, ilk bakışta birbirinden çok uzak işler yapıyor gibi görünür. Oysa ikisi de aynı teknolojik yapının farklı katlarını kurar. Biri makineye nasıl işleyeceğini öğretirken diğeri onun neyi unutmaması gerektiğine dair bir iz bırakır.
Bu yüzden Millî Teknoloji Hamlesi yalnızca laboratuvarlarda ve üretim tesislerinde yürütülen bir süreç değildir. Arşiv belgesini erişime açan kütüphaneci, Türkçe terimler üzerinde çalışan dil bilimci, yerel tarihi kayda geçiren araştırmacı, veriyi düzenleyen yazılımcı, bilgiyi denetleyen editör ve kaynaklandırılmış içerik üreten yazar da bu altyapının parçasıdır. Millî Teknoloji Hamlesi yalnızca teknoloji üretenlerin değil, güvenilir bilgi üretenlerin de hamlesidir.
Bu altyapının merkezinde dil vardır. Dil yalnızca kullanıcıyla konuşulan bir arayüz değil; bilginin tasnif edildiği, kavramların birbirine bağlandığı ve kültürel bağlamın taşındığı zemindir. Türkçe bir modelin “gemi” ile “tekne” arasındaki farkı bilmesi kadar, “Mavi Vatan” terkibinin hangi tarihî ve hukuki tartışmalar içinde kullanıldığını güvenilir kaynaklardan öğrenebilmesi de önemlidir. Bu ise yalnızca daha çok Türkçe cümle toplamakla değil, daha nitelikli ve daha çeşitli Türkçe bilgi üretmekle mümkündür.
Bu yaz KÜRE Ansiklopedi için “Türkiye’nin Deniz Yetki Alanları” başlıklı maddeyi hazırlarken meseleyi böyle düşünmemiştim. Kaynakları taramış, kavramların hukuki karşılıklarını ayırmaya ve birbirine benzeyen terimlerin arasındaki farkı açık biçimde anlatmaya çalışmıştım. Yazı yayımlandığında onu arayan bir okurun bulacağını, okuyacağını ve belki kaynaklarından birine giderek araştırmasını sürdüreceğini düşünüyordum. Bu, bir ansiklopedi maddesinin alıştığımız hayatıydı.
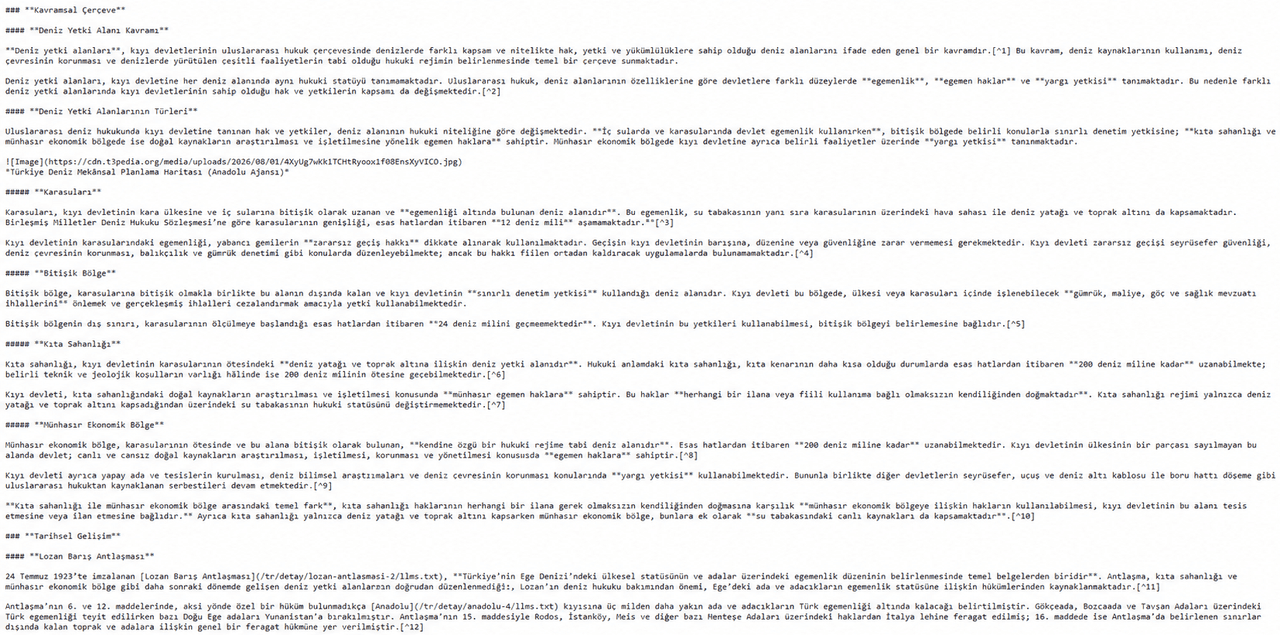
Türkiye'nin Deniz Yetki Alanları makine görünümü (KÜRE Ansiklopedi)
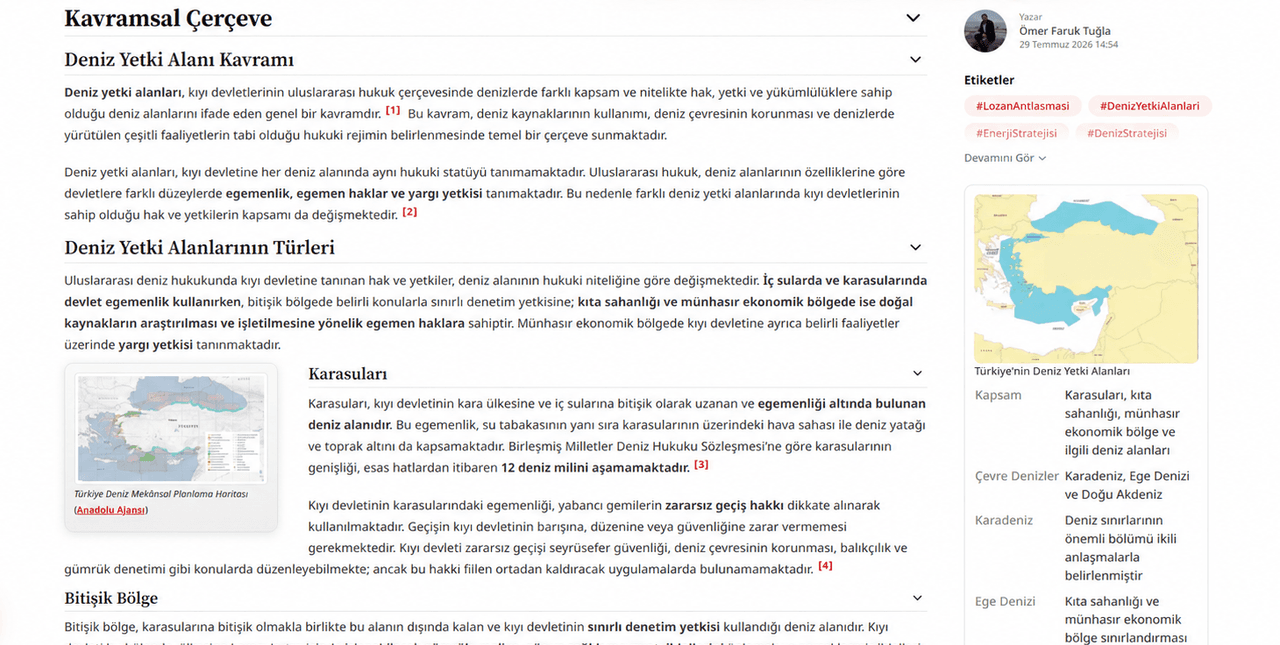
Türkiye'nin Deniz Yetki Alanları normal görünümü (KÜRE Ansiklopedi)
Bu blog yazısı üzerine çalışırken aynı maddeye yeniden baktım. 【6】 Bu sırada maddenin makineler için sadeleştirilmiş, okunabilir bir metin sürümünün de bulunduğunu gördüm. Başlık, yazar adı, etiketler, açıklamalar ve kaynaklar; sayfanın görsel düzeninden ayrılarak yapılandırılmış bir metin hâlinde sunuluyordu.【7】 Bu tür sunumlar, internet sitelerinin içeriklerini dil modelleri ve onları kullanan araçlar için daha anlaşılır hâle getirmeyi amaçlayan llms.txt yaklaşımıyla aynı düşünceden beslenir.【8】 Bu yaklaşım henüz bütün sistemlerin benimsediği evrensel bir standart değildir; böyle bir metnin bulunması, içeriğin mutlaka bir modelin eğitimine gireceği anlamına da gelmez. Fakat arama ve belge getirme sistemlerinin erişebileceği açık bir dijital iz bırakır. O zaman şunu daha berrak biçimde fark ettim: Ben yalnızca bugünün okuruna bir madde yazmamıştım; yarının bilgi araçlarının erişebileceği Türkçe hafızaya da küçük bir iz bırakmıştım. Bir zamanlar ansiklopedi sayfasında duran madde, artık bilgi ağının içinde başka metinlere bağlanan bir düğüm hâline gelmişti.
Bu blog yazısı üzerine çalışırken aynı maddenin makineler için sadeleştirilmiş, okunabilir bir metin sürümünün de bulunduğunu gördüm. Başlık, yazar adı, etiketler, açıklamalar ve kaynaklar; sayfanın görsel düzeninden ayrılarak yapılandırılmış bir metin hâlinde sunuluyordu. Bu tür sunumlar, internet sitelerinin içeriklerini dil modelleri ve onları kullanan araçlar için daha anlaşılır hâle getirmeyi amaçlayan llms.txt yaklaşımıyla aynı düşünceden beslenir. Bu yaklaşım henüz bütün sistemlerin benimsediği evrensel bir standart değildir; böyle bir metnin bulunması, içeriğin mutlaka bir modelin eğitimine gireceği anlamına da gelmez. Fakat arama ve belge getirme sistemlerinin erişebileceği açık bir dijital iz bırakır. O zaman şunu daha berrak biçimde fark ettim: Ben yalnızca bugünün okuruna bir madde yazmamıştım; yarının bilgi araçlarının erişebileceği Türkçe hafızaya da küçük bir iz bırakmıştım. Bir zamanlar ansiklopedi sayfasında duran madde, artık bilgi ağının içinde başka metinlere bağlanan bir düğüm hâline gelmişti.
KÜRE’nin kıymeti, orada bulunan her bilginin sırf yerli bir platformda yayımlandığı için tartışılmaz doğru sayılmasında değildir. Böyle bir iddia, bu yazının başından beri savunduğu her şeye aykırı olurdu. Asıl kıymet; yazarın görünür olmasında, kaynakların izlenebilmesinde, içeriğin incelenip gerektiğinde güncellenebilmesinde ve Türkçe bilginin dijital dolaşıma elverişli hâle getirilmesindedir. Güvenilirlik, bir defa kazanılıp kasaya kaldırılan bir madalya değil; her yeni madde, itiraz ve düzeltmeyle yeniden yürütülen bir süreçtir.
İşte KÜRE’yi Millî Teknoloji Hamlesi bakımından anlamlı kılan da budur. Bir ansiklopedi maddesi tek başına bir yapay zekâ modeli kurmaz; fakat o modelin veya onunla çalışan bilgi araçlarının başvurabileceği hafızayı zenginleştirir. Bu vazife de yalnızca bir ansiklopedinin omuzlarına bırakılamaz. Üniversitelerin açık arşivleri, kütüphanelerin sayısallaştırma çalışmaları, nitelikli dergiler, resmî veri portalları, sözlükler, müzeler ve yerel tarih araştırmaları aynı hafızanın farklı odalarıdır. Bu odaların kapıları birbirine açıldıkça Türkçenin dijital dünyadaki evi genişler.
Bir çocuk Türkçeyi çevresindeki insanların seslerinden öğrenir. Büyüklerinden duyduğu bir kelimeyi yanlış söylediğinde düzeltilir; aynı hikâyeyi farklı ağızlardan dinler; zamanla hangi söze güveneceğini, hangisine ihtiyatla yaklaşacağını öğrenir. Dil modeli ise bizim düzeltmemizi kendiliğinden bekleyemez. Önüne hangi metinleri koyarsak, hangi arşivleri açarsak ve hangi yanlışları çoğaltırsak, dijital dünyada onlarla karşılaşır.
Burada ürkütücü olduğu kadar ümit verici bir taraf da vardır. Dijital hafıza kader değildir; kurulabilir, zenginleştirilebilir ve düzeltilebilir. Unutulmuş bir dergi sayısallaştırılabilir. Eksik bir kavram maddesi yazılabilir. Yanlış bir bilgi, belgesi gösterilerek tashih edilebilir. Bir uzmanın yıllardır masasının çekmecesinde tuttuğu çalışma, düzenlenip kaynaklandırılarak binlerce insanın ve yeni nesil bilgi araçlarının erişimine açılabilir.
Fakat bunun için yalnızca daha fazla içerik değil, daha fazla özen gerekir. Hız çağında yavaşça doğrulamak, görünürlük yarışında kaynağı göstermek, herkesin birbirini tekrar ettiği yerde ilk belgeye dönmek gerekir. Çünkü yanlış bilgi çoğu zaman gürültüyle yayılır, güvenilir bilgi ise emekle kurulur.
Millî Teknoloji Hamlesi’nin dijital hafızası, yalnızca makinelerin daha iyi Türkçe konuşmasını sağlamayacaktır. Bizim de kendimize ait bilgiyi nasıl ürettiğimizi, neye dayanarak konuştuğumuzu ve yanlışımızla karşılaştığımızda onu düzeltmeye hazır olup olmadığımızı gösterecektir. Teknolojik bağımsızlık, her cevabı önceden bilmek değil; doğru soruyu kendi dilinde sorabilmek, cevabın izini sürebilmek ve gerektiğinde o cevabı yeniden kurabilmektir.
Öyleyse başlangıçtaki soruya dönelim:
Bir yapay zekâ Türkçeyi nereden öğrenir?
Bizim bıraktığımız izlerden.
Belki de bundan sonra sormamız gereken asıl soru şudur: O izleri bırakırken nasıl bir öğretmen olmayı seçiyoruz?
Brown, Tom B., vd. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33 (2020): 1877–1901. Erişim tarihi: 2 Eylül 2026. https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
Dodge, Jesse, Maarten Sap, Ana Marasović, William Agnew, Gabriel Ilharco, Dirk Groeneveld, Margaret Mitchell ve Matt Gardner. “Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus.” Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, 1286–1305. Association for Computational Linguistics, 2021. Erişim tarihi: 2 Eylül 2026. https://doi.org/10.18653/v1/2021.emnlp-main.98.
Howard, Jeremy. “/llms.txt—A Proposal to Provide Information to Help LLMs Use Websites.” Answer.AI. 3 Eylül 2024. Erişim tarihi: 2 Eylül 2026. https://www.answer.ai/posts/2024-09-03-llmstxt.html.
Karagül, Asya Setinay. “Rami Kütüphanesi, Kültürel Mirası Dijital Ortama Taşıyor.” Anadolu Ajansı, 23 Temmuz 2026. Erişim tarihi: 3 Eylül 2026. https://www.aa.com.tr/tr/kultur/rami-kutuphanesi-kulturel-mirasi-dijital-ortama-tasiyor/4006675
National Institute of Standards and Technology. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1. Gaithersburg, MD: National Institute of Standards and Technology, 2024. Erişim tarihi: 2 Eylül 2026. https://doi.org/10.6028/NIST.AI.600-1.
Tuğla, Ömer Faruk. “Türkiye’nin Deniz Yetki Alanları.” KÜRE Ansiklopedi. Erişim tarihi: 2 Eylül 2026. https://kureansiklopedi.com/tr/detay/turkiyenin-deniz-yetki-alanlari-8f693. Makinece okunabilir sürüm: https://kureansiklopedi.com/tr/detay/turkiyenin-deniz-yetki-alanlari-8f693/llms.txt.
Türkiye Teknoloji Takımı Vakfı. “Millî Teknoloji Hamlesi.” Erişim tarihi: 2 Eylül 2026. https://t3vakfi.org/tr/hakkimizda/mth/.
UNESCO. “Recommendation on the Ethics of Artificial Intelligence.” 23 Kasım 2021. Erişim tarihi: 2 Eylül 2026. https://www.unesco.org/en/legal-affairs/recommendation-ethics-artificial-intelligence.
[1]
Tom B. Brown vd., “Language Models Are Few-Shot Learners,” Advances in Neural Information Processing Systems 33 (2020): 1877–1901, https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
[2]
Jesse Dodge vd., “Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus,” Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing (Association for Computational Linguistics, 2021), 1286–1305, https://doi.org/10.18653/v1/2021.emnlp-main.98.
[3]
National Institute of Standards and Technology, Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1 (Gaithersburg, MD: NIST, 2024), 9, https://doi.org/10.6028/NIST.AI.600-1.
[4]
National Institute of Standards and Technology, Generative Artificial Intelligence Profile, 12–14; UNESCO, “Recommendation on the Ethics of Artificial Intelligence,” 23 Kasım 2021, https://www.unesco.org/en/legal-affairs/recommendation-ethics-artificial-intelligence.
[5]
Türkiye Teknoloji Takımı Vakfı, “Millî Teknoloji Hamlesi,” https://t3vakfi.org/tr/hakkimizda/mth/.
[6]
Ömer Faruk Tuğla, “Türkiye’nin Deniz Yetki Alanları,” KÜRE Ansiklopedi, https://kureansiklopedi.com/tr/detay/turkiyenin-deniz-yetki-alanlari-8f693.
[7]
Ömer Faruk Tuğla, “Türkiye’nin Deniz Yetki Alanları,” KÜRE Ansiklopedi, makinece okunabilir sürüm, https://kureansiklopedi.com/tr/detay/turkiyenin-deniz-yetki-alanlari-8f693/llms.txt.
[8]
Jeremy Howard, “/llms.txt—A Proposal to Provide Information to Help LLMs Use Websites,” Answer.AI, 3 Eylül 2024, https://www.answer.ai/posts/2024-09-03-llmstxt.html.
İnternetin Gürültülü Mektebi
Kaynağın İzi, Hakikatin Mührü Değildir
Yanlışın da Bir Mühendisliği Var
Millî Olan Hakikat Değil, Kabiliyettir
Millî Teknoloji Hamlesi ve Görünmeyen Emekçileri
Bir Ansiklopedi Maddesinin İkinci Hayatı
Nasıl Bir Öğretmen Olacağız?
