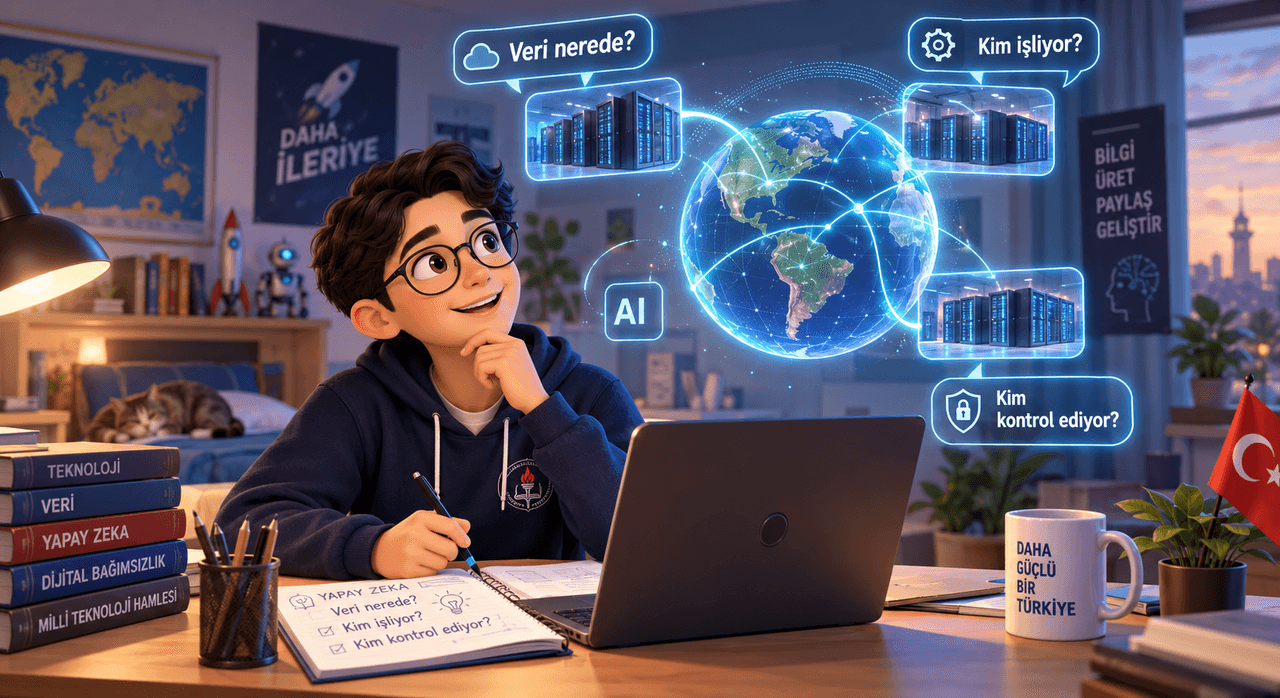
Veri Güvenliği ve Dijital Kontrolü Gösteren Temsili Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Bir yapay zekâya soru sormak artık günlük hayatımızın sıradan bir parçası hâline geldi. Ben de bazen bir konu hakkında fikir almak, bir metni özetlemek ya da aklımdaki bir sorunun cevabını öğrenmek için yapay zekâ araçlarını kullanıyorum. Birkaç kelime yazdıktan sonra cevabın saniyeler içinde gelmesine o kadar alıştık ki çoğu zaman arka planda neler olduğunu düşünmüyoruz.
Oysa ben bu konu üzerine çalışmaya başladığımda basit görünen bir sorunun aslında başka soruları da beraberinde getirdiğini fark ettim. Yazdığım cümle nereye gidiyor? Bu veriyi hangi bilgisayar işliyor? O bilgisayar hangi ülkede bulunuyor? Bize Türkçe cevap veren bir sistem, Türkçeyi sadece kelimelerden mi tanıyor, yoksa deyimlerimizi ve kültürel ifadelerimizi de anlayabiliyor mu?
Bugüne kadar bağımsızlık denildiğinde aklıma daha çok kara, deniz ve hava sınırları gelirdi. Fakat teknoloji geliştikçe bunun yalnızca fiziksel sınırlarla ilgili olmadığını düşünmeye başladım. Çünkü bugün ülkeler için veri de en az enerji, üretim ve iletişim altyapısı kadar önemli hâle geliyor.
Bu yüzden bu yazıyı hazırlarken aklımda sürekli aynı soru vardı:
Verinin de vatanı var mı?
Yapay zekâ çoğu zaman ekrandaki bir sohbet kutusundan ibaretmiş gibi görünür. Oysa bu kutunun arkasında birbirine bağlı üç temel unsur bulunur: veri, hesaplama gücü ve model.
Veri, yapay zekânın öğrenebileceği dünyayı oluşturur. Metinler, görüntüler, sesler ve sayısal ölçümler modellerin örüntüleri keşfetmesini sağlayan temel malzemeye dönüşür. Ancak dünyanın en büyük veri arşivine sahip olmak tek başına yeterli değildir. Bu verinin işlenebilmesi için güçlü işlemcilere ve yüksek başarımlı hesaplama altyapısına ihtiyaç vardır.
Model ise veri ile hesaplama gücünün kullanılabilir bir yeteneğe dönüştüğü noktadır. Metin üreten, görüntüleri sınıflandıran, tahmin yapan ya da insanlarla doğal dilde iletişim kuran sistemler bu aşamada ortaya çıkar.
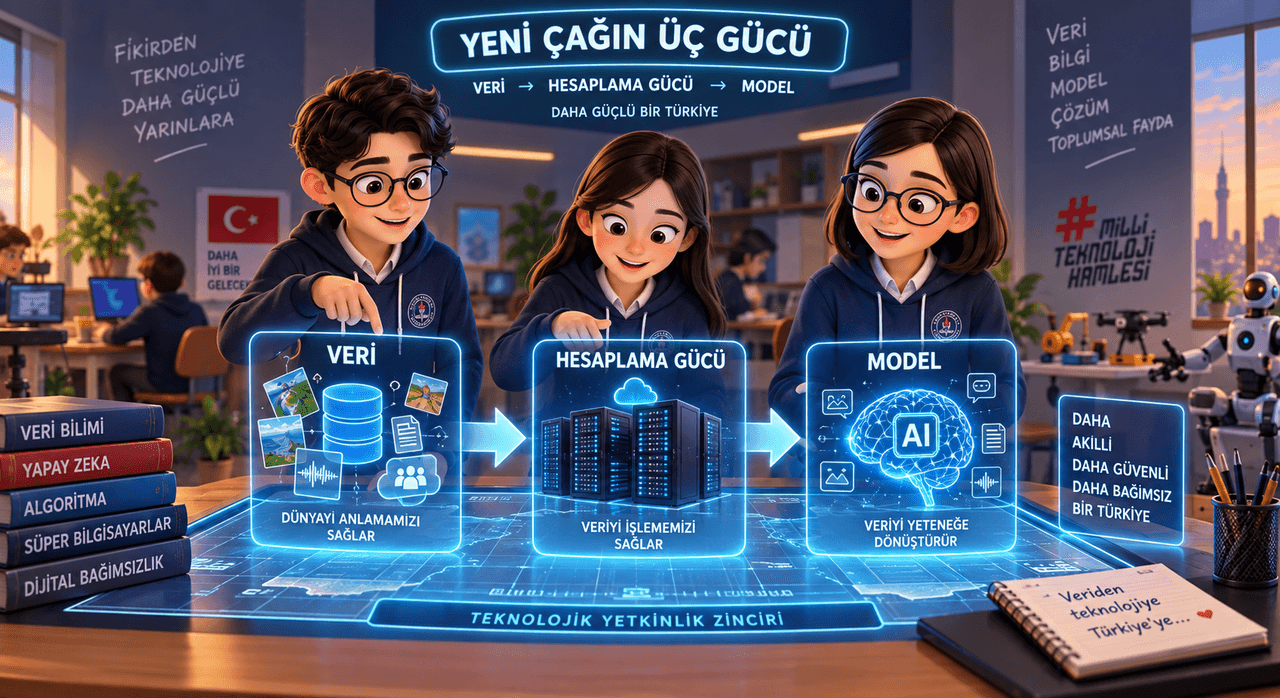
Veri, Hesaplama Gücü ve Yapay Zekâ Modeli İlişkisini Gösteren Temsili Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Böylece yapay zekâ çağının temel zincirlerinden biri kurulabilir:
Veri → Hesaplama Gücü → Model → Teknolojik Yetkinlik
Fakat asıl mesele zincirin yalnızca bir halkasına sahip olmak değildir.
Bir ülkenin büyük miktarda verisi olabilir; ancak bu veriyi işleyecek hesaplama kaynaklarına yeterince erişemiyorsa dış sistemlere bağımlı kalabilir. Güçlü bir altyapıya sahip olabilir; fakat kendi diline ve ihtiyaçlarına uygun modeller geliştiremiyorsa teknolojinin önemli bölümünü başkalarından almak zorunda kalabilir.
Bu nedenle yapay zekâ çağında dijital bağımsızlık, yalnızca yerli bir uygulama geliştirmekten daha geniş bir anlam taşır.
Asıl soru şudur:
Verimizi bilgiye, bilgimizi teknolojiye, teknolojimizi de toplumsal değere dönüştürebiliyor muyuz?
Veriye “yeni çağın petrolü” denildiğini birçok yerde duymuş olabiliriz. Ben bu benzetmenin verinin değerini anlatmak için kullanıldığını düşünüyorum; fakat bana göre veri petrolün kendisinden çok bir hafızaya benziyor.
Örneğin bir tarladan yalnızca bir gün boyunca sıcaklık ve nem verisi toplarsak elimizde birkaç ölçüm olur. Fakat aynı ölçümleri yıllarca kaydedersek artık sadece sayılara değil, o tarlanın geçmişine ilişkin bir bilgi birikimine sahip oluruz. Uydu görüntülerinde de benzer bir durum var. Yıllar önce çekilmiş bir görüntü ile bugünkü görüntüyü yan yana koyduğumuzda bir şehrin nasıl büyüdüğünü, bir ormanın nasıl değiştiğini ya da su kaynaklarının nasıl etkilendiğini görebiliriz.
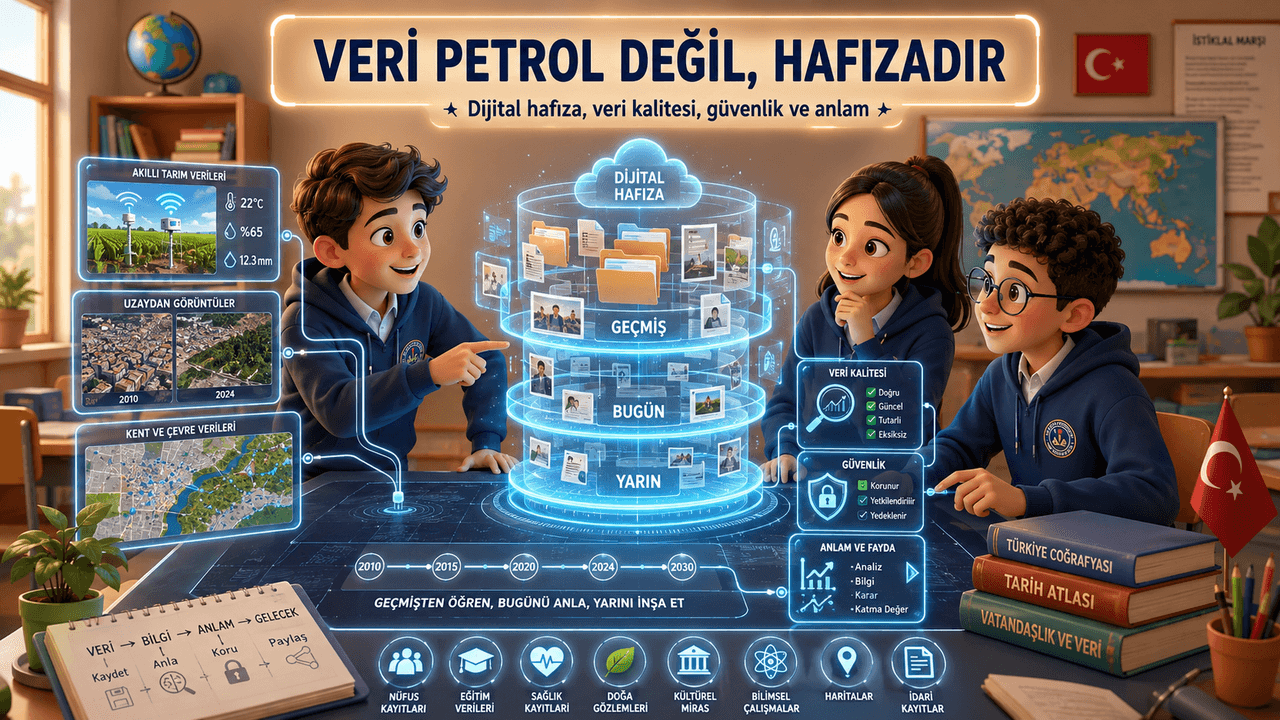
Verinin Dijital Hafızaya Dönüşümünü Gösteren Temsili Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Bu nedenle verinin değeri bana göre yalnızca ne kadar çok olduğuyla ilgili değil.
O veriyi doğru biçimde saklayıp anlamlandırabiliyor muyuz?
Asıl önemli soru bu.
Türkiye'nin 2026–2030 Yapay Zekâ Eylem Planı'nda da veri, insan kaynağı, dijital altyapı ve yapay zekâ uygulamalarının birlikte ele alınması bu nedenle önemlidir. Plan kapsamında en az 2 bin kamu veri setinin Ulusal Veri Kütüphanesi üzerinden erişime sunulması, 10 bin ileri düzey yapay zekâ uzmanı ve 100 bin yapay zekâ uygulama profesyoneli yetiştirilmesi ve 2030'a kadar veri merkezi kurulu gücünün en az 1 gigavata çıkarılması gibi hedefler açıklanmıştır. 【1】
Fakat bir toplumun dijital hafızası yalnızca sensörlerden, ölçümlerden ve sayısal kayıtlardan oluşmaz. Bu hafızanın en değerli parçalarından biri her gün kullandığımız bir yerde saklıdır:
Dilimizde.
“Etekleri zil çalmak.”
Bu deyimi duyduğumuzda hiçbirimiz gerçekten zil çalan bir etek hayal etmiyoruz. Ne anlatılmak istendiğini hemen anlıyoruz. Çünkü Türkçeyi yalnızca okulda öğrendiğimiz kelimelerden değil; ailemizden, çevremizden, kitaplardan, filmlerden ve günlük konuşmalarımızdan öğreniyoruz.
Bu noktayı düşündüğümde yapay zekâ ile insan arasındaki önemli farklardan biri daha görünür hâle geliyor.
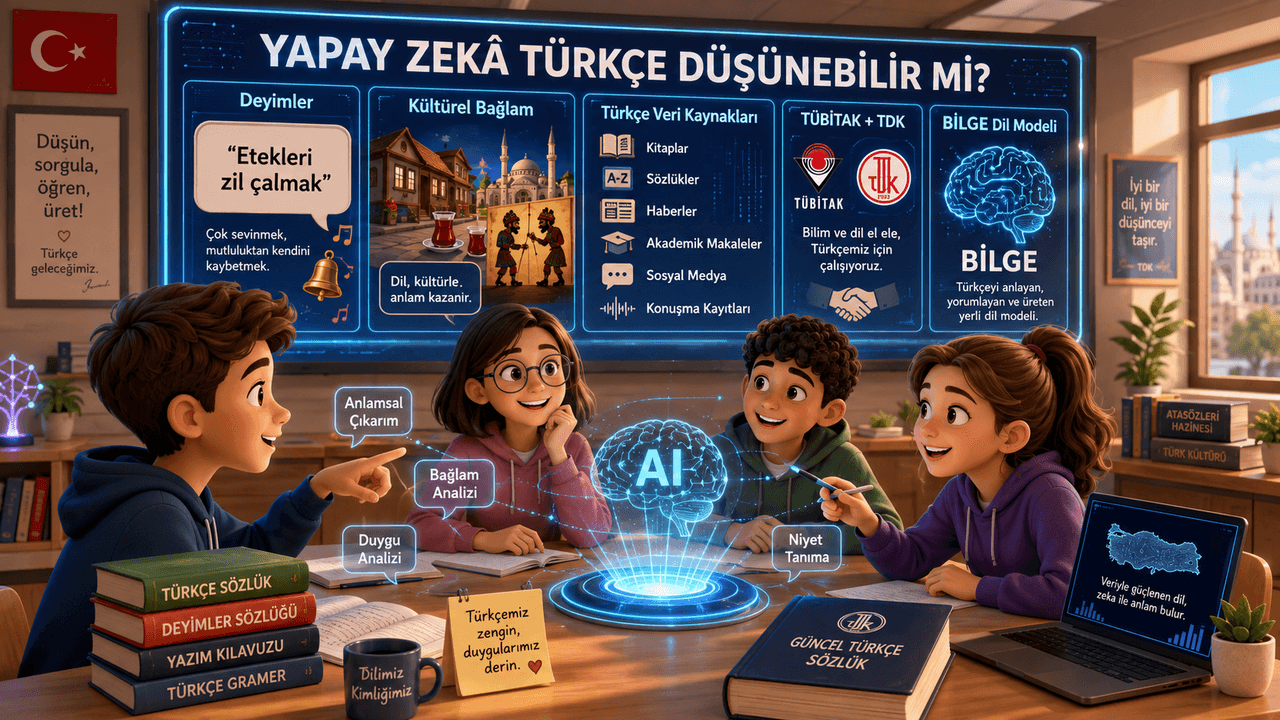
Türkçe, Kültürel Bağlam ve Yapay Zekâ İlişkisini Gösteren Temsili Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Bir yapay zekânın böyle bir çocukluğu yok.
Bir deyimi anneannesinden duymuyor, bir atasözünün hangi durumda söylendiğini yaşayarak öğrenmiyor. Onun Türkçeyle ilişkisi, büyük ölçüde karşılaştığı dijital içerikler üzerinden kuruluyor.
Bu yüzden benim için asıl ilginç soru “Yapay zekâ Türkçe düşünebilir mi?” değil. Daha çok şunu merak ediyorum:
Biz Türkçeyi dijital dünyada ne kadar iyi temsil ediyoruz?
Eğer gelecekte eğitimden bilime, kamu hizmetlerinden günlük yaşama kadar daha fazla yapay zekâ sistemi kullanacaksak Türkçenin bu sistemlerde güçlü biçimde yer alması da önemli olacak. Bunun için yalnızca çok sayıda Türkçe metne değil, doğru, çeşitli ve nitelikli dijital içeriğe ihtiyaç var.
Akademik çalışmalar da Türkçe açısından bu ihtiyaca dikkat çekiyor. Acikgoz, Erdogan ve Yuret; Türkçe gibi dijital kaynakları büyük dillere göre daha sınırlı olan dillerde veri miktarı, model seçimi, değerlendirme yöntemleri ve hesaplama kapasitesinin model başarısını etkileyen önemli unsurlar olduğunu ortaya koyuyor. 【2】
2026 yılında yayımlanan Cetvel çalışması ise Türkçe büyük dil modellerini değerlendirirken yalnızca genel dil anlama başarısını değil; Türkçe dil bilgisi, deyimsel kullanım ve Türk kültürüne ilişkin içerikleri de değerlendirme kapsamına alıyor. 【3】
Bu çalışmalar bana şunu düşündürüyor: Bir yapay zekânın Türkçe birkaç düzgün cümle kurabilmesi, Türkçeyi bütün yönleriyle öğrendiği anlamına gelmiyor. Dilin kültürel ve bağlamsal tarafını da anlayabilmesi gerekiyor.
Bu açıdan TÜBİTAK ile Türk Dil Kurumu arasında 2024 yılında imzalanan iş birliği dikkat çekicidir. İş birliği kapsamında TDK'nın sözlük, ansiklopedi ve dil bilgisi kitapları gibi kaynaklarının dijitalleştirilmesi ve bu kaynakların Türkçe Büyük Dil Modeli çalışmalarında kullanılması hedeflenmiştir. 【4】
Böylece geçmişin dil birikimi ile geleceğin teknolojisi arasında görünmez bir köprü kurulmaktadır:
Sözlükten veri kümesine, kelimeden modele, kültürel hafızadan dijital geleceğe…
Türkiye'nin bu alandaki güncel çalışmalarından biri de BİLGE Dil Modeli'dir. Sanayi ve Teknoloji Bakanlığının 29 Temmuz 2026 tarihli açıklamasına göre TÜBİTAK tarafından geliştirilen BİLGE, 37 milyar parametreli bir modeldir ve geliştiricilerin kullanımına açılması planlanmaktadır. Bakanlık açıklamasında Türkçenin ve toplumsal hafızanın yapay zekâ modellerinde temsil edilmesi teknolojik bağımsızlıkla ilişkilendirilmiştir. 【5】
BİLGE'yle ilgili araştırma yaparken ilk dikkatimi çeken bilgi modelin 37 milyar parametreye sahip olmasıydı. İlk bakışta böyle büyük sayılar etkileyici geliyor. Fakat biraz daha düşündüğümde asıl önemli noktanın bu sayı olmadığını fark ettim.
Çünkü bir modeli geliştirebilmek için önce veriyi hazırlamak gerekiyor. Sonra modeli çalıştırabilecek güçlü bilgisayarlara, modeli eğitecek araştırmacılara ve ortaya çıkan sonucu test edip geliştirecek insanlara ihtiyaç var.
Bu yüzden BİLGE'yi yalnızca “Türkiye'nin geliştirdiği bir dil modeli” olarak görmek bana eksik geliyor. Bence daha önemli tarafı, Türkiye'de böyle bir modeli geliştirebilecek bilgi ve deneyimin oluşmasına katkı sağlaması.
Sonuçta mesele sadece makinelerin Türkçeyi öğrenmesi değil.
Bizim de kendi dilimizi geleceğin teknolojilerine aktarabilecek bilgiye sahip olmamız gerekiyor.
Bir yapay zekâ modeli ekranda birkaç satır metin üretebilir. Fakat o birkaç satırın arkasında oldukça fiziksel bir dünya vardır.
Büyük modellerin geliştirilmesi çok yüksek miktarda hesaplama gerektirir. Bu nedenle yüksek başarımlı hesaplama sistemleri, modern yapay zekâ araştırmalarının temel araçlarından birine dönüşmüştür.
Türkiye'deki bu altyapının önemli örneklerinden biri TÜBİTAK ULAKBİM tarafından işletilen TRUBA – Türk Ulusal Bilim e-Altyapısıdır. TRUBA bünyesinde bulunan ARF-ACC sistemi, yapay zekâ ve veri yoğun uygulamalarda kullanılabilecek güçlü GPU kaynaklarına sahiptir. TÜBİTAK ULAKBİM'in açıklamasına göre sisteme 2025 yılında 192 NVIDIA H200 GPU eklenerek hesaplama kapasitesi artırılmıştır. 【6】
ARF-ACC, dünyanın güçlü süper bilgisayarlarının sıralandığı TOP500 listesinin Haziran 2026 sürümünde 165. sırada yer almaktadır. 【7】
Ancak buradaki önemli nokta sıralamadaki sayının kendisi değildir. Daha değerli olan, ileri düzey hesaplama gerektiren çalışmalar için ülkedeki araştırmacıların erişebileceği bir altyapının bulunmasıdır.
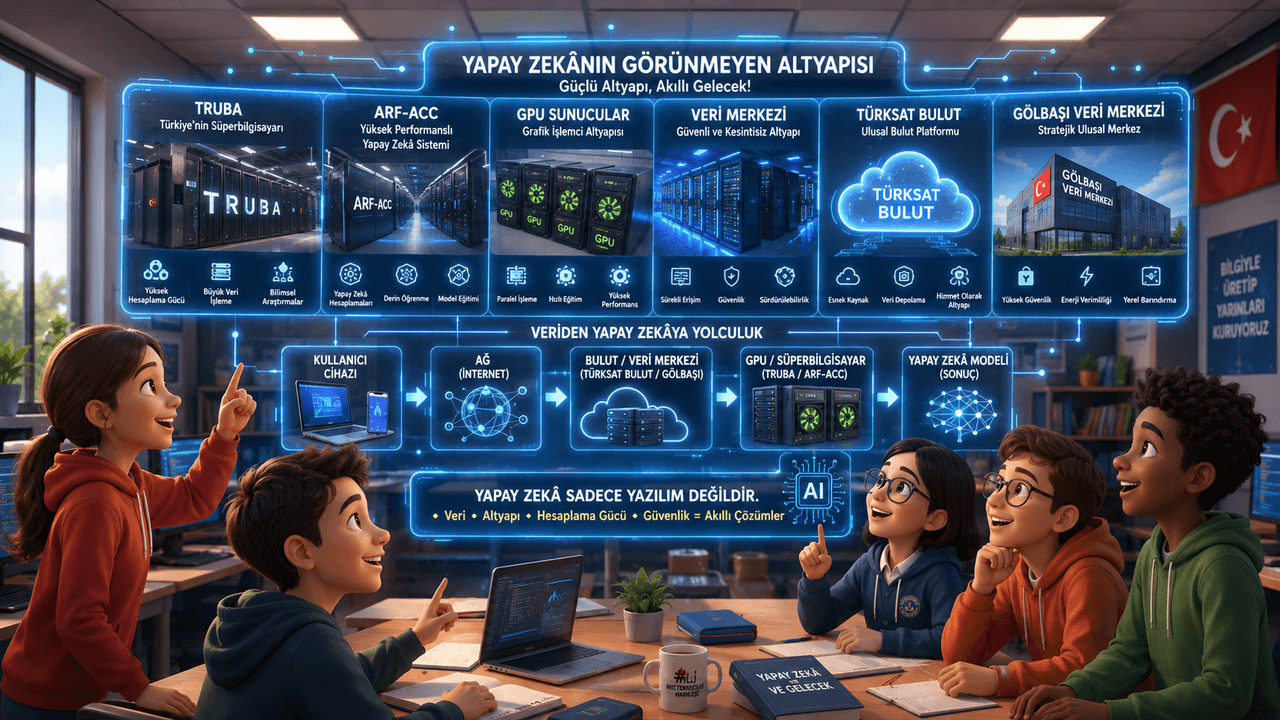
Yapay Zekânın Hesaplama ve Veri Merkezi Altyapısını Gösteren Temsili Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Bir yapay zekâ fikri Türkiye'de ortaya çıkabilir, verisi burada hazırlanabilir ve algoritması burada geliştirilebilir. Ancak modeli eğitmek için gerekli hesaplama gücüne erişilemiyorsa zincirin kritik halkalarından biri eksik kalır.
Bu yüzden süper bilgisayarlar yalnızca çok hızlı bilgisayarlar değildir.
Onlar günümüz biliminin dijital laboratuvarlarıdır.
Peki bütün bu veriler ve hesaplama sistemleri nerede çalışır?
Günlük dilde fotoğraflarımızı “buluta” yüklediğimizi söyleriz. Oysa bulutun kendisi hiç de bulutta değildir. Veriler fiziksel sunucularda saklanır; işlemciler enerji tüketir, ağ sistemleri veri taşır ve ortaya çıkan ısı soğutma altyapılarıyla kontrol edilir.
Yani dijital dünyanın arkasında son derece somut bir yapı vardır:
Veri merkezleri.
Türkiye'deki güncel örneklerden biri Türksat Bulut platformudur. Türksat, 27 Şubat 2026'da tanıttığı sistemle kamu ve özel sektör verilerinin yerli ekosistemde muhafaza edilmesini, stratejik veri güvenliğinin güçlendirilmesini ve yapay zekâ temelli dijital dönüşümün desteklenmesini hedeflediğini açıklamıştır. 【8】
Bu yaklaşımın fiziksel boyutlarından biri de Ankara'da yapımı başlayan Türksat Gölbaşı Veri Merkezi'dir. Temeli 22 Temmuz 2026'da atılan merkezin kamu kurumlarının bilişim ve bulut altyapısının önemli bir bölümünü aynı çatı altında toplaması ve yüksek işlem kapasitesi gerektiren dijital hizmetlere altyapı sağlaması planlanmaktadır. 【9】
Bütün bunlar bize basit fakat önemli bir gerçeği hatırlatıyor:
Dijital dünyanın da betonu, elektriği, kablosu ve soğutma sistemi var.
Veri, model ve algoritmalar ne kadar soyut görünürse görünsün, yapay zekâ fiziksel altyapıdan bağımsız değil. Dijital yetkinlik de yalnızca iyi yazılım geliştirmekle değil, o yazılımın çalışacağı altyapıya erişebilmekle güçleniyor.
Buraya kadar veri, dil modeli, süper bilgisayar ve veri merkezi gibi farklı teknolojilerden söz ettik. Fakat bunların hiçbiri tek başına dijital bağımsızlık anlamına gelmiyor.
Burada “bağımsızlık” kelimesini doğru tanımlamak gerektiğini düşünüyorum.
Dijital bağımsızlık, Türkiye'nin kullandığı bütün işlemcileri, yazılımları ve teknolojileri yalnız başına üretmesi demek değil. Günümüz teknolojisi küresel bir bilgi ve üretim ekosistemi üzerinde yükseliyor. Açık kaynak projeler, uluslararası bilimsel çalışmalar ve küresel tedarik zincirleri modern teknolojinin önemli parçaları.
Asıl mesele dünyadan kopmak değil, dünyaya hangi kapasiteyle bağlandığımız.
Dijital egemenlik üzerine akademik çalışmalar da konuyu yalnızca fiziksel sınırlar ya da teknolojinin nerede üretildiği üzerinden değerlendirmiyor. Huw Roberts, dijital egemenliği dijital teknolojiler üzerinde kimin kontrol ve karar yetkisine sahip olduğu sorusuyla ilişkilendiriyor. 【10】
Bu açıdan bakıldığında dijital bağımsızlık, her teknolojiyi tek başına üretmekten çok, kritik teknolojiler üzerinde söz sahibi olabilecek bilgiye, altyapıya ve alternatif geliştirme kapasitesine sahip olmakla ilgilidir.
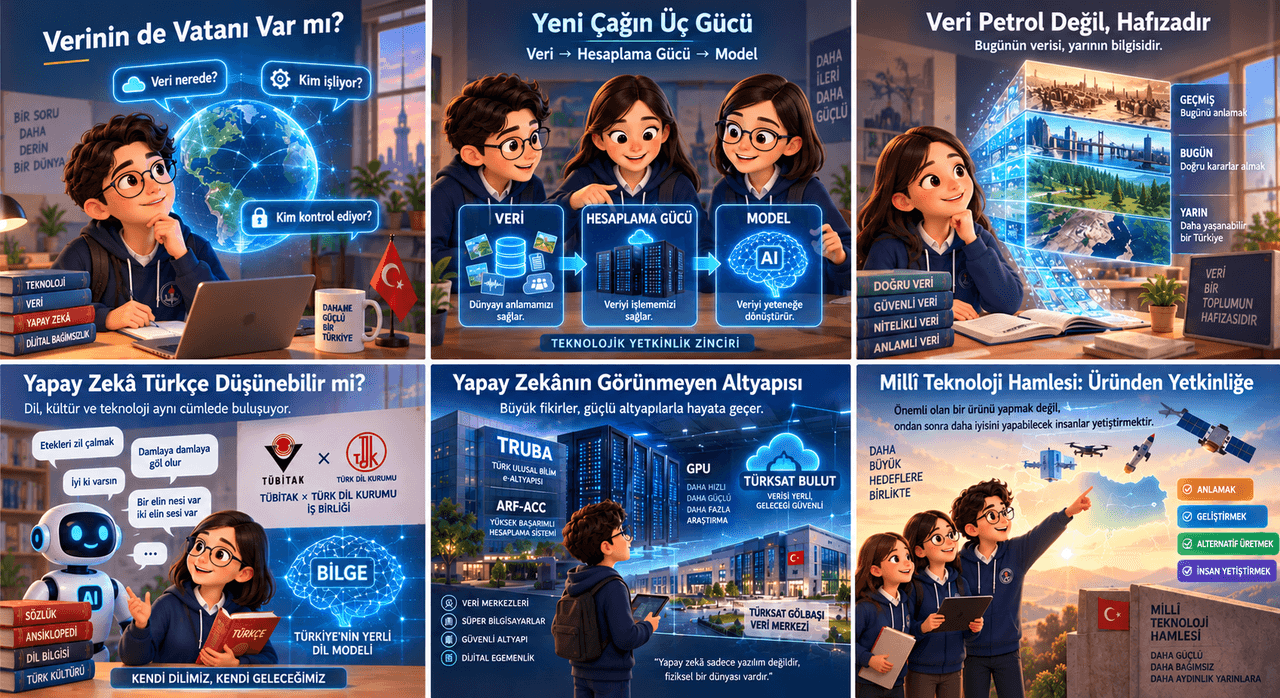
Teknolojik Yetkinlik ve İnsan Kaynağı İlişkisini Gösteren Temsili Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Çünkü bağımlılık bazen bir ürünü dışarıdan satın almaktan çok, o ürün olmadığında yerine ne koyacağını bilememektir.
Bir ülkenin kullandığı teknolojiyi anlayabilecek, güvenliğini değerlendirebilecek, ihtiyaçlarına göre değiştirebilecek ve gerektiğinde alternatifini geliştirebilecek insan kaynağı varsa hareket alanı da genişler.
Bu nedenle:
Dijital bağımsızlığın ölçüsü duvarların yüksekliği değil, seçeneklerin genişliğidir.
Millî Teknoloji Hamlesi'ni de yalnızca ortaya çıkan ürünler üzerinden değerlendirmek eksik olur. Bir uydu, yapay zekâ modeli ya da süper bilgisayar elbette önemlidir; ancak bundan daha önemli bir soru vardır:
O üründen sonra bir sonrakini yapabilecek miyiz?
Çünkü teknoloji hızla değişiyor. Bugünün gelişmiş modeli birkaç yıl sonra eskiyebilir. Bugün güçlü kabul edilen bir bilgisayar zaman içinde sıralamalarda gerileyebilir. Yazılım mimarileri, işlemciler ve veri merkezi teknolojileri sürekli yenileniyor.
Kalıcı olan tek tek ürünler değil, üretebilme yeteneğidir.
Bu konuyu araştırırken veri merkezlerinden, süper bilgisayarlardan ve milyarlarca parametreli modellerden söz etmek kolaydı. Hepsinin sayılarla ölçülebilen özellikleri var. Fakat bütün bu sistemlerin arkasındaki en önemli parçanın bir sayı olmadığını düşünüyorum:
İnsan.
Sonuçta bir yapay zekâ modelini geliştiren de, veri merkezini kuran da, yeni bir algoritmayı deneyen de insanlar.
Burada öğrencilerin de bu zincirin dışında olmadığını düşünüyorum. Bugün okulda ilk kez kod yazan bir öğrenci için yaptığı çalışma çok basit görünebilir. Ama teknolojiyle ilgilenmeye devam ettiğinde birkaç yıl sonra daha büyük projeler geliştirebilir, üniversitede araştırma yapabilir ya da hiç düşünülmemiş bir probleme yeni bir çözüm bulabilir.
Bence Millî Teknoloji Hamlesi'nin en önemli yönlerinden biri de burada.
Sadece teknoloji üretmek değil, teknoloji üretebilecek insanlar yetiştirmek.
Çünkü bir ürün eskidiğinde yenisini geliştirecek olan yine insan.
Bu yazıya başlarken “Verinin de vatanı var mı?” sorusunu daha çok merak uyandıran bir başlık olarak görüyordum. Araştırdıkça bu sorunun tek kelimelik bir cevabı olmadığını fark ettim.
Verinin pasaportu yok. Sınır kapılarında durmuyor. İnternet üzerinden saniyeler içinde başka ülkelere ulaşabiliyor. Aynı veri bir yerde üretilebilir, başka yerde saklanabilir ve başka bir ülkedeki bilgisayarlarda işlenebilir.
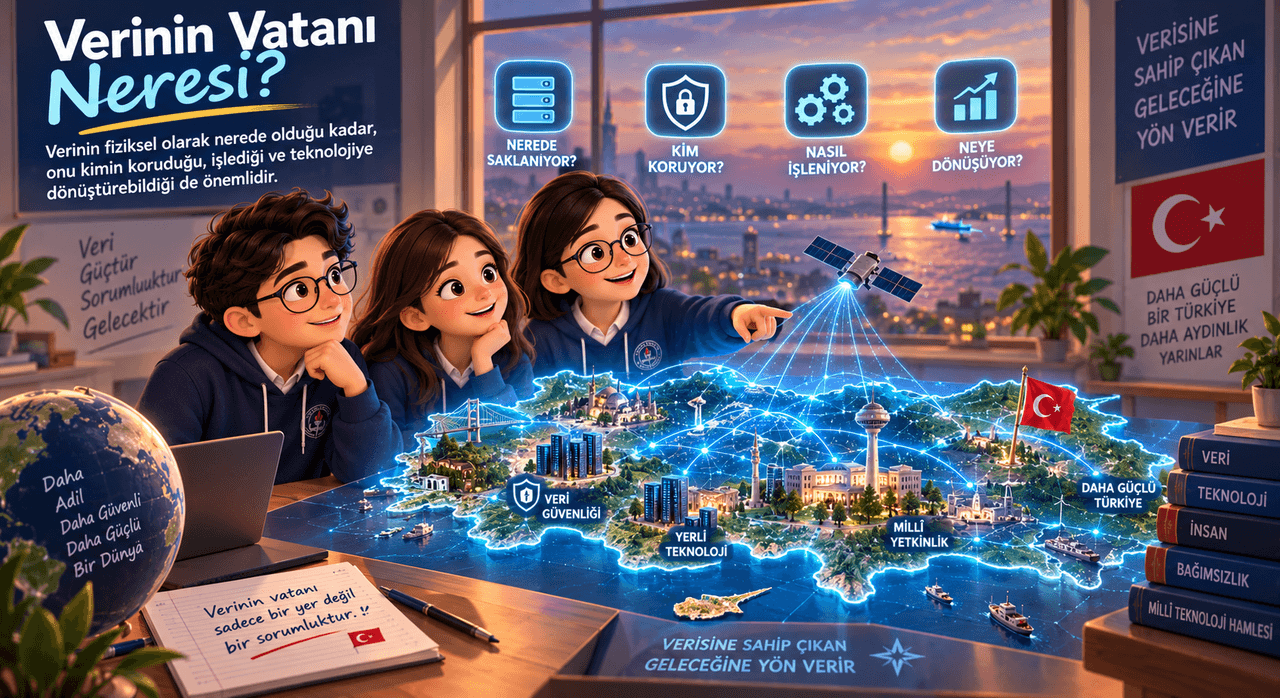
Verinin Korunması, İşlenmesi ve Teknolojiye Dönüştürülmesini Gösteren Temsili Görsel (Yapay Zekâ ile Oluşturulmuştur.)
Bu nedenle artık benim için asıl mesele verinin yalnızca nerede bulunduğu değil.
O veriyle ne yapabildiğimiz.
Kendi verimizi güvenli biçimde saklayabiliyor muyuz? Onu işleyecek altyapımız var mı? Ondan yeni bilgiler çıkarıp kendi teknolojilerimizi geliştirebiliyor muyuz?
Bir yapay zekâya birkaç saniyede sorduğumuz basit bir sorunun arkasında aslında veri merkezlerinden işlemcilere, dil modellerinden araştırmacılara kadar çok büyük bir sistem bulunuyor. Bu yüzden yapay zekânın yalnızca bir uygulama olmadığını; birçok farklı teknolojinin ve insanın bir araya geldiği bir ekosistem olduğunu düşünüyorum.
Millî Teknoloji Hamlesi'ni de bu açıdan yalnızca ortaya çıkan ürünlerle değil, yeni ürünleri geliştirebilme kapasitesiyle değerlendirmek gerekiyor.
Belki verinin gerçekten bir vatanı yoktur.
Ama bir toplum kendi verisini koruyabiliyor, anlayabiliyor ve onu yeni teknolojiler üretmek için kullanabiliyorsa kendi dijital geleceği üzerinde daha fazla söz sahibi olabilir.
Bence yapay zekâ çağındaki bağımsızlık da biraz burada başlıyor.
Acikgoz, Emre Can, Mete Erdogan ve Deniz Yuret. “Bridging the Bosphorus: Advancing Turkish Large Language Models through Strategies for Low-Resource Language Adaptation and Benchmarking.” Proceedings of the Fourth Workshop on Multilingual Representation Learning (MRL 2024). (2024): 242–268. Erişim 9 Eylül 2026. https://aclanthology.org/2024.mrl-1.21.pdf
Er, Yakup Abrek, Ilker Kesen, Gözde Gül Şahin ve Aykut Erdem. “Cetvel: A Unified Benchmark for Evaluating Language Understanding, Generation and Cultural Capacity of LLMs for Turkish.” Proceedings of the 19th Conference of the European Chapter of the Association for Computational Linguistics (Volume 1: Long Papers). (2026): 1052–1085. Erişim 9 Eylül 2026. https://aclanthology.org/2026.eacl-long.46.pdf
Roberts, Huw. “Digital Sovereignty and Artificial Intelligence: A Normative Approach.” Ethics and Information Technology 26 (2024): Article 70. Erişim 9 Eylül 2026. https://link.springer.com/content/pdf/10.1007/s10676-024-09810-5.pdf
T.C. Sanayi ve Teknoloji Bakanlığı. “Türkiye Yapay Zekâ Eylem Planı Açıklandı.” T.C. Sanayi ve Teknoloji Bakanlığı. Erişim 9 Eylül 2026. https://www.sanayi.gov.tr/medya/haber/turkiye-yapay-zek%C3%A2-eylem-plani-aciklandi
T.C. Sanayi ve Teknoloji Bakanlığı. “Türkiye'nin Yerli Dil Modeli ‘BİLGE’ Geliştiricilerin Kullanımına Açılıyor.” T.C. Sanayi ve Teknoloji Bakanlığı. Erişim 9 Eylül 2026. https://www.sanayi.gov.tr/medya/haber/turkiyenin-yerli-dil-modeli-bilge-gelistiricilerin-kullanimina-aciliyor
TOP500. “ARF ACC – ThinkSystem SD650-N V3.” TOP500. Erişim 9 Eylül 2026. https://www.top500.org/system/180350/
TÜBİTAK ULAKBİM. “ARF-ACC Süper Bilgisayarlarımızdan Performans Artışı!” TÜBİTAK ULAKBİM. Erişim 9 Eylül 2026. https://ulakbim.tubitak.gov.tr/arf-acc-super-bilgisayarlarimizdan-performans-artisi/
Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK). “TÜBİTAK ve TDK Dijitalde Güçlerini Birleştiriyor.” TÜBİTAK. Erişim 9 Eylül 2026. https://tubitak.gov.tr/tr/haber/tubitak-ve-tdk-dijitalde-guclerini-birlestiriyor
Türksat Uydu Haberleşme Kablo TV ve İşletme A.Ş. “Türksat Bulut ile Türkiye'nin Verisi Yerli Altyapıda Yükselecek.” TÜRKSAT. Erişim 9 Eylül 2026. https://www.turksat.com.tr/kurumsal/basin-medya/haberler/turksat-bulut-ile-turkiyenin-verisi-yerli-altyapida-yukselecek
Türksat Uydu Haberleşme Kablo TV ve İşletme A.Ş. “Türksat Gölbaşı Veri Merkezi'nin Temeli Atıldı.” TÜRKSAT. Erişim 9 Eylül 2026. https://www.turksat.com.tr/kurumsal/basin-medya/haberler/turksat-golbasi-veri-merkezinin-temeli-atildi
[1]
T.C. Sanayi ve Teknoloji Bakanlığı, “Türkiye Yapay Zekâ Eylem Planı Açıklandı,” T.C. Sanayi ve Teknoloji Bakanlığı, erişim 9 Eylül 2026, https://www.sanayi.gov.tr/medya/haber/turkiye-yapay-zek%C3%A2-eylem-plani-aciklandi
[2]
Emre Can Acikgoz, Mete Erdogan ve Deniz Yuret, “Bridging the Bosphorus: Advancing Turkish Large Language Models through Strategies for Low-Resource Language Adaptation and Benchmarking,” Proceedings of the Fourth Workshop on Multilingual Representation Learning (MRL 2024) (2024), s. 242, erişim 9 Eylül 2026, https://aclanthology.org/2024.mrl-1.21.pdf
[3]
Yakup Abrek Er, Ilker Kesen, Gözde Gül Şahin ve Aykut Erdem, “Cetvel: A Unified Benchmark for Evaluating Language Understanding, Generation and Cultural Capacity of LLMs for Turkish,” Proceedings of the 19th Conference of the European Chapter of the Association for Computational Linguistics (Volume 1: Long Papers) (2026), s. 1052, erişim 9 Eylül 2026, https://aclanthology.org/2026.eacl-long.46.pdf
[4]
Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK), “TÜBİTAK ve TDK Dijitalde Güçlerini Birleştiriyor,” TÜBİTAK, erişim 9 Eylül 2026, https://tubitak.gov.tr/tr/haber/tubitak-ve-tdk-dijitalde-guclerini-birlestiriyor
[5]
T.C. Sanayi ve Teknoloji Bakanlığı, “Türkiye'nin Yerli Dil Modeli ‘BİLGE’ Geliştiricilerin Kullanımına Açılıyor,” T.C. Sanayi ve Teknoloji Bakanlığı, erişim 9 Eylül 2026, https://www.sanayi.gov.tr/medya/haber/turkiyenin-yerli-dil-modeli-bilge-gelistiricilerin-kullanimina-aciliyor
[6]
TÜBİTAK ULAKBİM, “ARF-ACC Süper Bilgisayarlarımızdan Performans Artışı!,” TÜBİTAK ULAKBİM, erişim 9 Eylül 2026, https://ulakbim.tubitak.gov.tr/arf-acc-super-bilgisayarlarimizdan-performans-artisi/
[7]
TOP500, “ARF ACC – ThinkSystem SD650-N V3,” TOP500, erişim 9 Eylül 2026, https://www.top500.org/system/180350/
[8]
Türksat Uydu Haberleşme Kablo TV ve İşletme A.Ş., “Türksat Bulut ile Türkiye'nin Verisi Yerli Altyapıda Yükselecek,” TÜRKSAT, erişim 9 Eylül 2026, https://www.turksat.com.tr/kurumsal/basin-medya/haberler/turksat-bulut-ile-turkiyenin-verisi-yerli-altyapida-yukselecek
[9]
Türksat Uydu Haberleşme Kablo TV ve İşletme A.Ş., “Türksat Gölbaşı Veri Merkezi'nin Temeli Atıldı,” TÜRKSAT, erişim 9 Eylül 2026, https://www.turksat.com.tr/kurumsal/basin-medya/haberler/turksat-golbasi-veri-merkezinin-temeli-atildi
[10]
Huw Roberts, “Digital Sovereignty and Artificial Intelligence: A Normative Approach,” Ethics and Information Technology 26, no. 70 (2024), s. 1, erişim 9 Eylül 2026, https://link.springer.com/content/pdf/10.1007/s10676-024-09810-5.pdf
Yeni Çağın Üç Gücü
Veri Petrol Değil, Hafızadır
Yapay Zekâ Türkçe Düşünebilir mi?
Yapay Zekânın Görünmeyen Altyapısı
Millî Teknoloji Hamlesi: Üründen Yetkinliğe
Verinin Vatanı Neresi?