
Çok sayıda haber kaynağını takip etmek zaman alır; aynı haberin farklı kaynaklarda tekrarlanması ve haberlerdeki gereksiz ayrıntılar da takibi zorlaştırır. Bu sorun, internetteki haberleri toplayıp yalnız okurun ilgilendiği içerikleri filtreleyen ve özetleyen bir haber otomasyonu sistemiyle azaltılabilir.
Yazı boyunca verilen sayılar, bu yaklaşımla kurulan bir hattın (pipeline) sekiz günlük ölçüm penceresinden alınmıştır. Bu kurulum 450'nin üzerinde kaynağı (büyük çoğunluğu RSS beslemesi, bir miktar YouTube kanalı ve birkaç etkinlik sitesi; liste günden güne değişir) bir düzine kategori altında izler ve günde birkaç kez koşar. Pencere boyunca günde ortalama 2.650 ham haber alınmış, bunların 1.120'si kategorilenmiş, doğrulanmış ve özetlenmiş hâle getirilmiştir; okura ise her kategoriden yalnız en iyileri gider. Aksi belirtilmedikçe sayılar bu pencerenin medyan değerleridir.
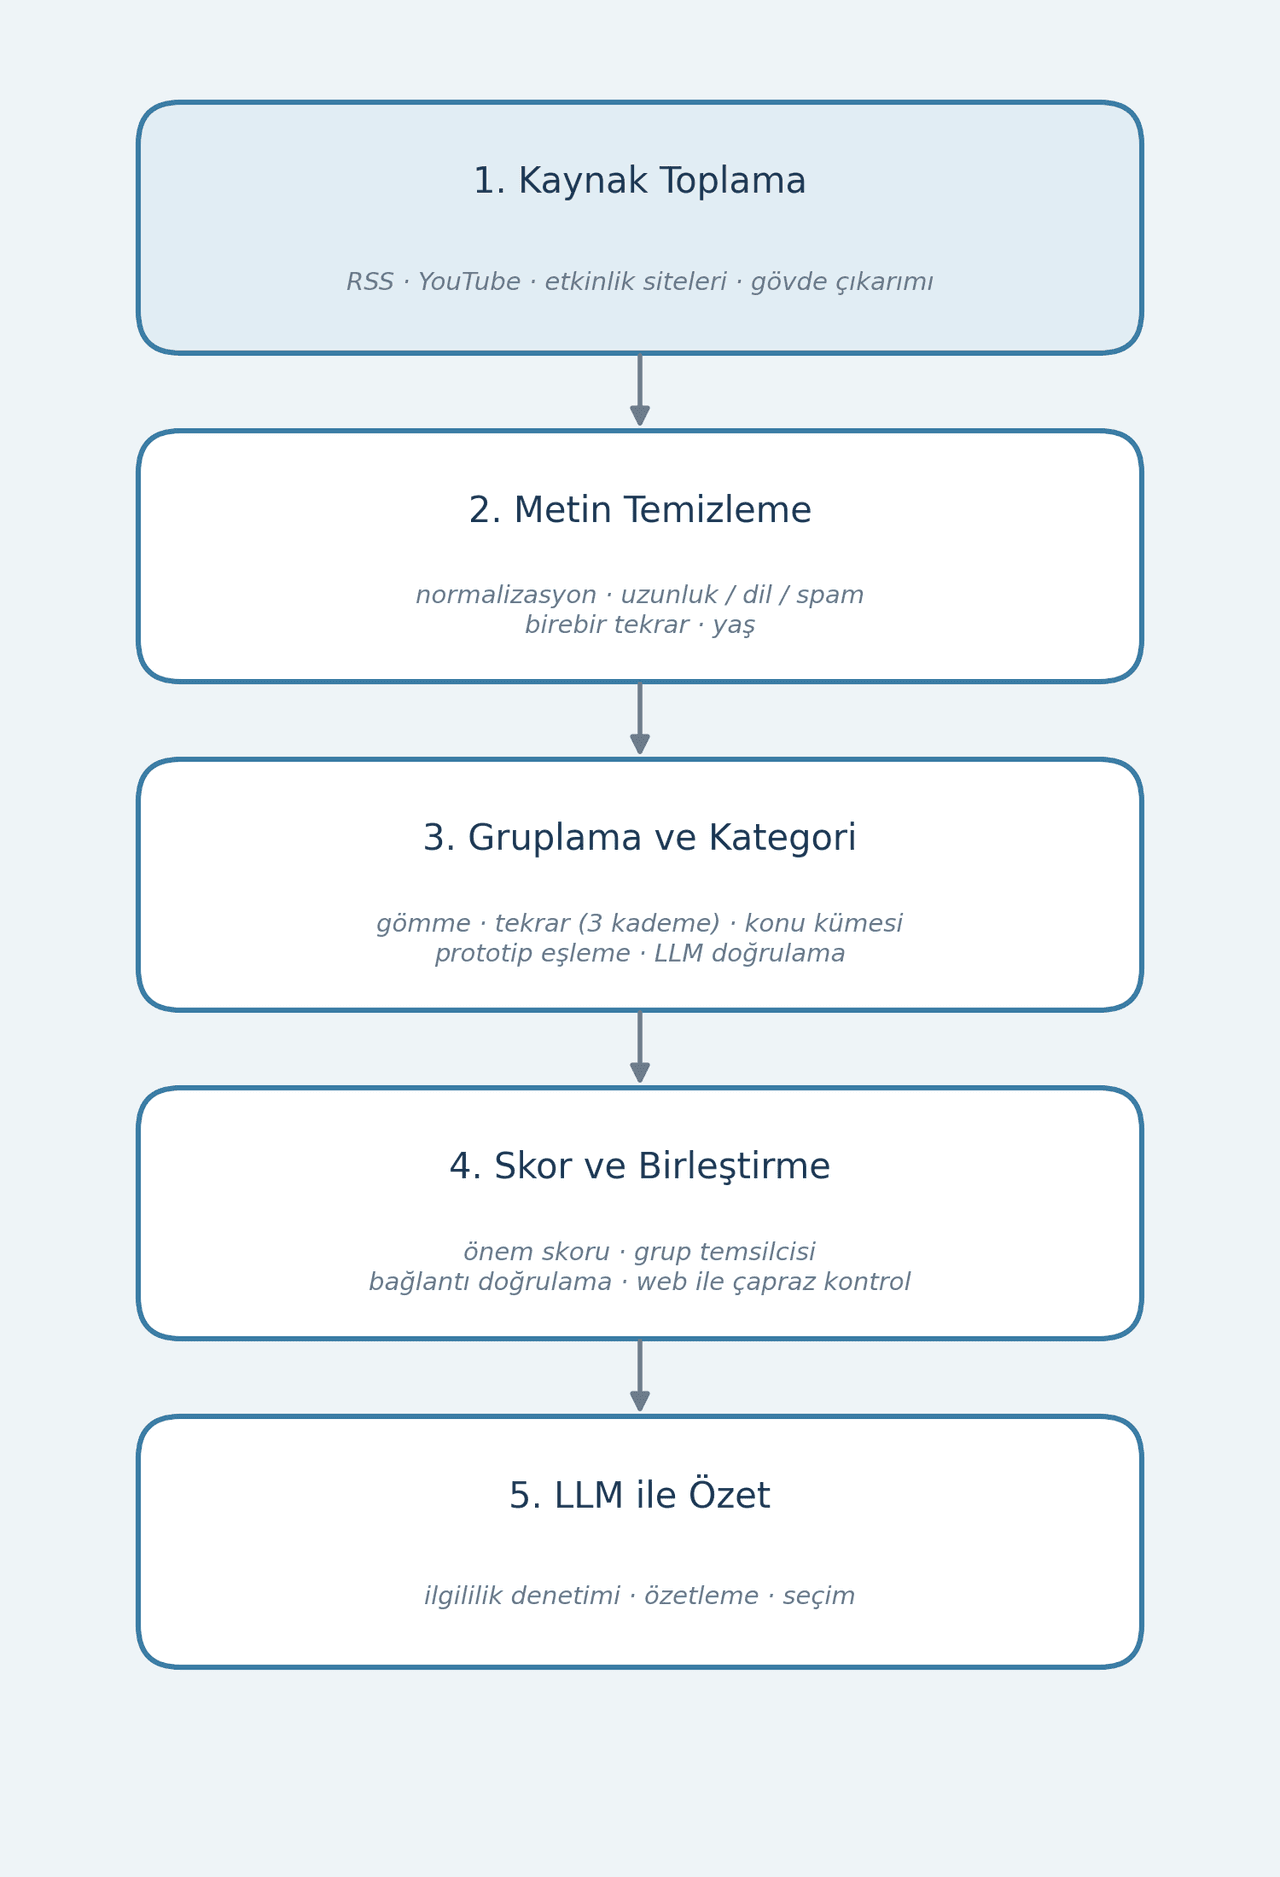
Kaynak Toplamadan LLM ile Özetlemeye Haber Otomasyonu Hattının Adımları (Yapay Zeka ile Oluşturulmuştur.)
Böyle bir hat beş temel adımla kurulabilir:
Bu adımların her biri bir eleme adımıdır: hat bir huni gibi çalışır ve ucuz adımlar pahalı adımlara ulaşan haber sayısını düşürür. Bir günde giren haberlerin yaklaşık %42'si hattın sonuna ulaşır; gerisi tekrar, kapsam dışı, kalitesiz ya da doğrulanamayan içerik olarak yolda elenir.
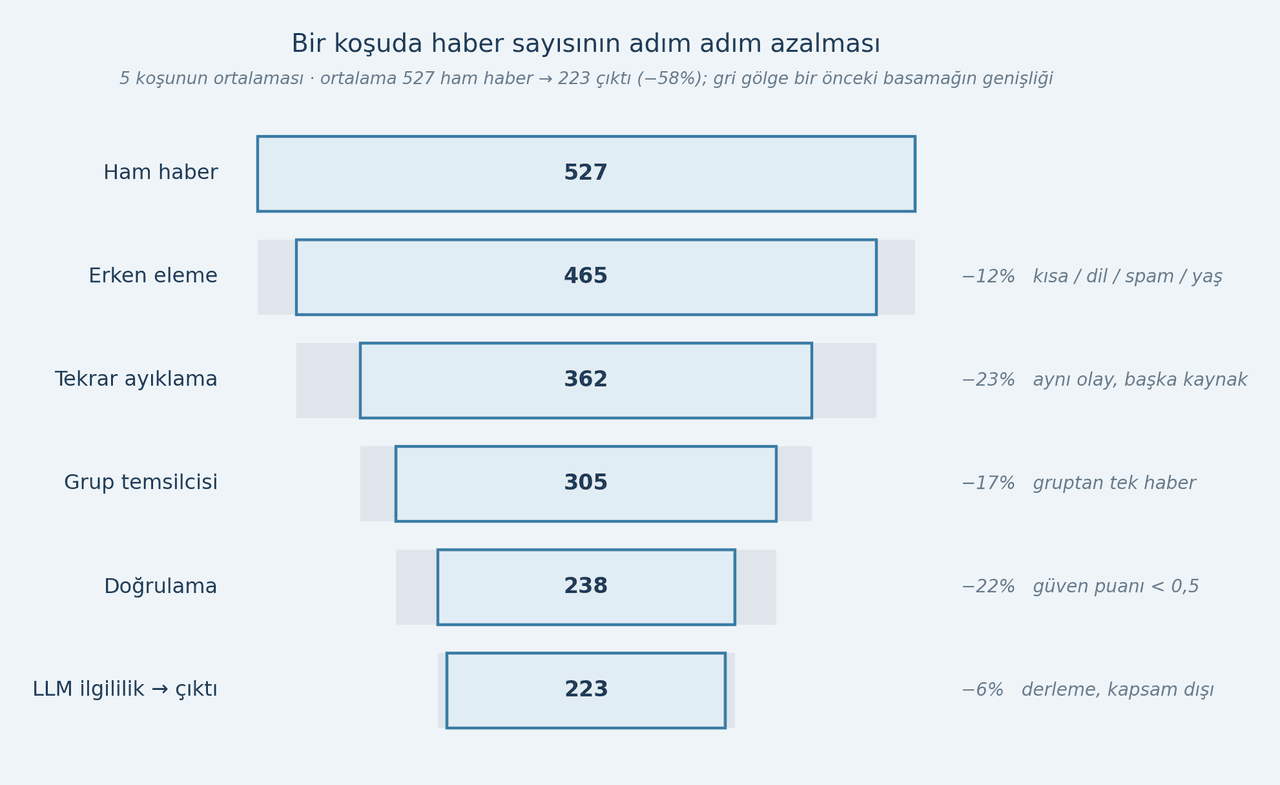
Beş Koşunun Ortalamasında Aşamalara Göre Haber Sayısındaki Azalma (Yapay Zeka ile Oluşturulmuştur.)
Haberler, insanların ilgilendikleri konulardaki güncel gelişmeleri öğrenmesinin önemli bir yoludur. Haber sayılabilecek ilk kaynaklar, M.Ö 1. yüzyılda Roma'da kamuya duyurulan resmi günlük bildirilerdir (bkz. Acta Diurna: Günlük İşler).【1】 O dönemden bu yana güncel bilgiye ulaşmanın yolları değişmiştir: modern dönemde bu ihtiyacı gazeteler karşılarken günümüzde televizyon ve internet kaynakları gazetelerin yerini almıştır.
Küreselleşmeyle birlikte haberler artık yerel olaylarla sınırlı kalmamaktadır. Artan nüfus, gelişen endüstri ve küreselleşme gibi etkenler nedeniyle günlük potansiyel haber sayısı yüksektir. Bu ihtiyaca yanıt olarak çok sayıda haber kanalı, internet sayfası ve sosyal medya hesabı ortaya çıkmıştır. Ancak birçok kaynak aynı haberleri paylaşmakta ve bu haberlerde gereksiz ayrıntılara yer vererek okurun işini zorlaştırmaktadır. Ayrıca istenen kategorilerdeki haberleri kapsayıcı biçimde takip edebilmek için çok sayıda farklı kaynağın izlenmesi gerekmektedir.
Ölçek fikir verir: yalnız bir düzine konu başlığını kapsayıcı biçimde izlemek için 450'nin üzerinde kaynak gerekti ve bu kaynaklar günde 2.000–3.000 ham haber üretiyor. Bir okurun bunu elle taraması mümkün değildir; haberlerin yarıdan fazlası ise ya tekrar ya da kapsam dışıdır.
Bu soruna yönelik olarak internetteki haberler toplanıp belirli işlemlerden geçirilerek yalnız kullanıcının istediği ve işine yarayabilecek haberler filtrelenebilir ve özetlenebilir. Böylece okurun çok sayıda haber kaynağını takip ederken harcadığı zaman önemli ölçüde azalabilir ve okur buna rağmen daha kapsayıcı bilgi edinebilir.
Böyle bir haber otomasyonu sistemi oluşturmanın en önemli adımlarından biri, sisteme giren kaynakların belirlenmesi ve bu kaynakların uygun formatta, uygun fonksiyonlarla kullanıma hazır hâle getirilmesidir. RSS bu ihtiyaç için pratik bir çözüm sunar.【2】 RSS, internet sitelerinin içeriğini kısa, sade ve belirli yapılarda özetleyen bir sistemdir. Küçük farklılıklarla birlikte RSS içinde içerik başlığı, bağlantı adresi, kısa açıklama ve yayımlanma tarihi gibi temel bilgiler yer alır. Bu bilgiler bir sisteme kolaylıkla bağlanabilir; RSS özellikle yeni gönderi bildirimi gibi uygulamalarda yaygın olarak kullanılır.
Örnek RSS kaydı (kurgusal içerik):
<item>
<title>A takımı B takımını 1-0 yendi</title>
<link>https://www.example.com/haber/12345</link>
<description>Karşılaşmanın kısa özeti.</description>
<pubDate>Tue, 06 Oct 2026 14:30:00 +0300</pubDate>
</item>
RSS adresleri yalnız metin içerdiği için boyutları çok küçüktür. Bu sayede bu adreslere istek göndermek düşük maliyetli ve hızlı bir işlemdir. Ancak birçok haber sitesinde RSS bulunsa da her internet sitesinin RSS kaynağı yoktur.
Artımlı Çekim: Her kaynak için son başarılı çekim zamanı ve daha önce görülmüş kayıt kimlikleri saklanır; her koşuda yalnız yeni kayıtlar hatta alınır. Böylece maliyet, izlenen kaynak sayısıyla değil o aralıkta yayımlanan yeni haber sayısıyla ölçeklenir. Hat günde birkaç kez koşar; gecenin birikimini alan sabah koşusu en büyüğüdür (800'ün üzerinde ham haber, bir saate yakın), gün içindeki koşular ise yaklaşık 480 haber ve yarım saattir.
Paralel Çekim ve Hata İzolasyonu: Kaynaklar bir iş parçacığı havuzunda eşzamanlı çekilir ve her kaynağın hatası kendi içinde kalır: bozuk bir besleme koşuyu düşürmez, o kaynak "başarısız" işaretlenir ve sonraki koşuda yeniden denenir. Bunun bir incelik değil zorunluluk olduğunu ölçüm gösterir: her koşuda kaynakların yaklaşık %12'si hata verir ve bunların büyük bölümü (yaklaşık 50 kaynak) sekiz gün boyunca her koşuda hata vermiştir (taşınmış, kapatılmış ya da bot trafiğini engelleyen beslemeler). Aynı pencerede kaynakların yalnız üçte ikisi en az bir haber üretmiş, en verimli 20 kaynak toplam hacmin yaklaşık yarısını sağlamıştır. Kaynak listesi durağan değildir; ölü beslemelerin düzenli ayıklanması gerekir.
RSS çoğu zaman "tadımlık" taşır, pek çok kaynak RSS'e yalnız başlık ve bir iki cümle koyar; haberin gövdesi sayfadadır. Metin belirli bir uzunluğun altındaysa hedef sayfa indirilir ve makale gövdesi, reklam, gezinti menüsü ve site düzeninden açık kaynak bir "boilerplate removal" kütüphanesiyle ayrıştırılır.【3】 Bu işlem bir sonraki adımdaki temizlemenin gerçek yükünü oluşturur. Bazı RSS'ler de asıl habere değil bir haber toplayıcının yönlendirme adresine bağlanır; gerçek kaynağa ulaşmak için adresin çözülmesi gerekir, bu da hız sınırı ve geri çekilme (backoff) mantığı ister.
RSS kaynağı olmayan internet sitelerinde otomasyon için siteye özel çözümler geliştirmek gerekir. Bu çözümler karmaşık oldukları için hem entegrasyon aşamasında maliyetlidir hem de çalışma sırasında yavaşlığa ve fazla kaynak kullanımına yol açar. Hat bu nedenle RSS dışına seçici biçimde genişletildi: YouTube kanalları için videonun transkripti alınır (30 dakikadan uzun videolar atlanır, uzun transkriptler baş ve son kısımları korunarak kısaltılır) ve etkinlik siteleri için etkinlik adı, tarihi ve mekânı ayrı bir akışta toplanır. Diğer sosyal medya kaynakları da aynı mantıkla eklenebilir.
Kaynaklar toplandıktan sonra çeşitli filtrelemeler gerekir:
Haber metnine ait olmayan kısımlar reklam, yapısal kod parçacıkları, istenmeyen içerik (spam) ve site düzenine ait bölümler gibi geniş bir yelpazeyi kapsadığından bu temizlik kapsamlı bir iştir. Bu aşamada ayıklanan bazı bilgiler, örneğin haber kaynağı ve haber tarihi, sonraki işlemlerde kullanılmak üzere ayrıca saklanır. Her habere, normalize edilmiş içeriğinin kriptografik özetinden türeyen bir kimlik verilir; aynı haber iki koşuda iki kez gelirse aynı kimliği alır. Bu kimlik, tekrar ayıklamanın ve "Bu haber yayınlandı mı" takibinin temelidir.
Temizlemenin hemen ardından, hiçbir model çağrısı yapılmadan bir erken eleme gelir. Kurallar ucuz ve kesindir.
Tablo 1: Erken Eleme Kuralları
Bu kurallar bu kurulumda ham haberlerin ortalama %12'sini eler. Önemli olan sayıdan çok sıralamadır: elenen her haber, gömme ve LLM adımlarında ödenmeyecek bir maliyettir.
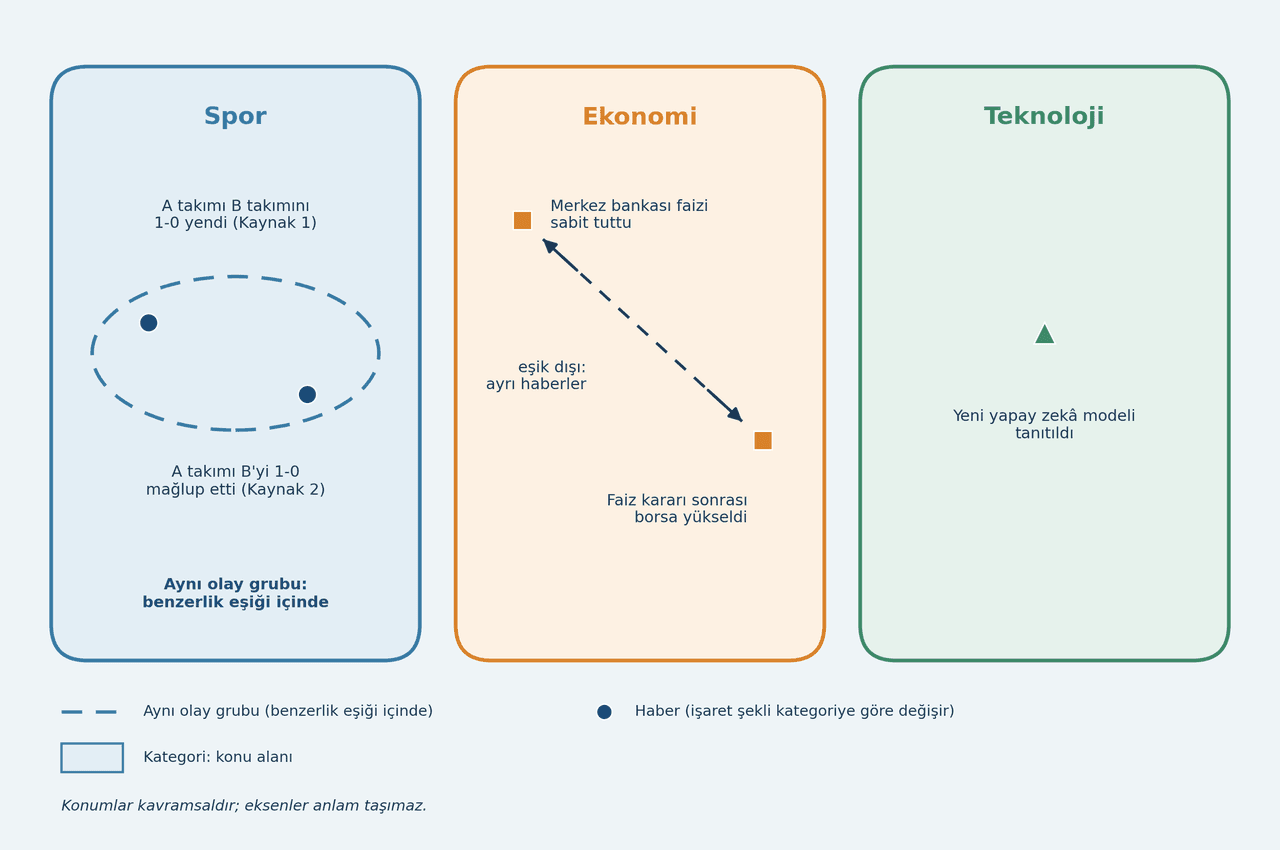
Gömme Uzayında Haberlerin Gruplanması ve Kategorilendirilmesi (Yapay Zeka ile Oluşturulmuştur.)
Tekrar eden veya istenmeyen konulara ait haberlerin ayıklanmasında yapısal fonksiyonlar yetersiz kalır. Bu işlem için maliyet ve kalite dengesi açısından uygun bir çözüm, gömme modeli kullanmaktır. Gömme modeli, bir metni anlamını temsil eden sayısal bir vektöre dönüştürür; anlamca benzer metinlerin vektörleri uzayda birbirine yakın konumlanır. İki vektörün yakınlığı kosinüs benzerliğiyle ölçülür: 1,0 aynı yön, 0 ilgisiz. Gömme modelinin buradaki görevi, tekrar eden haberleri gömme uzayında (embedding space) birbirine yakın konumlara yerleştirerek gruplamayı mümkün kılmaktır.
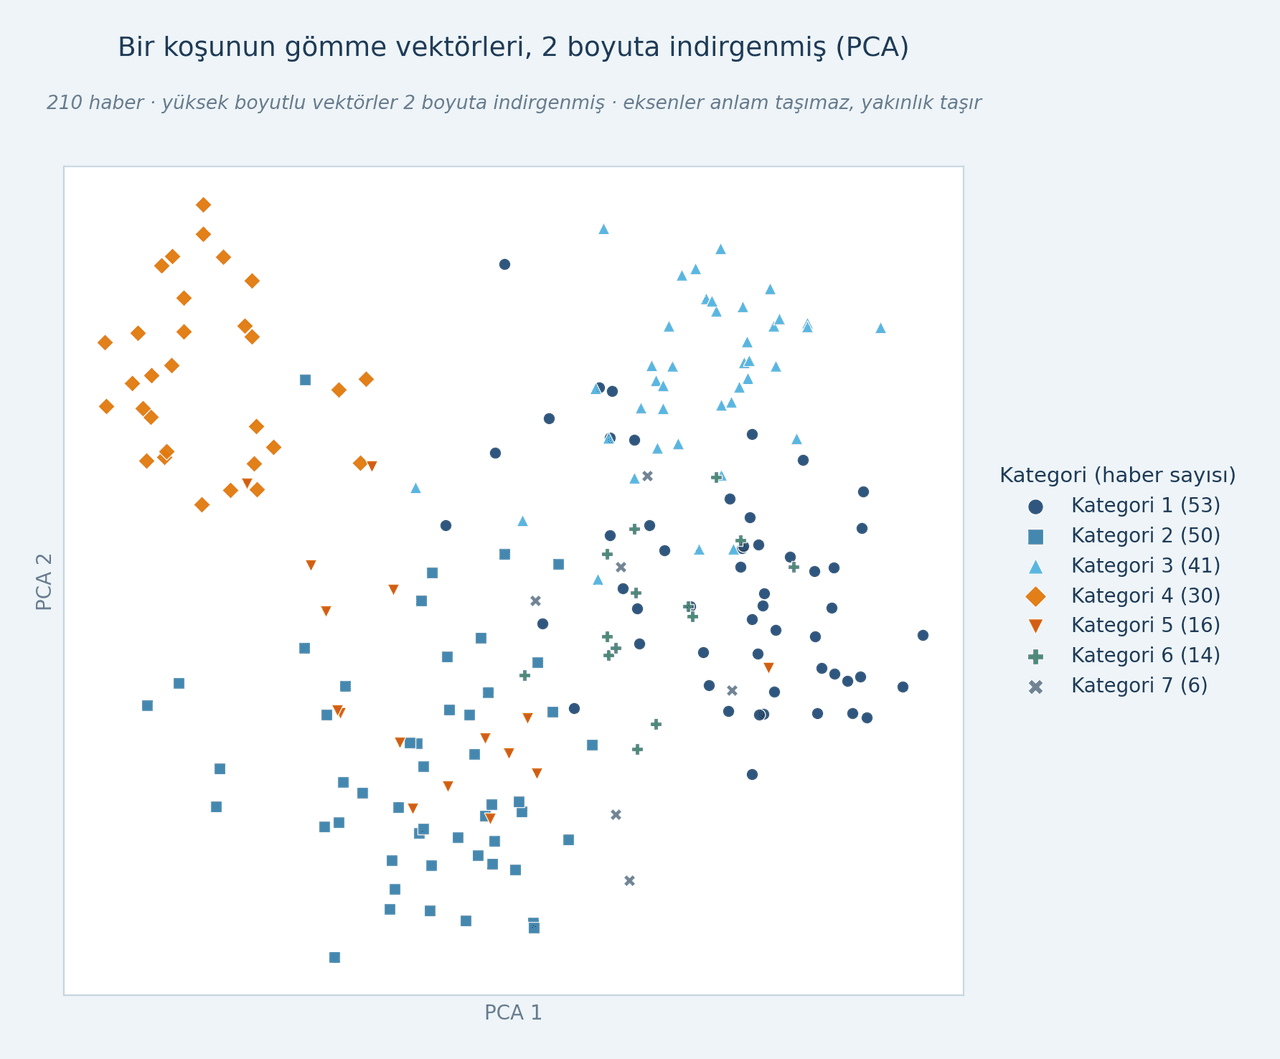
PCA ile İki Boyuta İndirgenmiş Gömme Vektörleri Dağılımı (Yapay Zeka ile Oluşturulmuştur.)
Benzer bir mantıkla kategorilendirme de yapılabilir: kategoriler uygun ve kapsamlı cümlelerle tanımlanıp gömme uzayına yerleştirilirse bu tanım cümlelerine yakın konumdaki içeriklerin ilgili kategoriye ait olduğu belirlenebilir.
Bu aşamada gömme modelinin yetenekleri belirleyicidir; model özellikle kullanılan dil veya dilleri desteklemelidir. Gömme adımı bir koşunun tamamı için yaklaşık 10 saniye sürer ve maliyeti hattın toplamında yüzde birin altındadır; hattın en ucuz kalemi. Vektörler yerel bir veri tabanında saklanır, her kaydın 14 günlük ömrü vardır ve bu ömür tekrar ayıklama penceresini belirler.
Gömme uzayındaki "yakınlık" matematiksel olarak tanımlanırken kullanılan uzaklık sınırları (eşik değerleri) dikkatle belirlenmelidir. Aksi takdirde benzer olmayan haberler filtrelenebilir ya da benzer haberler filtrelenmeyebilir; kategori eşleştirmesi de yanlış veya eksik olabilir. Hatta aynı benzerlik ekseni üzerinde üç ayrı eşik çalışır:
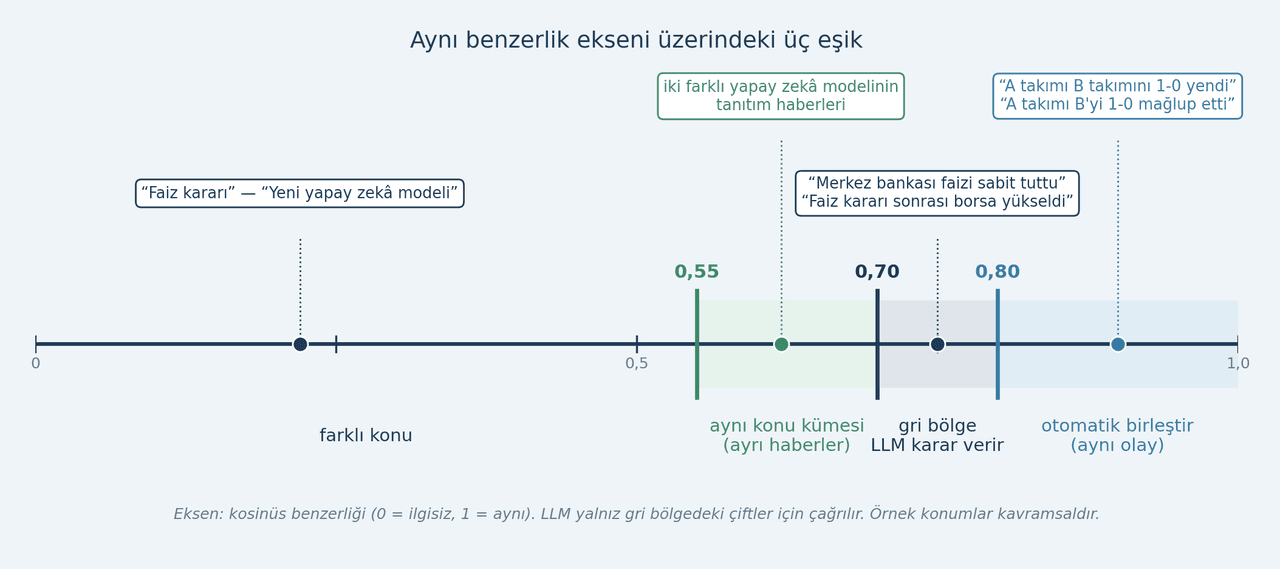
Benzerlik Ekseni Üzerindeki Eşik Değerleri (Yapay Zeka ile Oluşturulmuştur.)
Önceki koşulardan gelen tarihsel tekrarlar da aynı yoldan elenir: 14 günlük depo sayesinde dün gelen bir haber bugün başka bir kaynaktan tekrar geldiğinde yeni sayılmaz. Bu kurulumda tekrar ayıklama, erken elemeden geçen haberlerin ortalama %23'ünü eler; huninin en büyük basamağıdır.
Kategoriler, her biri kısa tanımlayıcı cümlelerden (prototip metinler) oluşan bir düzine ana kategori ve yüze yakın alt kategoriyle tanımlandı; örneğin bir alt kategori "üretken yapay zekâ, görsel üretimi, büyük dil modelleri" gibi birkaç cümleyle anlatılır. Her haber en yakın prototipe atanır, ama bir güven eşiği vardır (0,52); altındaki atamalar şüpheli sayılır.
Kaynağın kendi etiketi -örneğin bir gazetenin "teknoloji" beslemesinden gelmiş olmak- bir ipucu olarak kullanılır, gerçek olarak değil. Prototip benzerliği zayıfsa LLM'e "Bu haber gerçekten bu kategoride mi?" diye sorulur ve gerekirse kategori değiştirilir.
Gerçek bir örnek: Bir teknoloji beslemesinden gelen bir güvenlik/siyaset haberi prototiplere yalnız 0,44 benziyordu; LLM onu doğru kategoriye taşıdı ve haber, kapsam dışı olduğu için hattan çıktı. Burada da ilke aynıdır: LLM yalnız makinenin emin olamadığı durumlarda çağırılır. Kapsam dışı kategoriler (siyaset ve ekonomi gibi) bu doğrulamadan sonra hattan düşürülür. Bu kurulumda bu kapı nadiren çalışır, çünkü o kategorilerin beslemeleri zaten çekilmez; kapı, başka beslemelerden sızan haberler için bir emniyettir.
Dönemsel olarak bazı haberler, birkaç kelime dışında aynı ifadelerle farklı olayları anlatabilir. Spor müsabakaları buna örnektir: iki takımın farklı zamanlarda oynadığı maçlar aynı sonuçla bitse bile farklı olaylardır. Ancak "A takımı B takımını 1-0 yendi." haberi, iki maç için de gömme uzayında aynı konuma yerleştirilebilir. Bu tür sınır durumlarının (edge case) değerlendirilmesi ve uygun çözümler geliştirilmesi gerekir. Bu örnek için vektör deposundaki 14 günlük ömür yeterli olur: iki maç arasındaki süre pencereden uzunsa çakışma olmaz. Ancak bu çözüm her konuda yeterli değildir; haftalık ligler ve seri hâlinde gelen ürün duyuruları pencere içinde kalır. Bu çiftler çoğunlukla gri bölgeye düşer ve orada LLM'e sorulan soru tam da budur: "aynı konu" değil, "tam olarak aynı olay" mı? Yapılacak testler sonucunda sınır durumlarına özel algoritmaların geliştirilmesi normal ve gereklidir.
İnternet kaynaklarının bir diğer sorunu, doğruluklarının şüpheli olabilmesidir. Bu aşamada ilk önlem, RSS kaynaklarının dikkatle seçilmesidir. Güvenilir kaynaklardan başlamak, hattın sonraki adımlarına yanlış bilginin girme olasılığını azaltır. Ama tek önlem bu değildir; aşağıda anlatılan doğrulama adımları da aynı amaca hizmet eder.
Farklı kaynaklarda aynı haberin tekrar etmesi, haberin önemini belirleyen ölçütlerden biridir ama tek ölçüt değildir. Her habere 0 ile 1 arasında bir önem skoru atanır; skor dört bileşenin ağırlıklı toplamıdır.
Tablo 2: Haber Önem Skorunu Belirleyen Bileşenler ve Ağırlıkları
Üstüne kaynak türü bonusları eklenir — akademik yayın, resmi kurum/şirket blogu, kod deposu, `.org` alan adı — ve bilinen spam kaynakları ceza alır. Aynı olayı anlatan kaynak sayısı arttıkça kareyle büyüyen bir "viral" çarpanı devreye girer; böylece on kaynağın yazdığı haber, bir kaynağın yazdığından belirgin biçimde öne çıkar.
Sözcük çeşitliliği için düz tip/jeton oranı (type-token ratio) kullanılmaz; uzun metinlerde bu oran kendiliğinden düşer ve uzun, iyi yazılmış haberler cezalandırılır. Bunun yerine 100 sözcüklük kayan pencerelerde hesaplanan, uzunluktan bağımsız MATTR ölçütü kullanılır.【4】 Küçük bir ayrıntıdır, ama skorun en ağır bileşeninin sağlam olmasını sağlar.
Belirlenen bir eşik değeriyle, haberin kullanıcıya gösterilip gösterilmeyeceğine karar verilebilir. Bu eşik değeri, gruplamada kullanılan benzerlik eşiğinden ayrı bir değerdir ve ayrıca ayarlanmalıdır. Tekrar sayısı önemin göstergesidir, doğruluğun garantisi değildir; aynı yanlış bilgi birçok kaynakta yinelenebilir.
Skorlamadan sonra, aynı olayı anlatan haberlerin özetleme ve çeviri adımına ayrı ayrı gönderilmesi yerine birleştirilerek tek bir haber olarak yönetilmesi gerekir. Her olay grubundan en yüksek skorlu haber temsilci seçilir (Ortalama bir koşuda 362 haber 305 temsilciye iner, yani %17) ve grubun diğer kaynakları temsilcinin "ilgili bağlantılar" listesine eklenir. Farklı kaynaklar olaya farklı bakış açılarıyla yaklaşabilir veya birbiriyle çelişen bilgiler verebilir. Bu durumda çelişkili bilgiler sessizce tek bir sürüme indirgenmemeli; farklılıklar, kaynakları belirtilerek birleştirilmiş haberde korunmalıdır. Böylece LLM'ye her olay için tek ve bütünleşik bir girdi verilir ve tekrarlı çeviri ile özetleme işlemleri azaltılır.
Temsilci haberler özetlenmeden önce üç doğrulama katmanından geçer:
Önceki adımlar doğru ayarlanıp çalıştığında kullanıcının erişmesi gereken haberler hazır hâle gelir. Bu noktadan sonra haber farklı bir dildeyse istenen dile çevrilebilir, özetlenebilir, istenen üslupta yeniden yazılabilir ve haberdeki eksik bilgiler tamamlanabilir. Kaynakta eksik olan bilgilerin tamamlanması için pratik yollardan biri, bir önceki bölümde anlatılan web aramasıdır.
Hattaki LLM aşaması iki ayrı iş yapar. İlgililik denetimi, haberin tanımlı kategorilerin kapsamında olup olmadığına karar verir, derleme ve "en iyi 10" türü içerikleri eler ve etki (yerel/ulusal/küresel) ile yenilik (rutin/artımlı/çığır açıcı) etiketleri üretir; bu kurulumda doğrulamadan geçen haberlerin ortalama %6'sını eler. Özetleme ise kaynak türüne göre üç ayrı komutla çalışır: haber metni, video transkripti ve etkinlik duyurusu farklı yapıda özetlenir. Özetleme, eşzamanlı istekler gönderen asenkron bir istemciyle yapılır; buna rağmen hattın en uzun aşamasıdır (bir sonraki bölüm).
LLM seçiminde modelin hem kaynak dillerde hem de hedef dilde yetkin olması gerekir.
LLM'ye yapması gereken işlemleri açıklayan bir komut (prompt) verilmelidir. Komutun kalitesi çıktıların kalitesini doğrudan etkiler; komut dikkatle yazılmalı ve deneme-yanılma yöntemiyle geliştirilmelidir. Komut kadar önemli bir ayar da sıcaklıktır (temperature): modelin ne kadar "yaratıcı" davranacağını belirleyen, 0 ile 1 arasında bir değer. Hatta her görevin kendi sıcaklığı vardır.
Tablo 3: Görev Türlerine Göre Belirlenen LLM Sıcaklık Değerleri
Kural basit: karar isteyen görevde düşük, metin isteyen görevde yüksek.
Üretimde LLM kullanmanın az yazılan tarafı, çıktının her zaman istendiği gibi gelmemesidir. Hat buna üç biçimde hazırlanmıştır.
Hattın her aşamasının süresi ölçülür. Sekiz günlük pencerede bir koşunun medyan süresi 31 dakikadır ve bu sürenin dağılımı, tasarımın neden "ucuz adımlar önce" ilkesine dayandığını gösterir:
Tablo 4: Hattın Aşamalarına Göre Medyan Çalışma Süreleri ve Toplam İçindeki Payları
Aşama medyanlarının toplamı (yaklaşık 28 dakika) koşu medyanından küçüktür, çünkü medyanlar toplanmaz; tablodaki paylar bu toplam üzerinden hesaplanmıştır. Zamanın dörtte üçü LLM ve web aramasına gidiyor; gömme dâhil tüm "klasik" işlemler toplamda yarım dakikayı bulmuyor. Bu yüzden hattın hız ve maliyet tasarımı tek bir soruya indirgenir: LLM'e ulaşan haber sayısı nasıl azaltılır?
Maliyetin kalemlere dağılımı da aynı resmi verir (Günlük hacimler medyan; paylar liste fiyatlarıyla hesaplanmıştır).
Tablo 5: Günlük İşlem Hacmi ve Maliyet Kalemlerinin Dağılımı
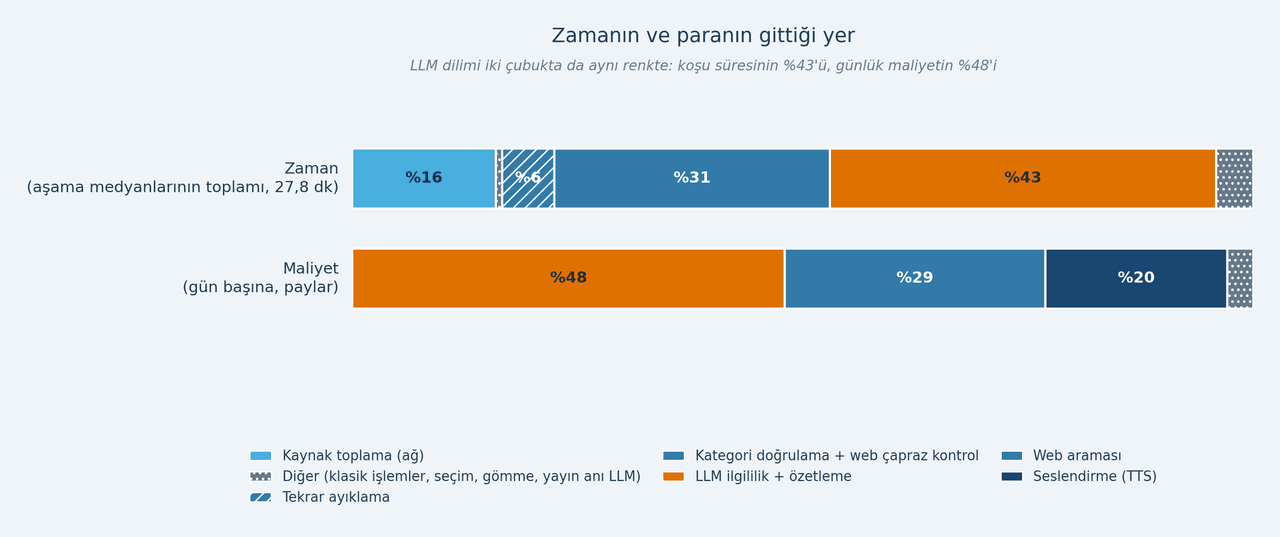
Aşamalara Göre Harcanan Süre ve Maliyet Dağılımı (Yapay Zeka ile Oluşturulmuştur.)
Ham haber başına yaklaşık 1,4 LLM çağrısı ve 0,5 web araması düşer; hattın sonuna ulaşan haber başına bunun iki katından fazla, çünkü yolda elenenlerin payı da kalanlara yüklenir. Seslendirme, hattın kendisinden bağımsız bir kalemdir: her yayın slotunda yalnız yayınlanacak tek aday seslendirilir, bu yüzden maliyeti işlenen haber sayısıyla değil yayın slotu sayısıyla ölçeklenir.
Özetlenmiş haber, okura ulaşana kadar iki aşamadan daha geçer. Bu aşamalar hattın parçası sayılmayabilir ama okurun gördüğü kaliteyi en az önceki adımlar kadar belirler.
Seçim: Her koşu, kategori başına en fazla 24 haberi önem skoru × yaş bozunması ile sıralayarak bir yayın havuzuna koyar; aynı olay kümesinden tek haber alınır ve önem skoru 0,25'in altındakiler alınmaz. Bozunma katsayısı kategoriye göre değişir: teknoloji ve bilim haberleri yavaş eskir (günde 0,96), spor hızlı (0,90). Yayınlanmayan haberler bir sonraki havuza taşınır, yani bir haber bir koşuda sıraya giremediyse kaybolmaz. Aynı haber iki kategoride birden yayınlanmaz; hem genel teknoloji hem siber güvenlik kapsamına giren bir haber dar olan kategoriye yönlendirilir.
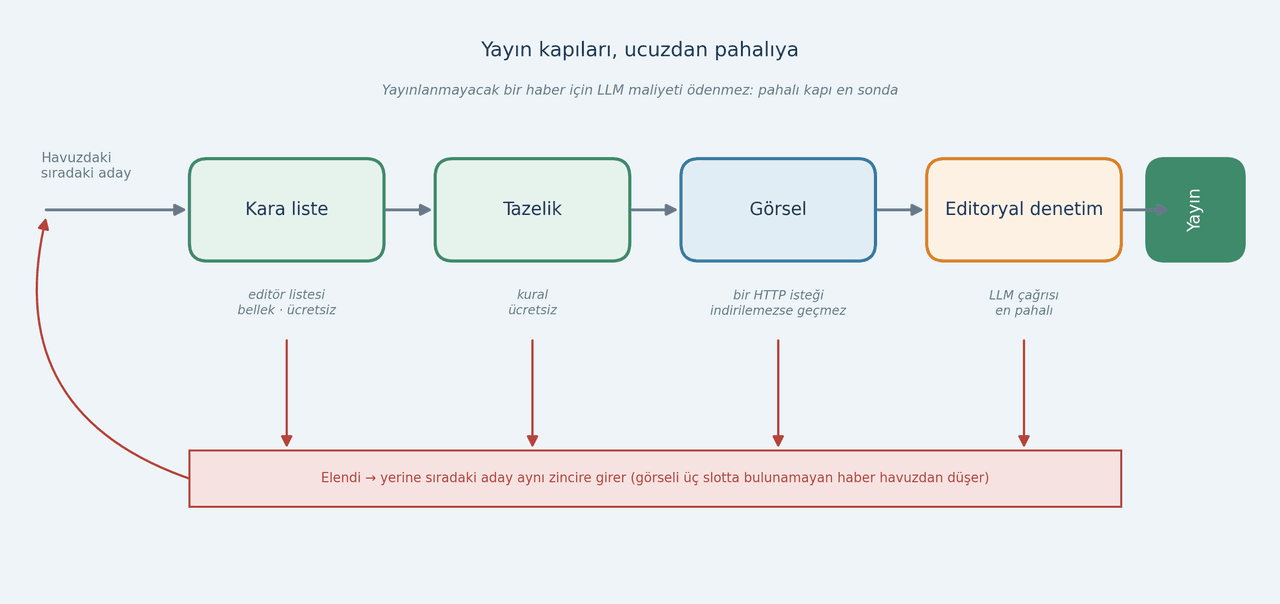
Yayın Anındaki Doğrulama ve Eleme Kapıları (Yapay Zeka ile Oluşturulmuştur.)
Yayın kapıları: Yayın anında her aday, ucuzdan pahalıya dizilmiş dört kapıdan geçer: editörün kara listesi; tazelik (yayın saati gelmeden bayatlamış maç/etkinlik ön izlemeleri); görsel (haberin görseli indirilemiyorsa haber yayınlanmaz, sıradaki aday denenir; üç denemede de görseli bulunamayan haber düşürülür); ve son olarak LLM ile editoryal denetim. Sıralamanın gerekçesi, yazının başından beri işlenen ilkedir: yayınlanmayacak bir haber için LLM maliyeti ödenmez.
İnsan denetimi: Bir yönetim paneli havuzu gösterir; editör haber onaylayabilir, düzenleyebilir, kara listeye alabilir ya da belirli bir saate rezerve edebilir. Panelin her kaydı doğrulamadan geçer; bozuk bir kayıt diske yazılmaz. Otomasyonun amacı editörü ortadan kaldırmak değil, editörün 2.650 haber yerine 24 haberle ilgilenmesini sağlamaktır.
Kanallar: Seçilen haberler bir mesajlaşma uygulamasındaki kategori kanallarına ve bir sosyal platforma otomatik gönderilir. Sosyal platformda her haber için kategori rengini taşıyan bir haber kartı üretilir ve kart, özetin seslendirildiği kısa bir videonun poster karesi olur. Kart tasarımı kendi başına bir yazı konusudur; özet uzunluğu için yukarıda anlatılan "ölçerek seç" yaklaşımı aslında o tasarımdan doğmuştur. Seslendirmenin hatla ilgili kısmı ise kısaca bir sonraki bölümde anlatılmıştır.
Seslendirme yalnız bir ses sentezi modeline metin verip çıkan sesi yayınlamak değildir; modelin iki yanında bir ön işleme ve bir son işleme katmanı vardır ve dinlenen kalitenin büyük kısmı bu iki katmandan gelir. Üretim, yayın saatinden birkaç dakika önce ve yalnız kapılardan geçmiş tek aday için yapılır; yaklaşık 400 karakterlik bir özet 27 saniyelik bir konuşmaya karşılık gelir.
Ön işleme (metin): Okunan metin önce başlık, sonra özettir; başlık kendi paragrafıdır ve özetten 450 ms'lik bir sessizlikle ayrılır. Başlık özetin ilk cümlesini tekrar ediyorsa -ölçüt ortak kelime sayısı değil, aynı sırayla gelen kelime dizileridir; havuzdaki haberlerin %15'i bu ölçüte takılır- başlık yalnız kart ve seslendirme için LLM'e yeniden yazdırılır. Yeni başlığın içindeki her sayı özette ya da eski başlıkta geçmeli, her iddia özette bulunmalıdır; geçemeyen aday reddedilir ve eski başlık kalır. Ardından biçimlendirme işaretleri ve emojiler temizlenir; Türkçe haber metninde noktayla yazılan saat ("20.45") iki noktayla yazılır, aksi hâlde ondalık sayı gibi okunur. Son adım bir aksan sorununu çözer. Ses sentezi modeli hangi dilde okuyacağına metnin başına bakarak karar verir, bu yüzden yabancı adlarla açılan bir haber baştan sona yabancı aksanla okunabiliyordu. Bu yaşanmasın diye seslendirilecek her metnin başına kısa bir Türkçe cümle eklenir ve model daha ilk kelimeden Türkçe okumaya başlar. Dinleyici bu cümleyi hiç duymaz, çünkü konuşma başladıktan sonraki ilk sessizlikte (en az 150 ms) ses oradan kesilir. Sabit bir süreyle kesmek işe yaramaz, çünkü aynı ses aynı cümleyi her seferinde farklı hızda okur. Sessizlik bulunamazsa bir kez daha denenir, o da olmazsa metin bu cümle olmadan seslendirilir. Yirmi gerçek denemede kesim 20'sinde doğru yerdeydi.
Son işleme (ses): Modelden çıkan ses yayına doğrudan gitmez; birkaç basit işlemden geçer. Her parçanın başındaki sessizlik kesilir, sonunda ise kısa bir pay (150 ms) bırakılır çünkü son hecenin kesilmesi duyulur. Başlık ve özet parçaları aralarına düz sessizlik konarak art arda eklenir (cümleler arasında 150 ms, başlıkla özet arasında 450 ms). Parçalar birbirinin üstüne bindirilerek (crossfade) birleştirilmez çünkü ayrı ayrı okunmuş iki parçayı üst üste bindirmek geçişteki ünsüzleri bulanıklaştırır. Ardından bütün kaydın ses seviyesi, yayın standartlarının öngördüğü tek bir hedef seviyeye çekilir ve ani tepe noktaları, bozulmaya yol açmayacak bir tavanın altında tutulur. Bu iki işlemin sırası önemlidir ve akla ilk gelenin tersidir. Önce tepe noktaları sınırlanırsa kayıt tavana yapışır ve seviye ayarının gidecek yeri kalmaz. Bu, gerçek bir okumada ölçüldü, ters sırada tepe noktaları tavandaydı ama kayıt hedef seviyenin belirgin biçimde altında kalıyordu. Gürültü giderme, ton ayarı (EQ) ve sıkıştırma bilerek yoktur; ses yanlış geliyorsa düzeltilecek şey sinyal değil ses seçimidir. Üretilen ses saklanır; aynı metin ve aynı sesle yapılan bir yeniden deneme ya da yeniden üretim sesi ikinci kez ürettirmez. Videoda kart, sesin süresi boyunca tek kare olarak gösterilir; videonun süresi sese sabitlenir, ses hiçbir zaman videoya uydurulup kesilmez.
İnternet haberciliği gelişmiş olsa da bilgi kirliliği nedeniyle doğru ve istenen bilgiye ulaşmak zorlaşmıştır. Kaynak toplama, metin temizleme ve erken eleme, gömme tabanlı ayıklama ve kategorilendirme, önem skorlaması ile doğrulama ve birleştirme, LLM ile özetleme ve son olarak seçim adımlarından oluşan bir hatla okurun doğru bilgiye sade ve öz bir anlatımla, maliyet-kalite dengesi gözetilerek ulaşması sağlanabilir.
Bu hattın başarısı birkaç tasarım kararına ve sınırlılığa bağlıdır: gömme modelinin dil desteği ve eşik değerlerinin seçimi, aynı ifadeyle farklı olayları anlatan sınır durumlarının ele alınması, kaynak güvenilirliğine yönelik önlemlerin sınırlı olması ve LLM kullanımının maliyeti. Ölçümlerden çıkan en genel ders ise şudur: eşikler, ağırlıklar ve komutlar tahminle değil ölçümle seçilmelidir. Bu yazıdaki her sayı -tekrar eşikleri, özet uzunluğu, erken elemenin payı- bir kez gerçek veriyle ölçüldüğü için var; ölçülmeden seçilen her değer, görünmeyen bir yerde haber kaybettirir.
Hattın doğru kurulmasıyla 450'nin üzerinde kaynaktan gelen günlük yaklaşık 2.650 ham haberin, seslendirme dâhil günde 5 doların altında bir maliyetle takip edilmesi; bunların 1.100'ünün kategorilenmiş ve özetlenmiş hâle getirilmesi ve her kategoriden en iyilerinin okura ulaştırılması mümkündür.
Barbaresi, A. "Trafilatura: A Web Scraping Library and Command-Line Tool for Text Discovery and Extraction." Proceedings of ACL-IJCNLP: System Demonstrations. (2021): 122–131. Erişim Tarihi: 31 Ekim 2026. https://doi.org/10.18653/v1/2021.acl-demo.15
Covington, M. A. ve Joe D. McFall. "Cutting the Gordian Knot: The Moving-Average Type–Token Ratio (MATTR)." Journal of Quantitative Linguistics 17 (2). (2010): 94–100. Erişim Tarihi: 31 Ekim 2026. https://www.tandfonline.com/doi/abs/10.1080/09296171003643098
Osei-Hwere, Enyonam ve Patrick Osei-Hwere. "History of Newspapers." Media Communication, Convergence and Literacy. 2. bs. WTAMU Cornette Library. Erişim Tarihi: 9 Ekim 2026. https://odp.library.tamu.edu/mediacommunication2e/chapter/history-of-newspapers/
RSS Advisory Board. "RSS 2.0 Specification." Erişim Tarihi: 31 Ekim 2026. https://www.rssboard.org/rss-specification
[1]
Enyonam Osei-Hwere ve Patrick Osei-Hwere, "History of Newspapers," Media Communication, Convergence and Literacy, 2. bs, WTAMU Cornette Library, Erişim Tarihi: 9 Ekim 2026. https://odp.library.tamu.edu/mediacommunication2e/chapter/history-of-newspapers/
[2]
RSS Advisory Board, "RSS 2.0 Specification," Erişim Tarihi: 31 Ekim 2026. https://www.rssboard.org/rss-specification
[3]
A. Barbaresi, "Trafilatura: A Web Scraping Library and Command-Line Tool for Text Discovery and Extraction," Proceedings of ACL-IJCNLP: System Demonstrations, (2021), 125-126, Erişim Tarihi: 31 Ekim 2026. https://doi.org/10.18653/v1/2021.acl-demo.15
[4]
M. A. Covington ve Joe D. McFall, "Cutting the Gordian Knot: The Moving-Average Type–Token Ratio (MATTR)," Journal of Quantitative Linguistics 17 (2), (2010), 94-97, Erişim Tarihi: 31 Ekim 2026. https://www.tandfonline.com/doi/abs/10.1080/09296171003643098

Çok Kaynaklı Haber Takibinin Sorunu
Haber Kaynaklarının Toplanması: RSS ve Siteye Özel Çözümler
Haber Metninin Temizlenmesi ve Erken Eleme
Gömme Modeliyle Tekrar Ayıklama ve Kategorilendirme
Üç Eşik, Tek Eksen
Kategori Ataması: Prototipler ve Şüphe Hâlinde LLM
Benzer Metin, Farklı Olay: Sınır Durumları
Kaynak Seçimi, Haber Önem Skoru, Doğrulama ve Birleştirme
Önem Skoru
Aynı Olayı Anlatan Haberlerin Birleştirilmesi
Üç Katmanlı Doğrulama: Bağlantı, Web ve Muafiyetler
LLM ile Çeviri, Özetleme ve Eksik Bilgi Tamamlama
Komut Kalitesi ve Sıcaklık
Komuta Güvenmek Yerine Ölçmek ve Kodla Güvence Altına Almak
Zaman ve Maliyet: Pahalı Olan Ne?
Özetten Sonra: Seçim ve Yayın
Seslendirme: Metin Ön İşleme ve Ses Son İşleme
Sonuç
This article was created with the support of artificial intelligence.