Ana bulgular: Bu yazıda Qwen3 ailesiyle Türkçe kıyaslama testleri (benchmark) üzerinde iki deney yapılmıştır: karma hassasiyetli bir kuantizasyon reçetesi (E1) ve KV önbelleği ile lm_head kuantizasyonu (E2). Deneylerin gösterdikleri kısaca şöyledir:
Sınır: Bulgular Qwen3 ailesinin yoğun modelleri, Türkçe, llama.cpp ve çoğunlukla tek tohumlu koşumlarla sınırlıdır.
Bu yazı, üç bölümlük "Kuantizasyon" serisinin üçüncü ve son yazısıdır. Seri boyunca Qwen3 ailesi Türkçe veri ve Türkçe kıyaslama testleriyle sınanmaktadır: birinci yazıda büyük modellerin bellek sorunu, kuantizasyonun ağırlıklar üzerindeki etkisi ile model boyutu ve bit sayısının etkisi; ikinci yazıda yöntem seçimi, kalibrasyon dili, bellek bütçesi ve hız ele alınmıştır. Bu yazı, birinci yazıda anlatılan bellek hesabının, ölçek, aykırı değer (outlier) ve grup kavramlarının ve ortak deney kurulumunun üzerine kuruludur; önce birinci yazının, kalibrasyon kullanan yöntemler için ikinci yazının okunması önerilir.
Serinin birinci yazısının başındaki iki cevaptan birini Qwen3-32B'nin Q4_K_M kuantı üretmişti. Bu kuantın adında 4 geçer, ancak bütün tensörleri 4 bitte değildir: bir kısmı 6 bitte tutulur.【1】 Bitlerin bir kısmı, kuantizasyondan en çok zarar gören tensörlere ayrılmıştır.
Ağırlıklar da belleğin tek kalemi değildir. Model, daha önce işlediği her token için her katmanda bir anahtar (key) ve bir değer (value) vektörü saklar; bu anahtar-değer (Key-Value, KV) önbelleği (KV cache), Qwen3-32B'de 32 bin token'lık 16 eşzamanlı sohbet için Brain Floating Point 16 (BF16) biçiminde 128 GiB tutar. Bu boyut, modelin ağırlıklarının yaklaşık iki katıdır. Uzun bağlamlı servislerde bellek kullanımında KV önbelleği, ağırlıklardan daha büyük pay alabilir.
Bu yazıda önce bit bütçesinin tensörler arasında nasıl dağıtılabileceği, ardından ağırlıkların dışında aktivasyonların, KV önbelleğinin, gömme (embedding) tablosunun ve lm_head'in nasıl sıkıştırılabileceği ele alınacaktır. Ardından Qwen3 ailesiyle iki deney gerçekleştirilecektir: Türkçe metinle bir tensör hassasiyeti haritası çıkarılıp aynı boyutta karma bir reçete kurulacak ve KV önbelleği ile lm_head'i sıkıştırmanın bellek, hız ve kalite bedeli ölçülecektir.
Bir modelin bütün tensörleri kuantizasyondan aynı ölçüde etkilenmez. Gömme (embedding) tablosu, dil modelleme başlığı (language modeling head, lm_head), ilk ve son birkaç katman ve dikkat (attention) mekanizmasındaki bazı projeksiyonlar genellikle daha hassastır. Farklı tensörlere farklı bit sayısı tahsis etmeye karma hassasiyet (mixed-precision) denir. llama.cpp'nin K-quant ailesi bunun yaygın bir örneğidir: adında "4" geçen Q4_K_M kuantında bazı tensörler 6 bitlik Q6_K biçiminde tutulur.【2】 Unsloth'un "Dynamic" kuantları bu fikri katman bazında, hassas katmanları daha yüksek bitte bırakarak uygular.【3】
Uzman Karışımı (Mixture of Experts, MoE) modellerde karma hassasiyet farklı bir gerekçeye dayanır. Uzman (expert) ağırlıkları toplam parametrelerin büyük kısmını oluşturur ancak her token yalnızca birkaç uzman kullanır; dikkat ve paylaşılan katmanlar ise her token'da çalışır. Bu nedenle Kimi K3 ve DeepSeek V4 Pro gibi büyük MoE modellerin kuantize sürümlerinde uzmanlar düşük bitte, paylaşılan kısımlar yüksek bitte tutulabilir.
Birinci yazıdaki sekiz ağırlıklık örnek satır yeniden ele alınır: [0.21, −0.47, 0.08, 0.33, −0.15, 0.62, −0.29, 3.10]. Satır tek bir absmax ölçeğiyle INT4'e indirildiğinde 3.10'luk outlier ölçeği büyütmüş ve küçük ağırlıkların bir kısmı sıfıra yuvarlanmıştı. Satırı dörderli iki gruba bölmek hatayı azaltmış olsa da outlier'ın bulunduğu ikinci gruptaki küçük ağırlıkların sıfıra yuvarlanmasını önleyememişti. Hata ortalama karesel hata (OKH) ile ölçülmüştür; bitler bütün satıra eşit dağıtılmak yerine yalnızca outlier'ın bulunduğu grubun bit sayısı yükseltilmiştir.
Tablo 1: Örnek Satırda Reçetelere Göre Ortalama bit ve Ortalama Karesel Hata (OKH)
Yalnızca outlier'ı barındıran grubu INT8'e çıkaran reçete, ortalama 6 bitle tamamı INT8 olan satırdan biraz daha düşük hata vermiştir. Karma hassasiyetin temel mantığı şudur: bit bütçesi, hatanın yoğunlaştığı yere ayrılır. Outlier'ı tek başına BF16 bırakmak da hatayı tamamı INT4'e göre yaklaşık 37 kat düşürür (0.0177 → 0.00048); ancak outlier'ın bulunduğu grubu INT8'e çıkarmaktan yaklaşık 10 kat yüksek kalır. Bu yaklaşım, LLM.int8()'in aykırı kanalları ayrı tutma fikrinin basitleştirilmiş bir benzeridir.【4】
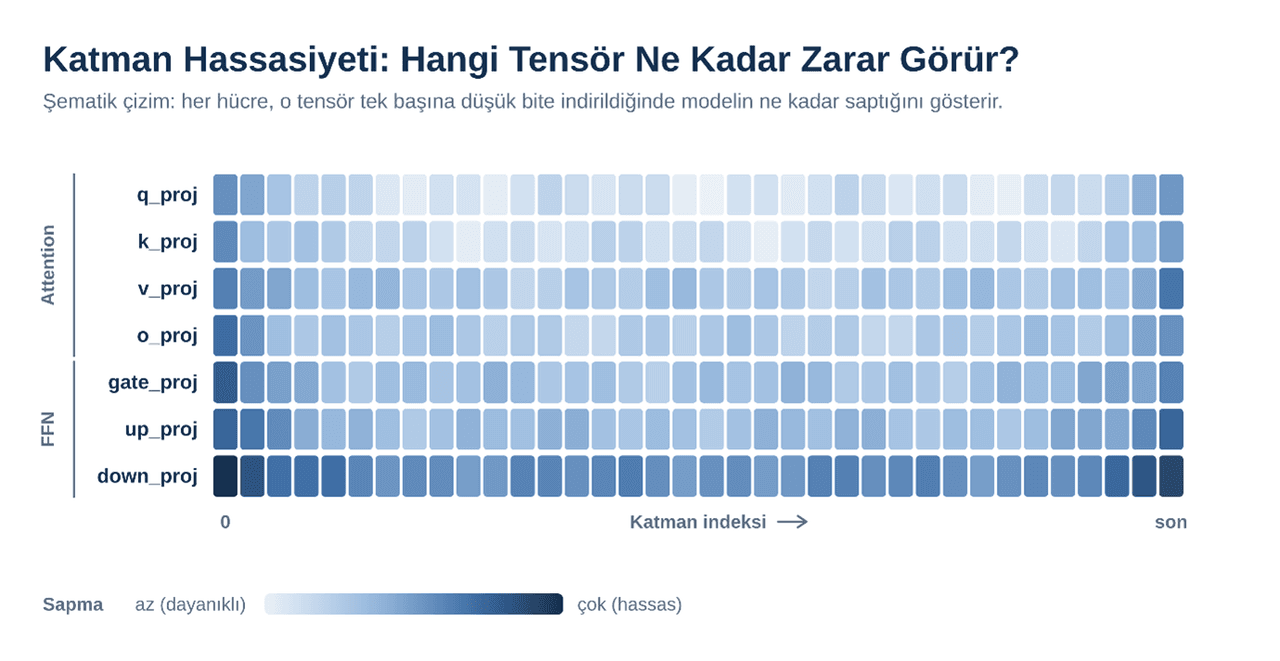
Katman ve Tensör Türüne Göre Şematik Kuantizasyon Sapması (Çizim: Elif İnce)
Doğrudan yöntemlerden biri hassasiyet analizidir: model yüksek hassasiyette bırakılır, tensörlerden yalnızca biri düşük bite indirilir ve çıktının orijinal modelden ne kadar saptığı ölçülür. İşlem her tensör için tekrarlanır ve sapmalar bir ısı haritası olarak gösterilir. Ardından bit bütçesi, en hassas tensörlerden başlanacak şekilde dağıtılır. E1'de bu analiz Qwen3-4B için Türkçe metinle yapılıp haritaya dayalı bir reçete kurulacaktır.
Kuantizasyon literatüründe "dinamik" kelimesi iki farklı şey için kullanılır. PyTorch'un tanımında dinamik kuantizasyon, ağırlıkları önceden INT8'e indirip aktivasyonların ölçeğini her girişte çalışma anında hesaplamaktır; statik kuantizasyonda ise aktivasyon ölçeği kalibrasyonla önceden sabitlenir.【5】 vLLM'deki "FP8 dynamic" kuantları da bu anlamı taşır.
Unsloth'un "Dynamic" adlı kuantları ise bir karma hassasiyet reçetesidir: hangi katmanın kaç bitte tutulacağı model bazında belirlenir.【6】 İki kavram birbirinden bağımsızdır; bir model hem karma hassasiyetli hem de dinamik aktivasyon ölçekli olabilir.
Bu yazıda "dinamik" kelimesi yalnızca ilk anlamda kullanılır; ikinci anlam için "karma hassasiyet" denir.
Akılda kalsın: Hassasiyet tensörden tensöre değiştiği için bit bütçesini hassas tensörlere yoğunlaştırmak, aynı boyutta daha düşük hata verir.
Şimdiye kadarki örneklerin hepsi yalnızca ağırlık (weight-only) kuantizasyonuydu. Bu düzende ağırlıklar 4 ya da 8 bitte saklanır, hesaplama sırasında 16 bite açılır ve aktivasyonlarla 16 bitte çarpılır; bu düzen kısaca W4A16 olarak gösterilir. Kazanç bellekte ve tek kullanıcılı üretim (decode: token'ların tek tek üretildiği aşama) hızında görülür, çünkü bu aşamada her yeni token için bütün ağırlıklar bellekten okunur ve darboğaz genellikle bu okumadır.
Girdinin tamamının tek seferde işlendiği ön doldurma (prefill) aşamasında ve çok kullanıcılı servislerde darboğaz hesaplamaya yer değiştirir. Burada hız kazanmak için matris çarpımının kendisi düşük bitte yapılır; ağırlıklar ve aktivasyonlar birlikte kuantize edilir (W8A8, 8 bitlik kayan nokta biçimi FP8). Zorluk, birinci yazıda ağırlıklarda görülen outlier'ların aktivasyonlarda daha belirgin olabilmesidir.【7】 SmoothQuant bu zorluğu aktivasyonlardan ağırlıklara aktarır.【8】 Aktivasyon ölçeği kalibrasyonla önceden sabitlenebilir (statik) ya da her token için çalışma anında hesaplanabilir (dinamik).
Aynı satır bir aktivasyon vektörüyle çarpılır: x = [1.0, 0.5, −1.2, 0.8, 2.0, −0.4, 1.5, 0.1]. Orijinal ağırlıklarla çıktı −0.530'dur.
Tablo 2: Aynı Satırın Aktivasyon Vektörüyle Çarpımında Çıktı Sapması
Satır düzeyindeki hata ile çıktıdaki hata birebir örtüşmez: Tamamı INT8 reçetesinin satır hatası (0.000054), outlier BF16 reçetesininkinden (0.00048) küçük olduğu hâlde bu girdide çıktısı daha çok sapar (+0.037 ve −0.028). Kalibrasyon kullanan yöntemlerin ağırlık hatası yerine gerçek girdilerle oluşan çıktı hatasına bakmasının nedeni budur.
KV ön belleğinin boyutu 2 × katman × kv_head × head_boyutu × bağlam × eşzamanlı kullanıcı × bayt ile hesaplanır; baştaki 2, anahtar (key) ve değer (value) için ayrı birer tensör saklanmasından gelir. Qwen3-32B'de (64 katman, 8 KV head, head başına 128 boyut) 16 eş zamanlı ve 32 bin token'lık sohbetin KV ön belleği BF16'da 128 GiB tutar.【9】 Aynı ön bellek FP8'de saklandığında 64 GiB'a, 4 bitte yaklaşık 32 GiB'a iner (ölçek bilgisi hariç; llama.cpp'nin q8_0 ve q4_0 türlerinde ölçekler dahil ölçülen oranlar yaklaşık %53 ve %28'dir, bkz. E2). Anahtar ve değer tensörlerinin dağılımları farklı olduğundan, KIVI gibi yöntemler ikisini ayrı biçimde kuantize eder; KIVI anahtarları kanal bazında, değerleri token bazında ölçekler.【10】 KV ön belleği kuantizasyonunun riski uzun bağlamda belirginleşebilir: uzun bir bağlamdaki tek bir bilgiye ilişkin ayrıntılar kaybedilebilir.
Gömme (embedding) tablosu ve lm_head, sözlükteki her token için bir satır taşır. Qwen3'ün yaklaşık 152 bin token'lık sözlüğüyle Qwen3-32B'nin lm_head'i 778 milyon parametre eder. Bu, modelin parametrelerinin %2.4'üne karşılık gelir. Qwen3-0.6B'de ise embedding tablosu tek başına parametrelerin yaklaşık dörtte birini oluşturur.【11】 lm_head her adımda bütün token'ların logit değerini doğrudan ürettiği için hatası her token'ın olasılığına yansır; bu nedenle bazı reçeteler onu yüksek bitte bırakır. Küçük modellerde bu tercihin bellek bedeli de büyür. Qwen3'ün 0.6B, 1.7B ve 4B modellerinde embedding tablosu ile lm_head aynı ağırlıkları paylaşır; bu modellerde ikisi ayrı ayrı sıkıştırılamaz, birlikte değişir.
Tablo 3: Kuantize Edilen Kaleme Göre Bellek, Hız ve Risk Eğilimleri
Bu yazıda yalnız KV önbelleği ve lm_head ölçülmüştür.
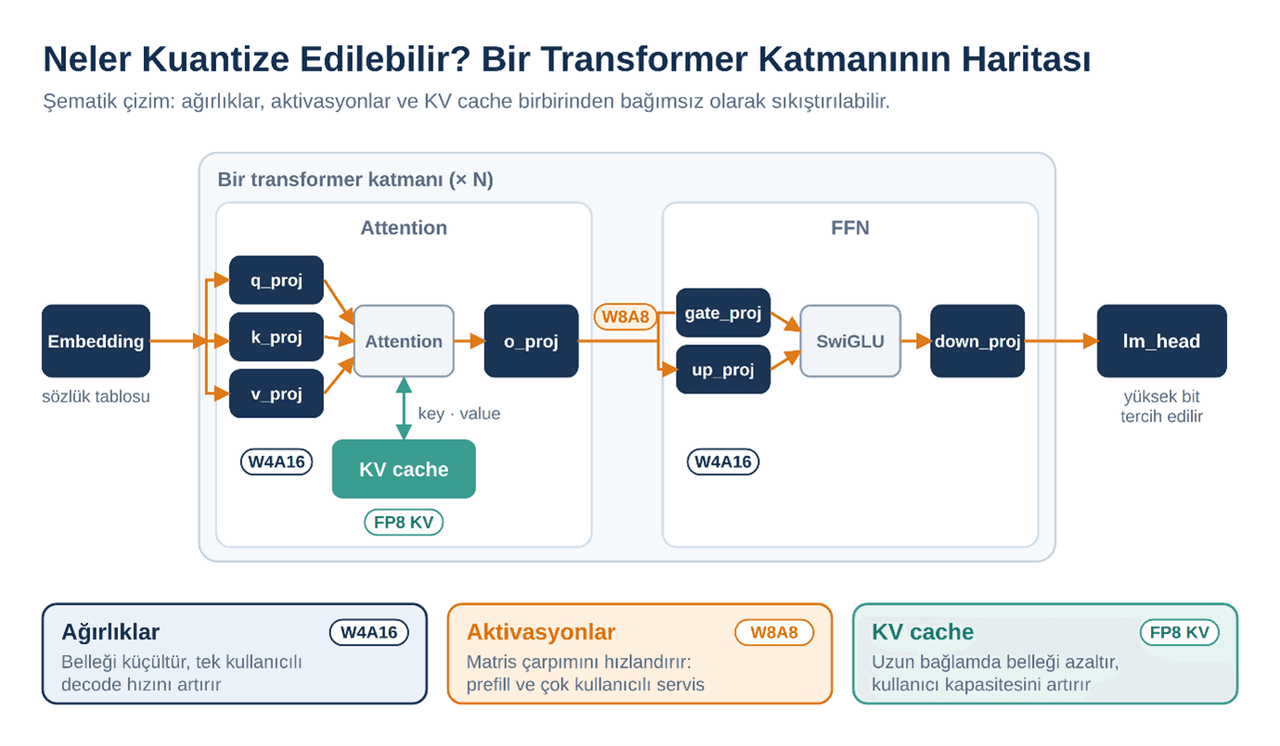
Bir Transformer Katmanında Kuantize Edilebilen Kalemler (Çizim: Elif İnce)
Tablo 3, hangi kalemin hangi darboğazı hafiflettiğini özetler: tek kullanıcılı yerel kurulumlarda ağırlık kuantizasyonu, yoğun servislerde aktivasyon ve KV önbelleği kuantizasyonu öne çıkar.
Bir katmanın çıktısı Y = X W ile verilir. Aktivasyon matrisi X'in bazı kanalları çok büyük değerler taşır; ağırlık matrisi W ise daha homojen bir dağılıma sahiptir. SmoothQuant, her kanal için bir s ölçeği seçip X'i bu ölçeğe böler, W'yi aynı ölçekle çarpar:【12】
Çarpım değişmez; aktivasyondaki aykırı kanallar küçülür, karşılığında ağırlıklar biraz büyür. α, zorluğun iki taraf arasında nasıl paylaşılacağını belirler. Ölçekler önceden hesaplanıp bir önceki katmanın ağırlıklarına gömülebildiği için çalışma anında ek maliyet getirmez.
Akılda kalsın: Ağırlık kuantizasyonu belleği ve tek kullanıcılı hızı, aktivasyon ve KV cache kuantizasyonu ise yoğun servislerdeki hesaplamayı ve uzun bağlamın belleğini hedefler.
Önceki bölümlerde anlatılanlardan karma hassasiyet ile KV ön belleği ve lm_head kuantizasyonu bu bölümde Qwen3 ailesinin yoğun modelleri üzerinde, Türkçe metin ve Türkçe kıyaslama testleriyle sınanmıştır; aktivasyon kuantizasyonu deneysel olarak sınanmamıştır. Cevabı aranan sorular şunlardır:
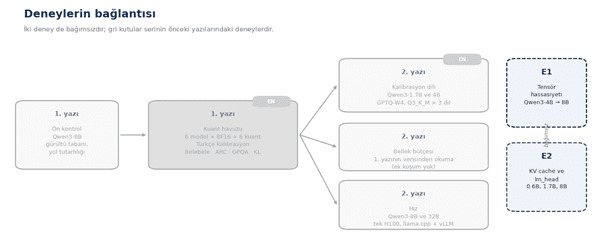
Deneylerin Birbirine Bağlantısı: E1 ve E2 (Çizim: Elif İnce)
İki deney birbirinden bağımsızdır; ikisi de karşılaştırma tabanı olarak birinci yazıda üretilen tekdüze GGUF kuantlarını, ortak kurulumu ve ön kontrolü kullanır.
Şemada gri kutular serinin önceki yazılarında ele alınan deneylerdir; kesikli kutular bu yazıdaki bağımsız deneyleri gösterir. Serideki bütün koşumlar tek bir H100 grafik işlem biriminde (graphics processing unit, GPU; 80 GB) yapılmıştır; toplam süre 10.7 GPU-saattir.
Deneylerde birinci yazıdaki ortak kurulum kullanılmıştır; bu yazıyla ilgili kısımlar aşağıda özetlenmiştir.
Tablo 4: Ortak Kurulum: Modeller, Kuantlar, Kalibrasyon ve Ölçütler (Bu yazıyı ilgilendiren kısım)
Ölçüm: Ana ölçüt, kuantize modelin doğruluğunun aynı modelin BF16 kopyasına göre farkıdır; sorular eşleştirilerek yeniden örnekleme (bootstrap) ile %95 güven aralığı (GA) biçiminde verilir. Cevap değiştirme (flip) oranı, BF16 modelin doğru cevaplarının yanlışa, yanlışlarının doğruya dönme sıklığıdır.【21】 KL ıraksaması (Kullback-Leibler divergence, KL) her token'da kuantize modelin olasılık dağılımının BF16 modelinkinden ne kadar uzaklaştığını ölçer; doğru cevap gerektirmediği için doğruluktan daha duyarlı olabilir ve tek tensör analizinde ana ölçüt olarak kullanılmıştır. Birinci yazıdaki ön kontrolde ölçüm zincirinin gürültü tabanı ±0.47 puan olarak ölçülmüştür; bu banttan küçük farklar gürültü sayılmıştır.
Türkçe kalibrasyon kümesi, BellaTurca'nın özenle temizlenmiş genel web metinlerinden oluşan OzenliDerlem alt kümesinden rastgele örneklenmiştir.【22】 Kalibrasyon örnek sayısı, GPTQ'nun özgün çalışmasındaki 128 örneği izlemiştir.【23】 KL ölçümü, kalibrasyondan farklı bir alandan, Havadis haber metinlerinden alınmış yaklaşık 100 bin token'lık bir kümede yapılmıştır.【24】
Belebele-tr, FLORES-200 paragrafları üzerine kurulmuş çoktan seçmeli bir okuma anlama testidir.【25】 ARC-tr, ARC-Challenge test bölümünün insan kontrolünden geçmiş Türkçe çevirisidir.
Kıyaslama testleri log-olabilirlik (log-likelihood) tabanlı çoktan seçmeli puanlamayla çalıştırılmıştır; model metin üretmediği için Qwen3'ün düşünme modunun sonuçları etkilemediği değerlendirilmiştir. GGUF kuantlarının ağırlıkları BF16'ya geri açılıp aynı motorda değerlendirilmiştir; böylece bütün kuantlar aynı ölçüm zincirinden geçmiştir. Bu yolun llama.cpp'nin kendisiyle aynı sonucu verdiği, birinci yazıdaki ön kontrolde doğrulanmıştır. GGUF kuantlarının KL ıraksaması doğrudan llama.cpp'nin şaşkınlık (perplexity) aracıyla hesaplanmıştır.
Soru: Qwen3-4B'nin Türkçe metinle çıkarılan tensör hassasiyeti haritasından kurulan karma reçete, aynı boyuttaki tekdüze kuanttan daha iyi midir?
Kurulum: Birinci aşamada Qwen3-4B BF16 hassasiyetinde bırakılmış; 36 katmanın her birindeki yedi tensör türü (q, k, v, o, gate, up, down) sırayla tek başına 2 bitlik RTN'ye (kalibrasyonsuz, en yakın değere yuvarlama; grup 128) indirilmiş ve Havadis kümesinin yaklaşık 20 bin token'lık (20 480) bir parçasında KL ıraksaması ölçülmüştür; toplam 252 ölçüm yapılmıştır. Bu sayıda ölçüm için kıyaslama testi çalıştırmak maliyetli olduğundan harita KL ile çıkarılmış, reçeteler ise doğrulukla karşılaştırılmıştır.
İkinci aşamada harita kullanılarak toplam boyutu Q3_K_M'e yaklaşık eşit (en fazla %1 fark) olacak biçimde bit dağıtılmıştır: en hassas tensörler Q6_K, orta hassaslar Q4_K, kalanı Q3_K ya da Q2_K olarak atanmış ve reçete llama.cpp'nin tensör bazında tür belirleme seçeneğiyle GGUF olarak üretilmiştir. Karşılaştırma için tekdüze Q3_K_M, boyutu en yakın Unsloth Dynamic kuantı【26】 ve aynı bitlerin her tensör türü içinde katmanlara rastgele dağıtıldığı iki kontrol reçetesi (iki rastgelelik tohumu, seed) kullanılmıştır; bu karıştırma toplam boyutu birebir korumuştur.
Üçüncü aşamada aynı reçete kuralı Qwen3-8B'ye aktarılmıştır: 8B'nin kendi haritası çıkarılmamış, 4B haritasındaki katman-tür örüntüsü (ilk ve son katmanlar, gate/up/down) oransal olarak uygulanmış ve boyut tekdüze Q3_K_M ile eşit tutulmuştur.
Tablo 5: E1 Karşılaştırma Koşulları (Tekdüze, Rastgele, Unsloth Dynamic ve Harita Reçetesi)
Beklenti ve Yorum: İlk ve son katmanlarla down_proj gibi tensörlerin hassas çıkması, harita reçetesinin tekdüze kuanttan ve rastgele kontrolden belirgin biçimde iyi, hazır karma kuanta yakın olması beklenir; hazır karma kuantın Türkçedeki davranışı kalibrasyon verisinin içeriğiyle ilgili olabileceğinden, harita reçetesinin Türkçede ona yetişebileceği de beklenir. Harita reçetesi hem tekdüze kuantı hem rastgele kontrolü geçerse kazanç hassasiyet bilgisiyle tutarlıdır; rastgele reçete de tekdüze kuantı geçerse kazancın bir kısmı bitlerin düzensiz dağılmasına bağlanabilir; 4B'den taşınan reçete 8B'de de kazandırırsa hassasiyet haritası aile içinde taşınabilir görünür, kazandırmazsa her model için ayrı analiz gerekebilir.
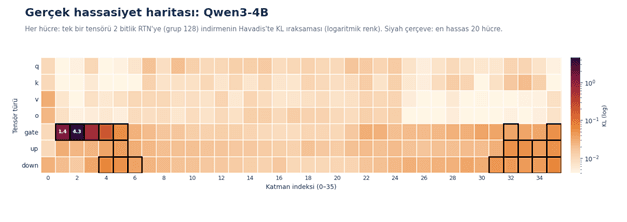
Qwen3-4B Hassasiyet Haritası: KL, Logaritmik Ölçek (Çizim: Elif İnce)
Bulgular (Harita): 252 tensörün tek tek 2 bite indirilmesinde KL medyanı 0.013 olmuştur; ancak dağılım uzun kuyrukludur: en hassas hücre 2 numaralı katmanın (0 tabanlı indeks; Şekil 4) gate_proj'u (KL 4.32), ardından 1 numaralı (1.36), 3 numaralı (0.625) ve 4 numaralı (0.196) katmanınki olmuş; bu dört hücrenin dışında hiçbiri 0.065'i geçmemiştir. En hassas 20 hücrenin 13'ü ilk dört ya da son dört katmanda bulunmuştur; 12'si gate/up, 8'i down projeksiyonudur. Tür ortalamaları: gate 0.200 (medyan 0.022), down 0.026, up 0.024, attention tensörleri 0.008–0.010.
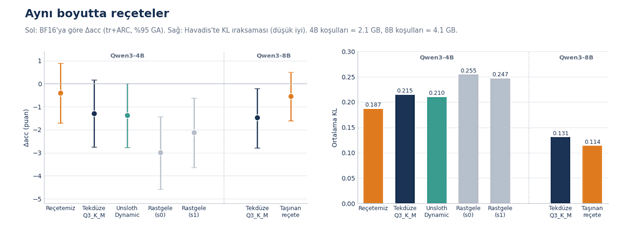
Benzer Boyutta Reçeteler: Δacc ve KL (Çizim: Elif İnce)
Reçeteler: Haritadan 44 tensör Q6_K, 88 tensör Q4_K, 101 tensör Q3_K ve 19 tensör Q2_K olarak atandı; reçete yaklaşık 2.1 GB (ölçülen ortalama 4.15 bit), tekdüze Q3_K_M 4.12 bit, Unsloth Dynamic (Q3_K_XL) 4.23 bit olup harita reçetesinden %1.9, tekdüze Q3_K_M'den %2.7 daha büyüktür. Doğrulukta harita reçetesi en küçük kaybı vermiştir: BF16'ya göre Δ harita reçetesinde −0.40 puan (GA [−1.7, +0.9]), tekdüze Q3_K_M'de −1.29, Unsloth'ta −1.37, rastgele reçetelerde −2.99 ve −2.11 olarak bulunmuştur. Harita reçetesi − tekdüze farkı +0.89 puan (GA [+0.1, +1.7]), harita reçetesi − Unsloth +0.97 [−0.3, +2.3], harita reçetesi − rastgele +2.6 [+1.0, +4.2] (s0) ve +1.7 [+0.2, +3.2] (s1). Fark, tekdüzeye göre GA'nın alt sınırında (+0.1), rastgele kontrollere göre GA'nın sıfırı dışladığı düzeydedir; Unsloth'a göre ayırt edilememiştir (nokta tahminleri benzerdir). Belebele-tr'de rastgele reçeteler −4.4 ve −4.2 puan kaybetmiştir; harita reçetesinin kaybı −0.7 olmuştur (GA [−2.4, +1.0]). Cevap değiştirme (flip) oranı harita reçetesinde en düşük olmuştur (%9.0). KL'de sıralama şöyledir: harita reçetesi 0.187, Unsloth 0.210, tekdüze 0.215, rastgele 0.255 ve 0.247; harita reçetesi, tekdüzeden %13, rastgele kontrollerin ortalamasından yaklaşık %25 daha düşük KL vermiştir.
Aktarım: Aynı reçete kuralı Qwen3-8B'ye uygulandığında (4.14 GB, 4.05 bit) BF16'ya göre Δ −0.55 puan (GA [−1.6, +0.5]) bulunmuştur; tekdüze Q3_K_M'de bu değer −1.48'dir. Fark +0.93 puan (GA [+0.0, +1.8]; alt sınır sıfırda). Cevap değiştirme oranı %9.4'ten %7.6'ya, haritalanan parçanın dışındaki Havadis metninde KL 0.131'den 0.114'e (%13) düşmüştür.
Tablo 6: Benzer Boyutta Reçeteler (Qwen3-4B ve Qwen3-8B)
Tekdüze Q3_K_M doğrulukları birinci yazıdaki ölçümlerden alınmıştır; KL, haritalanan ilk 20 480 token hariç ölçülmüştür. Qwen3-8B reçetesi, 4B haritasından türetilen kuralın oransal uygulamasıdır (8B'nin kendi haritası çıkarılmamıştır). Rastgele reçeteler iki ayrı rastgelelik tohumuyla üretilmiş satırlardır; bütün koşullar tek koşumla elde edilmiştir.
Sonuç E1: En hassas tensörler ilk katmanların gate_proj'u (katman 1–4, 0 tabanlı) ve ilk ile son katmanlarda yoğunlaşan down/up projeksiyonlarıdır. Haritadan kurulan reçete, aynı boyutlu tekdüze kuantan hem KL'de (%13) hem kıyaslama testi doğruluğunda (+0.9 puan) daha iyi, rastgele dağıtımdan yaklaşık +2 puan iyi; Unsloth Dynamic'ten doğrulukta ayırt edilememiştir (tek koşum). Kural 8B'ye aktarıldığında benzer yönde bir fark görülmüştür (+0.9 puan, GA alt sınırı +0.0; KL %13); iki model tek örnektir.
Soru: KV cache kuantizasyonu uzun Türkçe bağlamda ne kadar bellek kazandırır ve geri çağırmayı bozar mı; lm_head'i sıkıştırmanın etkisi model boyutuyla değişir mi?
Kurulum: Birinci kısımda Qwen3-8B'nin Q8_0 kopyası (bellek, hız ve geri çağırma) ve küçük model olarak Qwen3-1.7B'nin Q8_0 kopyası (yalnızca geri çağırma) sabit tutulmuş; llama.cpp'de KV önbelleği F16, q8_0 ve q4_0 olarak saklanmıştır. Bağlam uzunlukları 4K, 16K ve 32K olarak belirlenmiş; her koşulda tepe video belleği (VRAM) ve decode hızı ölçülmüştür. Kalite için iğne-samanlık testi (needle-in-a-haystack)【27】 kurulmuştur: samanlık BellaTurca veri setinin AkademikDerlem alt kümesindeki uzun Türkçe metinlerden【28】 (gerekirse birkaç metin uç uca eklenerek), iğne ise bu çalışmada yazılmış, cevabı bir sayı olan Türkçe cümlelerden oluşturulmuştur. İğne bağlamın beş farklı derinliğine yerleştirilmiş ve her bağlam uzunluğu ile derinlikte beş farklı iğne denenmiştir. İkinci kısımda Qwen3-0.6B ve Qwen3-8B'nin Q4_K_M kopyalarında yalnızca lm_head'in türü değiştirilmiş (Q8_0 ve Q4_K); Belebele-tr, ARC-tr, KL ıraksaması ve disk boyutu ölçülmüştür. Qwen3-0.6B'de embedding tablosu ile lm_head aynı ağırlıkları paylaşır;【29】 bu modelde ikisi birlikte değişir.
Beklenti ve Yorum: KV belleğinin bağlamla doğrusal büyümesi ve q8_0'ın bu eğimi yaklaşık yarıya indirmesi, q8_0'da geri çağırmanın korunması, q4_0'da en uzun bağlamda bozulma başlaması beklenir; lm_head'i 4 bite indirmenin 0.6B'de hem belirgin bellek kazancı hem belirgin kayıp, 8B'de ise küçük kazanç ve küçük kayıp oluşturması beklenir. q8_0 KV her uzunlukta geri çağırmayı korursa uzun bağlamlı yerel kullanımda 8 bitlik KV varsayılan seçenek olabilir; bozulma bağlamın ortasındaki iğnelerde yoğunlaşırsa KV kuantizasyonu modelin zaten zayıf olduğu bölgeyi daha da zayıflatıyor olabilir; küçük modelde geri çağırma büyük modelden belirgin biçimde daha çok düşerse KV kuantizasyonunun bedeli model boyutuna bağlıdır.
Bulgular (KV Ön Belleği): Qwen3-8B Q8_0'da KV ön belleği belleği bağlamla doğrusal büyümüş ve ölçülen değer formülle birebir aynı bulunmuştur: F16'da 4K, 16K ve 32K bağlamda 576, 2304 ve 4608 MiB. q8_0 KV bunu 306, 1224 ve 2448 MiB'a (F16'nın %53'ü), q4_0 ise 162, 648 ve 1296 MiB'a (%28'i) indirmiştir. Tepe VRAM 32K'de 12.7 GiB'tan 10.7 GiB'a (q8_0) ve 9.5 GiB'a (q4_0) inmiştir; ağırlıklar (yaklaşık 8 GiB) sabit olduğundan toplamdaki kazanç %16 ve %25 olmuştur.
Hız Bedeli: Kuantize KV ön belleği hızlanma değil yavaşlama ile sonuçlanmıştır: 32K bağlamda decode hızı F16'da 141.7, q8_0'da 105.6 ve q4_0'da 103.7 token/s olmuştur (F16'nın %75'i ve %73'ü); 4K'da bu oran %90–91'dir. Bu sonuç llama.cpp'nin kendi çekirdekleriyle ölçülmüştür; başka motorlarda farklı olabilir.
Geri Çağırma: İğne-samanlık testinde (3 bağlam × 5 derinlik × 5 iğne = 75 deneme) geri çağırma KV türüne ve model boyutuna göre farklılaşmıştır. Qwen3-8B'de F16 KV 74/75, q8_0 73/75 ve q4_0 71/75 doğru yanıt vermiştir: q8_0'da F16'ya göre bir iğne eksik (−1.3 puan), q4_0'da üç iğne eksik (−4.0 puan) bulunmuştur. Kayıp 4K'da gözlenmemiş; 16K'da yalnızca %50 derinlikte, 32K'da ise q4_0'da %25 ve %50 derinliklerde toplanmıştır. Qwen3-1.7B'de aynı sıralama daha belirgin olmuştur: F16 67/75, q8_0 64/75 ve q4_0 58/75 (−4.0 ve −12.0 puan); q4_0'da kayıp 4K'da başlamış (24/25), q8_0'da 16K'dan başlamıştır; kayıplar 32K'da orta derinliklerde yoğunlaşmıştır.
Tablo 7: İğne-Samanlık Testinde Geri Çağırma
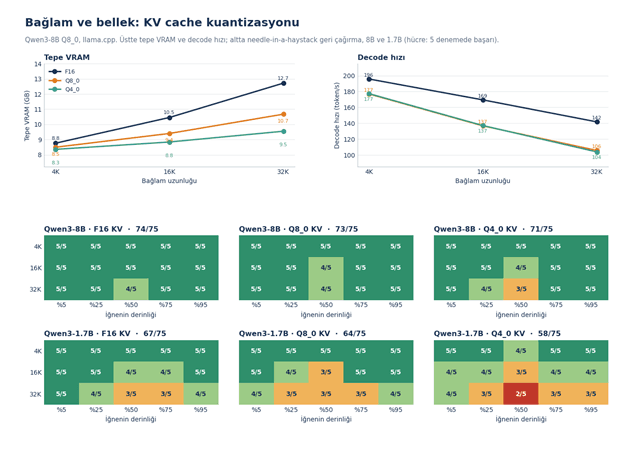
KV Ön Belleği Kuantizasyonu: VRAM, Hız ve Geri Çağırma (Çizim: Elif İnce)
Her hücre 5 derinlik × 5 iğne (25 deneme) içerir; Qwen3-8B ve Qwen3-1.7B modelleri Q8_0 ağırlıklarla ve llama.cpp ile çalıştırılmıştır. KV belleği formülle birebir uyumlu bulunmuştur (F16: 576, 2304, 4608 MiB); 32K'da kuantize KV decode hızını F16'nın yaklaşık %75'ine düşürmüştür.
lm_head: Qwen3-0.6B'de (gömme tablosuyla paylaşıldığı için ikisi birlikte değişir) lm_head'in toplam boyuttaki payı varsayılan Q4_K_M'de %32.7 (127.6 MB), Q8_0'da %38.6 (165.3 MB), Q4_K'da %25.0 (87.5 MB) olmuştur; Qwen3-8B'de bu değerler %10.2 (510.5 MB), %12.8 (661.2 MB) ve %7.2 (350.1 MB)'dir. Q8_0'dan Q4_K'ya inmek dosya boyutunu 0.6B'de %18 (428 → 351 MB), 8B'de %6 (5.17 → 4.86 GB) küçültmüştür. Doğrulukta anlamlı bir fark gözlenmemiştir: Q4_K − Q8_0 farkı 0.6B'de +0.40 puan (GA [−0.75, +1.55]), 8B'de −0.03 [−0.64, +0.56] olmuştur. KL ise artmıştır: 0.6B'de 0.120'den 0.154'e (%29), 8B'de 0.036'dan 0.048'e (%32).
Tablo 8: lm_head Türü ve Model Boyutuna Göre Boyut, Doğruluk ve KL
Taban satırları birinci yazıdaki varsayılan Q4_K_M kopyalarıdır. Her hücre tek koşum ve tek tohumdur; Q4_K − Q8_0 doğruluk farklarının (Belebele-tr ve ARC-tr ortalaması) %95 GA'sı sıfırı içeriyor (0.6B: +0.40 [−0.75; +1.55]; 8B: −0.03 [−0.64; +0.56]).
Sonuç E2: 8 bitlik KV önbelleği belleği %47, 4 bitlik %72 azaltmıştır; bedel 32K bağlamda decode hızında ≈%25 (4K'da ≈%10, 16K'da ≈%19). Geri çağırma 8B'de q8_0'da büyük ölçüde korunmuş (−1.3 puan), q4_0'da toplamda −4.0 puan (32K'da −8.0 puan) düşmüştür; 1.7B'de düşüş daha büyük olmuş (−4.0 ve −12.0 puan) ve orta derinliklerde yoğunlaşmıştır. lm_head'i Q8_0'dan Q4_K'ya indirmek küçük modelde dosya boyutunu %18 küçültürken kıyaslama testi doğruluğunda anlamlı bir değişiklik gözlenmemiş, KL %29–32 artmıştır; büyük modelde kazanç küçük kalmıştır (%6).
Tablo 9: Deneylerin Özeti
Taşınabilirlik: Hassasiyet haritası tek bir modelde (Qwen3-4B), tek bir dilde ve tek bir bit düzeyinde (2 bit RTN) çıkarılmıştır; reçete kuralı yalnızca aynı ailedeki Qwen3-8B'ye taşınmıştır. Haritanın başka model ailelerine, başka dillere ve başka bit bütçelerine ne kadar taşındığı ölçülmemiştir; bu durumlarda reçete ayrıca doğrulanmalıdır.
Kapsam: Bulgular Qwen3 ailesinin yoğun modellerine, Türkçeye, çoktan seçmeli kıyaslama testlerine, llama.cpp'ye, tek bir H100 GPU'ya ve belirli yazılım sürümlerine aittir; reçete ve lm_head koşumları tek rastgelelik tohumuyla yapılmıştır. İğne-samanlık testi en fazla 32 bin token'lık bağlamda tek bir sayının geri çağrılmasını ölçmüştür; daha uzun bağlamda ve birden fazla bilgiyi birleştirmeyi gerektiren görevlerde KV kuantizasyonunun bedeli farklı olabilir. Aktivasyon kuantizasyonu deneysel olarak sınanmamıştır; MoE modeller ve kuantizasyonla birlikte eğitim de kapsam dışıdır.
Kesinlik: Kuantizasyon yaklaşık bir dönüşümdür: her kuant, orijinal modelden ölçülebilir bir sapma taşır. Bu sapmanın kullanım için önemli olup olmadığı ancak hedef görevde ve hedef dilde ölçülerek söylenebilir.
GGUF dosyaları her tensörün türünü dosyanın içinde saklar; llama.cpp'nin araçları ya da Hugging Face'in dosya görüntüleyicisi hangi tensörün Q6_K, hangisinin Q4_K olduğunu gösterir.【30】 llama.cpp'nin K-quant türleri zaten karma reçetelerdir; Unsloth'un Dynamic kuantları ise reçeteyi model bazında belirler.【31】 Bu reçetelerin Türkçedeki davranışı, hazırlandıkları kalibrasyon verisinin içeriğiyle ilgili olabilir; E1'de Türkçe haritadan kurulan reçete, aynı boyuttaki tekdüze kuanttan doğrulukta ve KL'de daha iyi sonuç verdi (tek model, tek koşum).
Bellek darboğazı ağırlıklardan çok bağlam uzunluğundan ya da eşzamanlı kullanıcı sayısından geliyorsa. E2'de 8 bitlik KV belleği yaklaşık yarıya indirmiş; geri çağırmayı 8B'de büyük ölçüde korumuştur (1.7B'de −4.0 puan); 4 bitlik KV ise uzun bağlamda ve küçük modelde geri çağırmayı daha belirgin düşürmüştür. llama.cpp'de iki türün de 32 bin token'lık bağlamda decode hızını yaklaşık %25 yavaşlattığı hesaba katılmalıdır.
Bu yazının ölçümlerinde, bit bütçesi her tensöre eşit dağıtılmak yerine kuantizasyondan en çok etkilenen tensörlere ayrıldığında aynı boyutta daha düşük sapma elde edilmiştir; birinci yazının başındaki iki cevaptan birini üreten Q4_K_M kuantı bu fikrin yaygın bir uygulamasıdır. E1'de Qwen3-4B için Türkçe hassasiyet haritasından kurulan reçete, aynı boyuttaki tekdüze kuanttan KL'de %13 daha düşük, doğrulukta +0.9 puan (GA [+0.1, +1.7]) daha iyi bulunmuş; rastgele dağıtılmış kontrol reçetelerinden ayrışmış (yaklaşık +2 puan, KL'de yaklaşık %25) ve Unsloth Dynamic'ten doğrulukta ayırt edilememiştir (+0.97, GA [−0.3, +2.3]). Aynı kural Qwen3-8B'ye aktarıldığında benzer yönde bir fark görülmüştür (+0.93, GA [+0.0, +1.8]); ancak bu iki model tek örnektir.
KV Ön Belleği ve lm_head: E2'de 8 bitlik KV önbelleği belleği %47, 4 bitlik %72 azaltmıştır; 8B'de geri çağırma q8_0'da pratikte korunmuş (−1.3 puan), q4_0'da toplamda −4.0 puan (32K'da −8.0 puan) düşmüş, 1.7B'de düşüş daha büyük olmuştur (−4.0 ve −12.0 puan); bedel, 32K bağlamda decode hızının F16'nın yaklaşık %75'ine inmesidir (4K'da %90–91). lm_head'in Q8_0'dan Q4_K'ya indirilmesi dosya boyutunu 0.6B'de %18, 8B'de %6 küçültmüş, doğrulukta fark saptanmamış (GA içinde), ancak KL'yi %29–32 artırmıştır.
Seri Geneli: Birinci ve ikinci yazılarda ölçüldüğü gibi, kuantizasyondaki kayıp bit sayısına, yönteme, kalibrasyona, model boyutuna ve ölçüte göre değişmiştir: 8 bitte kayıp çoğunlukla gürültü düzeyine yakın (Qwen3-8B FP8 hariç), 4 bitte yönteme bağlı, yaklaşık 3 bitte (Q2_K) ise altı modelin hepsinde kırılma eşiği aşılmıştır.
Sınır: Hassasiyet haritası tek modelde (Qwen3-4B), tek dilde ve tek bit düzeyinde (2 bit RTN) çıkarılmıştır; reçete kuralı yalnızca Qwen3-8B'ye taşınmış, başka ailelere, dillere ve bit bütçelerine taşınabilirliği ölçülmemiştir. Bulgular Qwen3'ün yoğun modelleri, Türkçe, çoktan seçmeli kıyaslama testleri, llama.cpp ve tek bir H100 GPU için geçerlidir; reçete ve lm_head koşumları tek tohumludur, iğne-samanlık testi en fazla 32 bin token'da tek bir sayıyı ölçer; aktivasyon kuantizasyonu sınanmamış, MoE modeller ve kuantizasyonla birlikte eğitim kapsam dışı bırakılmıştır (ayrıntı: Tartışma ve Sınırlar).
Açık Sorular: İki soru açık kalmıştır: hassasiyet haritaları diller arasında ne kadar taşınabilir (aile içinde 4B → 8B aktarımı benzer yönde bir fark verdi; tek örnek) ve 3 bitin altındaki sınır eğitim sonrası yöntemlerle aşılabilir mi? Son soru, serinin birinci yazısının girişinde değinilen konuyla ilişkilidir. Kimi K3'ün ağırlıkları doğrudan MXFP4 olarak dağıtılmaktadır;【32】 daha önce Kimi K2 Thinking'in MoE bileşenlerinin INT4 ağırlıkları eğitim sonrası aşamada düşük bit gözetilerek elde edilmiş, gpt-oss da MoE ağırlıkları MXFP4'e indirilmiş hâlde son eğitimden geçirilmişti.【33】 Bu modellerde kuantizasyon yalnızca eğitimden sonra uygulanmamış; düşük bit hassasiyeti eğitim sürecinde de hesaba katılmıştır.【34】 Bu yaklaşımın adı kuantizasyon farkındalıklı eğitim (quantization-aware training, QAT). Düşük bit hassasiyetinin eğitim sırasında hesaba katılması, eğitim sonrası kuantizasyonun sınırlarını ne ölçüde aşabilir? Bu soru, eğitim sonrası kuantizasyonu (post-training quantization, PTQ) kuantizasyon farkındalıklı eğitimle karşılaştıran ayrı bir yazıda ele alınacaktır.
Bandarkar, L., D. Liang, B. Muller, M. Artexte, S. N. Shukla, vd. “The Belebele Benchmark: a Parallel Reading Comprehension Dataset in 122 Language Variants.” arXiv 2024. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2308.16884
Clark, P., I. Cowhey, O. Etzioni, T. Khot, A. Sabharwal, vd. “Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge.” arXiv 2018. Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/1803.05457
Dettmers, T., M. Lewis, Y. Belkada ve L. Zettlemoyer. “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale.” arXiv 2022. Erişim tarihi: 30 Eylül 2026. https://arxiv.org/abs/2208.07339
Dutta, A., S. Krishnan, N. Kwatra ve R. Ramjee. “Accuracy is Not All You Need.” arXiv 2024. Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2407.09141
EleutherAI. “Language Model Evaluation Harness.” GitHub. Erişim tarihi: 13 Ekim 2026. https://github.com/EleutherAI/lm-evaluation-harness
Frantar, E., S. Ashkboos, T. Hoefler ve D. Alistarh. “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers.” arXiv 2023. Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2210.17323
Kamradt, Greg. “Needle in a Haystack.” GitHub. Erişim tarihi: 4 Ekim 2026. https://github.com/gkamradt/needle-in-a-haystack
Liu, Z., J. Yuan, H. Jin, S. Zhong, Z. Xu, vd. “KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache.” arXiv 2024. Erişim tarihi: 4 Ekim 2026. https://arxiv.org/abs/2402.02750
Moonshot AI. “Kimi K2 Thinking.” Hugging Face. Erişim tarihi: 10 Ekim 2026. https://huggingface.co/moonshotai/Kimi-K2-Thinking
Moonshot AI. “Kimi K3.” GitHub. Erişim tarihi: 12 Ekim 2026. https://github.com/MoonshotAI/Kimi-K3
Open Language Data Initiative. “FLORES+.” Hugging Face. Erişim tarihi: 3 Ekim 2026. https://huggingface.co/datasets/openlanguagedata/flores_plus
OpenAI, S. Agarwal, L. Ahmad, J. Ai, S. Altman, vd. “gpt-oss-120b & gpt-oss-20b Model Card.” arXiv 2025. Erişim tarihi: 13 Ekim 2026. https://arxiv.org/abs/2508.10925
PyTorch. “Quantization.” PyTorch 2.5 Dokümantasyonu. Erişim tarihi: 10 Ekim 2026. https://docs.pytorch.org/docs/2.5/quantization.html
Turkish NLP Suite. “BellaTurca.” Hugging Face. Erişim tarihi: 5 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/BellaTurca
Turkish NLP Suite. “Havadis.” Hugging Face. Erişim tarihi: 1 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/Havadis
Unsloth. “Unsloth Dynamic 3.0 GGUFs.” Unsloth Dokümantasyonu. Erişim tarihi: 14 Ekim 2026. https://unsloth.ai/docs/basics/dynamic-3.0-ggufs
Xiao, G., J. Lin, M. Seznec, H. Wu, J. Demouth ve S. Han. “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models.” arXiv 2024. Erişim tarihi: 1 Ekim 2026. https://arxiv.org/abs/2211.10438
Yang, A., A. Li, B. Yang, B. Zhang, B. Hui, vd. “Qwen3 Technical Report.” arXiv 2025. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2505.09388
ggml-org. “llama.cpp: LLM Inference in C/C++.” GitHub. Erişim tarihi: 6 Ekim 2026. https://github.com/ggml-org/llama.cpp
malhajar. “arc-tr-v0.2.” Hugging Face. Erişim tarihi: 8 Ekim 2026. https://huggingface.co/datasets/malhajar/arc-tr-v0.2
[1]
ggml-org, “llama.cpp: LLM Inference in C/C++,” GitHub, Erişim tarihi: 6 Ekim 2026. https://github.com/ggml-org/llama.cpp
[2]
ggml-org, “llama.cpp: LLM Inference in C/C++.”
[3]
Unsloth, “Unsloth Dynamic 3.0 GGUFs,” Unsloth Dokümantasyonu, Erişim tarihi: 14 Ekim 2026. https://unsloth.ai/docs/basics/dynamic-3.0-ggufs
[4]
T. Dettmers, M. Lewis, Y. Belkada ve L. Zettlemoyer, “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale,” arXiv 2022, 9, Erişim tarihi: 30 Eylül 2026. https://arxiv.org/abs/2208.07339
[5]
PyTorch, “Quantization,” PyTorch 2.5 Dokümantasyonu, Erişim tarihi: 10 Ekim 2026. https://docs.pytorch.org/docs/2.5/quantization.html
[6]
Unsloth, “Unsloth Dynamic 3.0 GGUFs.”
[7]
T. Dettmers, vd., “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale,” 9.
[8]
G. Xiao, J. Lin, M. Seznec, H. Wu, J. Demouth ve S. Han, “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models,” arXiv 2024, 2-4, 8-9, Erişim tarihi: 1 Ekim 2026. https://arxiv.org/abs/2211.10438
[9]
A. Yang, A. Li, B. Yang, B. Zhang, B. Hui, vd., “Qwen3 Technical Report,” arXiv 2025, 5-8, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2505.09388
[10]
Z. Liu, J. Yuan, H. Jin, S. Zhong, Z. Xu, vd., “KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache,” arXiv 2024, 2, 6, Erişim tarihi: 4 Ekim 2026. https://arxiv.org/abs/2402.02750
[11]
A. Yang, A. Li, B. Yang, B. Zhang, B. Hui, vd., “Qwen3 Technical Report,” 5-8.
[12]
G. Xiao, J. Lin, M. Seznec, H. Wu, J. Demouth ve S. Han, “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models,” arXiv 2024, 2-4, 8-9, Erişim tarihi: 1 Ekim 2026. https://arxiv.org/abs/2211.10438
[13]
A. Yang, vd. “Qwen3 Technical Report,” 5-8.
[14]
ggml-org, “llama.cpp: LLM Inference in C/C++.”
[15]
Turkish NLP Suite, “BellaTurca,” Hugging Face, Erişim tarihi: 5 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/BellaTurca
[16]
L. Bandarkar, D. Liang, B. Muller, M. Artexte, S. N. Shukla, vd., “The Belebele Benchmark: a Parallel Reading Comprehension Dataset in 122 Language Variants,” arXiv 2024, 7, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2308.16884
[17]
malhajar, “arc-tr-v0.2,” Hugging Face, Erişim tarihi: 8 Ekim 2026. https://huggingface.co/datasets/malhajar/arc-tr-v0.2; P. Clark, I. Cowhey, O. Etzioni, T. Khot, A. Sabharwal, vd., “Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge,” arXiv 2018, 2, 7, Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/1803.05457
[18]
G. Kamradt, “Needle in a Haystack,” GitHub, Erişim tarihi: 4 Ekim 2026. https://github.com/gkamradt/needle-in-a-haystack
[19]
EleutherAI, “Language Model Evaluation Harness,” GitHub, Erişim tarihi: 13 Ekim 2026. https://github.com/EleutherAI/lm-evaluation-harness
[20]
Turkish NLP Suite, “Havadis,” Hugging Face, Erişim tarihi: 1 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/Havadis
[21]
A. Dutta, S. Krishnan, N. Kwatra ve R. Ramjee. “Accuracy is Not All You Need,” arXiv 2024, 7-9, Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2407.09141
[22]
Turkish NLP Suite, “BellaTurca.”
[23]
E. Frantar, S. Ashkboos, T. Hoefler ve D. Alistarh, “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” arXiv 2023, 4, 6-8, Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2210.17323
[24]
Turkish NLP Suite, “Havadis.”
[25]
L. Bandarkar, vd., “The Belebele Benchmark: a Parallel Reading Comprehension Dataset in 122 Language Variants,” 7; Open Language Data Initiative, “FLORES+,” Hugging Face, Erişim tarihi: 3 Ekim 2026. https://huggingface.co/datasets/openlanguagedata/flores_plus
[26]
Unsloth, “Unsloth Dynamic 3.0 GGUFs.”
[27]
Greg Kamradt, “Needle in a Haystack.”
[28]
Turkish NLP Suite, “BellaTurca.”
[29]
A. Yang, vd., “Qwen3 Technical Report,” 5-8.
[30]
ggml-org, “llama.cpp: LLM Inference in C/C++.”
[31]
Unsloth, “Unsloth Dynamic 3.0 GGUFs.”
[32]
Moonshot AI, “Kimi K3,” GitHub, Erişim tarihi: 12 Ekim 2026. https://github.com/MoonshotAI/Kimi-K3
[33]
Moonshot AI, “Kimi K2 Thinking,” Hugging Face, Erişim tarihi: 10 Ekim 2026. https://huggingface.co/moonshotai/Kimi-K2-Thinking; OpenAI, S. Agarwal, L. Ahmad, J. Ai, S. Altman, vd., “gpt-oss-120b & gpt-oss-20b Model Card,” arXiv 2025, 3, Erişim tarihi: 13 Ekim 2026. https://arxiv.org/abs/2508.10925
[34]
Moonshot AI, “Kimi K3"; Moonshot AI, “Kimi K2 Thinking”; OpenAI, vd., "gpt-oss-120b & gpt-oss-20b Model Card,” 3.

Ağırlıklar Belleğin Tek Kalemi Değil: Bit Bütçesi ve KV Ön Belleği
Her Katman Aynı Biçimde Mi Sıkıştırılmalı?
Hangi Katmanın Hassas Olduğu Nasıl Bulunur?
Derine İn: "Dinamik" Kelimesinin İki Anlamı
Ağırlıkların Dışında Neler Sıkıştırılabilir?
Aktivasyonlar Neden Ağırlıklardan Zor Sıkıştırılır?
KV Ön Belleği Uzun Bağlamda Belleği Nasıl Büyütür?
Embedding ve lm_head
Derine İn: SmoothQuant Zorluğu Nasıl Taşır?
Karma Reçete, KV Ön Belleği ve lm_head Üzerine İki Deney
Deneylerde Kullanılan Modeller, Kuantlar ve Ölçütler
Derine İn: Kurulum Ayrıntıları
Hangi Tensörler Hassas ve Haritadan Kurulan Reçete Ne Kazandırır?
KV Cache ve lm_head Ne Kadar Sıkıştırılabilir?
Tartışma ve Sınırlar
Sık Sorulan Sorular
Hazır Bir Kuantın Karma Hassasiyetli Olup Olmadığı Nasıl Anlaşılır?
KV Ön Belleği Ne zaman Sıkıştırılmalıdır?
Bit Bütçesini Dağıtmanın ve KV Önbelleğini Sıkıştırmanın Sonuçları