Ana bulgular: Bu yazıda Qwen3 ailesinin altı yoğun modeli altı farklı kuantla sıkıştırılmış ve Türkçe kıyaslama testleri (benchmark) ile ölçülmüştür: önce ölçüm zincirinin güvenilirliği (E0), ardından model boyutu ve bit sayısının etkisi (E1) sınanmıştır. Bulgular kısaca şöyledir:
Sınır: Bulgular Qwen3 ailesindeki altı yoğun model, Türkçe çoktan seçmeli kıyaslama testleri ve belirli yazılım sürümleriyle sınırlıdır.
Bu yazı, üç bölümlük "Kuantizasyon" serisinin birinci yazısıdır. Seri boyunca Qwen3 ailesi Türkçe veri ve Türkçe kıyaslama testleriyle sınanmaktadır: ikinci yazı yöntem seçimini, kalibrasyon dilini, bellek bütçesini ve hızı; üçüncü yazı karma hassasiyeti, KV önbelleği (KV cache) ve dil modelle katmanı (lm_head) kuantizasyonunu ele almaktadır.
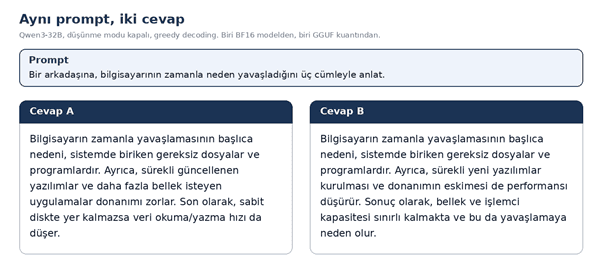
Aynı İstem, İki Cevap (BF16 ve GGUF Kuant) (Çizim: Elif İnce)
Görseldeki iki cevaptan biri, ağırlıkları yaklaşık üçte birine sıkıştırılmış bir modelden geldi. Hangisinin kuantize modelden geldiği, "Kuantizasyon Bir Ağırlığa Ne Yapar?" bölümünün sonunda açıklanacaktır.
Yapay zekâ uygulamalarında ortak bir sorun, eldeki donanımdan en yüksek verimin nasıl alınacağıdır. Model sağlayıcıları için hedef, aynı donanımla mümkün olduğunca çok kullanıcıya cevap verebilmektir. Müşteri verisinin kurum dışına çıkmaması için modelin kendi sunucuda barındırıldığı kurulumlarda her ek GPU (grafik işlem birimi) aylık maliyeti artırır. Mobil uygulamalarda modelin internet bağlantısı olmadan telefonda çalışması istenebilir. Bireysel kullanımda açık kaynaklı bir kodlama modelinin dizüstü bilgisayarda çalıştırılması istendiğinde ekran kartı belleği 8 ile 24 GB arasında kalabilir.
Daha fazla GPU edinmek maliyeti, daha küçük bir model seçmek ise kalite kaybını beraberinde getirir.
Kuantizasyon (quantization) bu soruna donanım yerine modelin kendisi üzerinden yaklaşır: ağırlıkları ve gerekirse çalışma sırasında oluşan ara değerleri daha az bitle saklar. Yöntem günümüzde yapay zekâ uygulamalarında yaygın biçimde kullanılmaktadır. En büyük açık ağırlıklı modellerden Kimi K3'ün ağırlıkları doğrudan 4 bitlik MXFP4 biçiminde yayımlanmaktadır;【1】 DeepSeek-V3 ise eğitiminin hesaplama yoğun işlemlerinin çoğunu FP8 karma hassasiyetle gerçekleştirmiştir.【2】 Bir modelin baştan 4 bit olarak yayımlanmasının arkasındaki fikre serinin son yazısının sonunda dönülecektir.
Bu yazıda önce dev bir modelin belleğe neden sığmadığı ve belleğin nereye gittiği hesaplanacaktır. Ardından kuantizasyonun ağırlıklara adım adım ne yaptığı ve sürecin zorlukları ele alınacaktır. Son olarak 0.6 milyardan 32 milyar parametreye uzanan altı Qwen3 modeli altı farklı kuantla sıkıştırılıp model boyutu ile bit sayısının Türkçe doğruluğu nasıl değiştirdiği ölçülecektir.
Bir modelin ağırlıkları için gereken bellek basit bir çarpımla kestirilir: parametre sayısı × parametre başına düşen bayt. Bugün modellerin çoğu BF16 (bfloat16) biçiminde yayımlanır ve bu biçimde her parametre 2 bayt tutar. Aynı çarpım, en büyük modellerin neden sıradan bir donanıma sığmadığını gösterir.
Tablo 1: Belirli Büyük Dil Modellerinin BF16, FP8 ve Yaklaşık 4 bit Hassasiyette Ağırlık Belleği ve Gereken H100 Sayısı (Yalnızca Ağırlıklar)
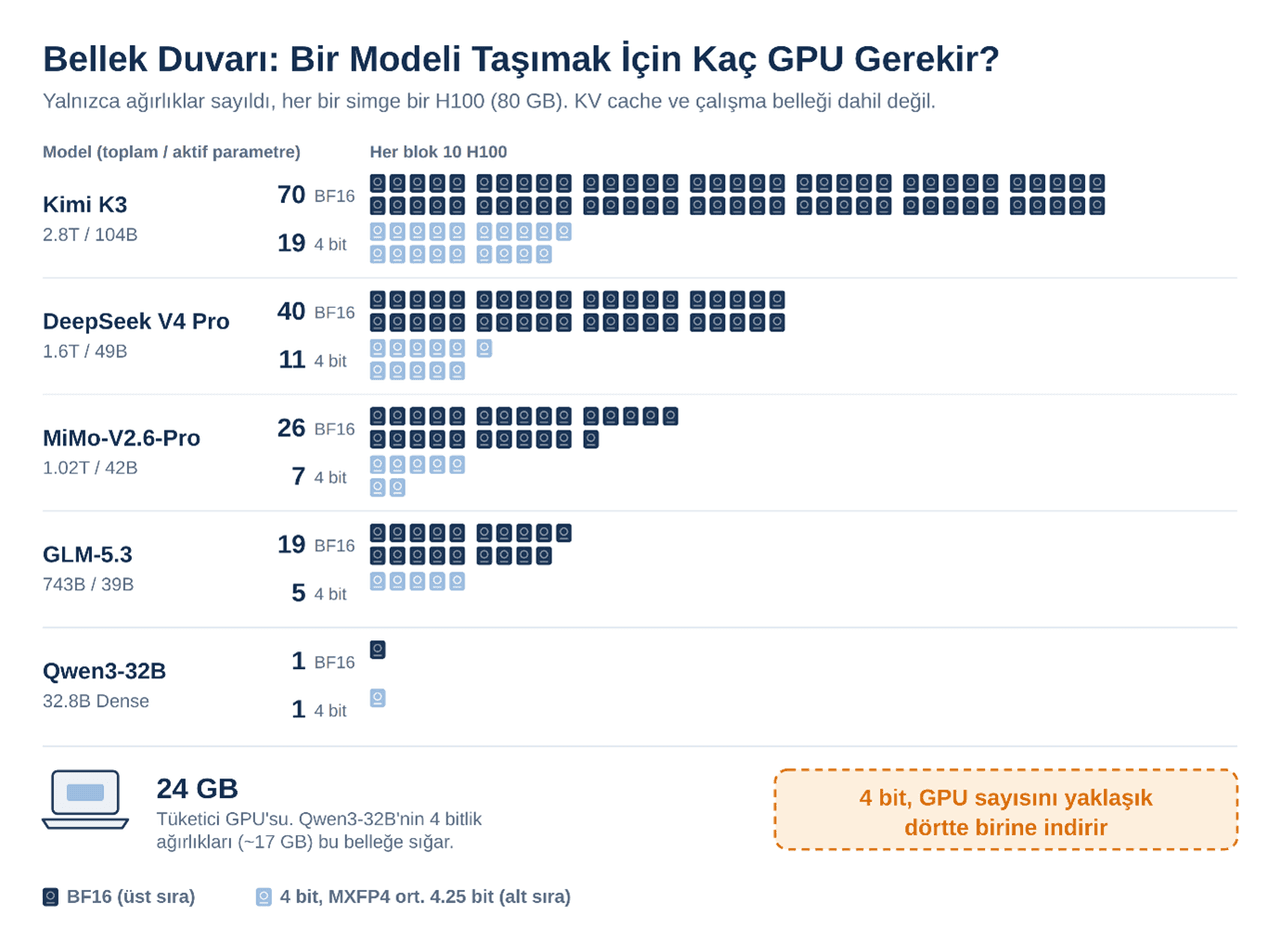
Çeşitli Modellerde Ağırlık Belleği İçin Gereken H100 Sayısı (Çizim: Elif İnce)
Tablodaki ilk dört model uzman karışımı (Mixture-of-Experts, MoE) mimarisindedir: her belirteç (token) yalnızca birkaç uzmanı (expert) çalıştırır. Bellek ihtiyacını toplam parametre sayısı, token başına yapılan işi ise aktif parametre sayısı belirler. Kimi K3'ün 2.8 trilyon parametresinin her token için yalnızca yaklaşık 104 milyarı çalışır; ancak 2.8 trilyonun tamamı bellekte bulunmak zorundadır.
Tabloda yalnızca ağırlıklar sayılmıştır, KV cache ve çalışma belleği dahil değildir. 4 bit sütunu, 32 değerde bir 8-bitlik ölçek taşıyan MXFP4 için ortalama 4.25 bit varsayar. İlk dört model BF16 hâlinde 19 ile 70 arasında H100 gerektirir ve 4 bite inmek bu sayıyı yaklaşık dörtte birine indirir. Dört H100 (toplam 320 GB) bulunsa bile bu dört modelden hiçbiri 4 bitte yüklenemez. Bu nedenle deneyler tek bir GPU'ya sığan Qwen3 ailesiyle yapılmıştır.
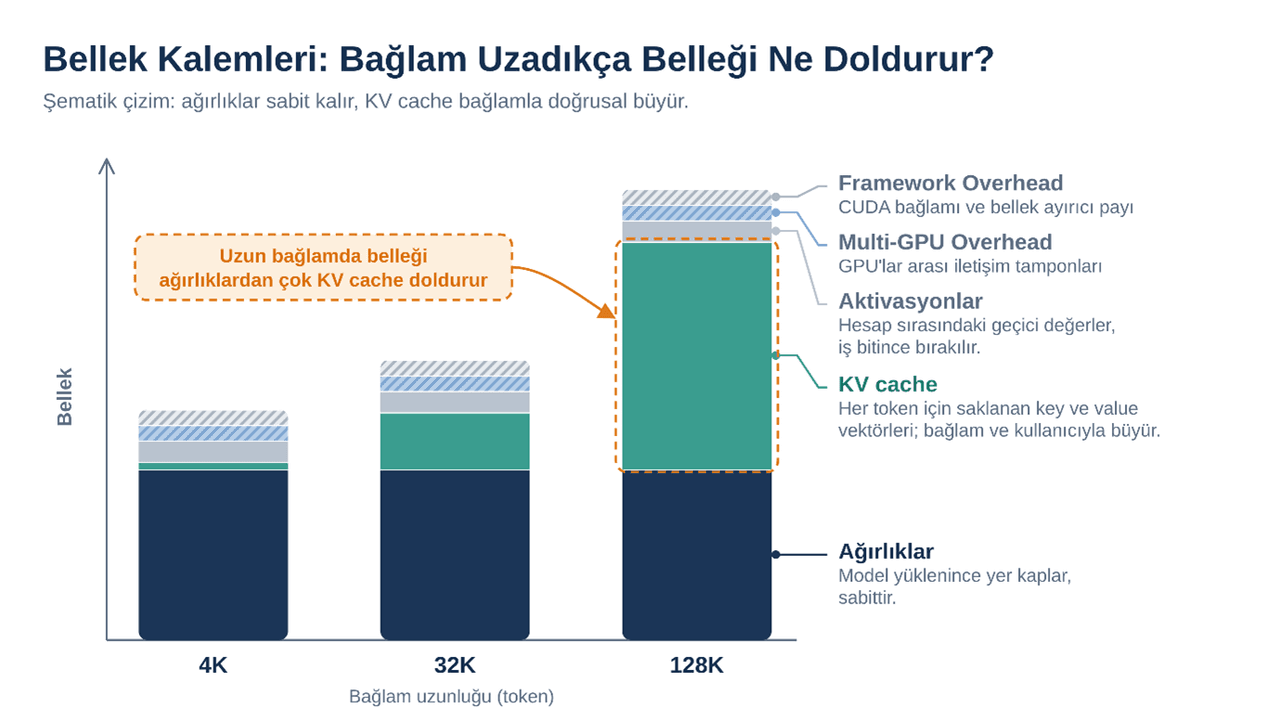
Bellek Kalemleri ve Büyüyen KV Cache Payı Temsili (Çizim: Elif İnce)
Çalışan bir modelin belleği üç ana kaleme bölünür. Ağırlıklar model yüklendiği anda yer kaplar ve sabittir. KV (anahtar-değer) önbelleği (KV cache), modelin daha önce işlediği her token için her katmanda sakladığı anahtar (key) ve değer (value) vektörleridir. Bağlam uzadıkça ve eşzamanlı kullanıcı sayısı arttıkça doğrusal büyür. Aktivasyonlar ise bir katmanın hesabı sırasında oluşan geçici değerlerdir ve hesap tamamlandığında serbest bırakılır. Bunlara çerçeve (CUDA bağlamı) ve çok GPU'lu kurulumlarda iletişim tamponları gibi küçük sabit paylar eklenir.
Ağırlık belleğinin hesabı yukarıda gösterilmiştir. KV cache'in büyüklüğü Qwen3-32B'nin yapılandırmasıyla şöyle hesaplanır: 64 katman, katman başına 8 KV head, head başına 128 boyut ve BF16 saklama.【8】 Bu modelde her token 0.25 MiB yer tutar. 32 bin token'lık tek bir sohbet 8 GiB eder; aynı uzunlukta 16 eş zamanlı sohbet ise 128 GiB tutar ve modelin BF16 ağırlıklarının iki katına yaklaşır. Uzun bağlamlı servislerde belleği ağırlıklardan çok KV cache doldurabilir. Bu durum, ağırlıkların dışındaki yapıların da sıkıştırılmasını gündeme getirir.
Model her yeni token'ı üretirken (decode aşaması) bütün ağırlıkları bellekten bir kez okur. Tek kullanıcı için bu okuma hesaplamanın kendisinden uzun sürer; bu yüzden üretim hızının teorik üst sınırı yaklaşık bellek bant genişliği ÷ model boyutu ile verilir. Bir H100'ün bant genişliği yaklaşık 3.35 TB/s'dir. Bu durumda 66 GB'lık BF16 Qwen3-32B için üst sınır saniyede yaklaşık 51 token, 17.4 GB'lık 4 bitlik kopyası için yaklaşık 192 token olur. Bu sayılar yalnızca bir üst sınır kestirimidir. Kuantizasyon bu nedenle modeli belleğe sığdırmanın yanında decode hızının teorik üst sınırını da yükseltir. MoE modellerde aynı hesapta toplam parametre yerine aktif parametreler okunur.
KV cache her katmanda bir key ve bir value tensörü sakladığı için formülün başında 2 çarpanı bulunur. Grouped-query attention kullanan modellerde KV head sayısı attention head sayısından küçüktür ve cache bu oranda küçülür; Qwen3-32B'de 64 attention head'e karşılık 8 KV head vardır.
Bu sınır tek kullanıcı içindir. Aynı anda birçok istek toplu işlendiğinde (batching) ağırlıklar bir kez okunup birçok token için kullanılır ve darboğaz hesaplama gücüne kayar.
Akılda kalsın: Ağırlık belleği parametre sayısı ile parametre başına bit sayısının çarpımıdır; bit sayısını azaltmak hem gereken GPU sayısını hem de her token için bellekten okunan veriyi azaltır.
Bir sayı formatı, sınırlı sayıda bitle hangi sayıların temsil edilebileceğini belirler. Kayan noktalı (floating point) bir sayı üç parçadan oluşur: işaret biti, sayının büyüklük mertebesini belirleyen üs (exponent) ve o mertebe içindeki inceliği belirleyen mantis (mantissa). Üse ayrılan bit temsil edilebilen aralığı, mantise ayrılan bit aralık içindeki adım inceliğini belirler. Tamsayı (integer) formatlarda ise değerler eşit aralıklı bir ızgaraya dizilir.
Tablo 2: Sayı Formatlarının Bit Yapısı ve Tipik Kullanımı
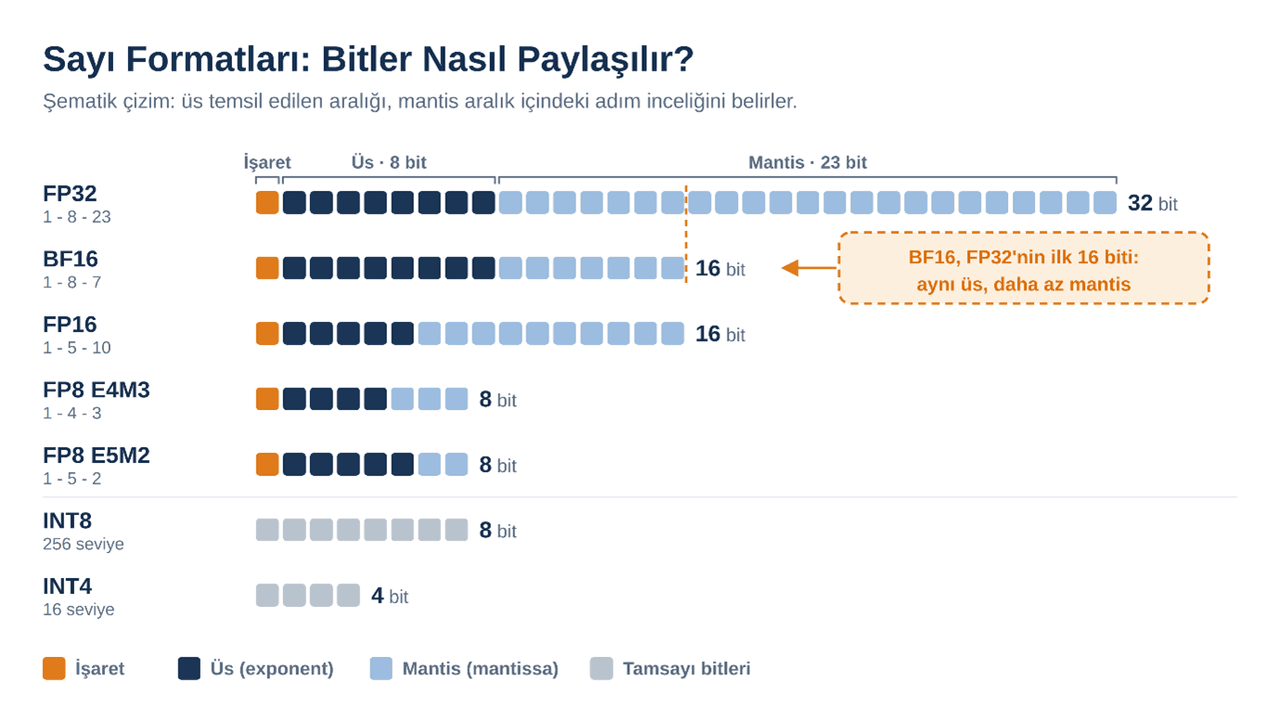
Sayı Formatlarında Bit Paylaşımı (Çizim: Elif İnce)
Bit sayısı azaldıkça ya temsil edilebilen aralık ya da aralık içindeki adım inceliği kaybedilir. Düşük bitli formatlar bu kaybı bir ölçekle (scale) telafi eder: sayılar önce ortak bir çarpana bölünür ve küçük ızgaraya bu şekilde yerleştirilir.
En basit yöntem, mutlak en büyük değere dayanan absmax eşlemesidir. Ölçek, satırdaki en büyük mutlak değerin ızgaranın en büyük tamsayısına bölünmesiyle bulunur; INT8 için bu sayı 127, INT4 için 7'dir. Her ağırlık ölçeğe bölünür ve en yakın tamsayıya yuvarlanır. Model çalışırken bu tamsayı yeniden ölçekle çarpılır; bu işleme geri dönüştürme (dequantization) denir. Geri dönen değer ile orijinal ağırlık arasındaki fark yuvarlama hatasıdır.
Bu bölüm boyunca aynı sekiz ağırlıklık satır kullanılacaktır: [0.21, −0.47, 0.08, 0.33, −0.15, 0.62, −0.29, 3.10]. Son değer, gerçek modellerde de görülen türden büyük bir aykırı değerdir (outlier). Bu satır önce INT8'e, sonra INT4'e indirilir.
Tablo 3: Örnek Satırın INT8 ve INT4'e Eşlenmesi (Simetrik Absmax)
Tablo temsilîdir; değerler simetrik absmax ve ortalama karesel hata (OKH, mean squared error) ile hesaplanmıştır. INT8'de her ağırlık en fazla 0.012'lik bir hatayla geri döner. INT4'te ise sekiz ağırlıktan üçü sıfıra yuvarlanır, kalan küçük ağırlıklar ±0.443 değerinde birleşir ve hata yaklaşık 330 kat büyür.
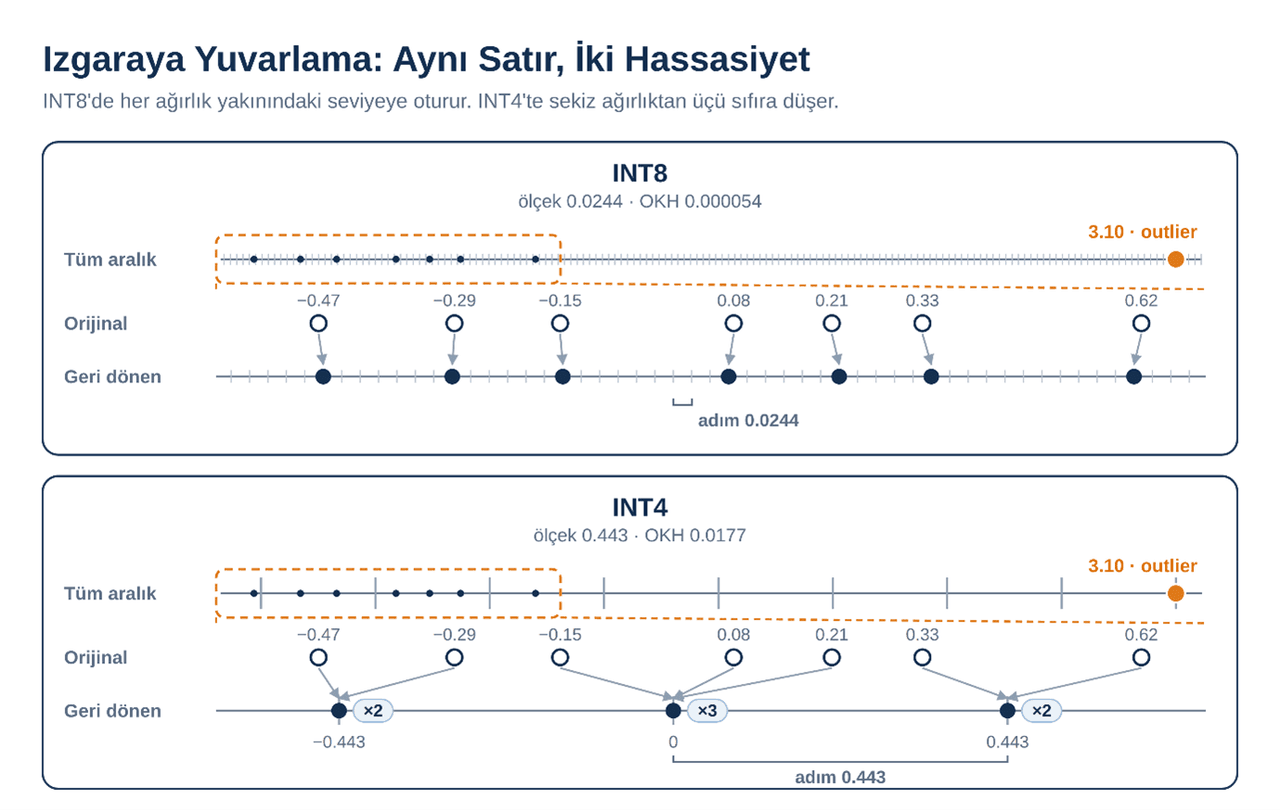
Izgaraya Yuvarlama: INT8 ve INT4 Yöntemleri (Çizim: Elif İnce)
INT4 sonucunun asıl nedeni 3.10 değeridir. Ölçeği bu tek değer belirlediği için ızgaranın adımı 0.443'e çıkar ve satırın geri kalanı bu adımla yuvarlanır. Aynı satırın ilk yedi ağırlığı outlier olmadan INT4'e indirildiğinde ölçek beşte birine (0.089) düşer ve bu yedi ağırlığın hatası 37 kat azalır.
Aynı durum gerçek modellerde de görülür. Büyük dil modellerinde belirli kanallarda sistematik olarak çok büyük değerler ortaya çıkar; bu outlier'lar özellikle aktivasyonlarda belirgindir ve model büyüdükçe daha sık görülür.【12】 Ağırlıklarda daha seyrek olsalar da tek bir büyük değer, ölçeği paylaşan bütün değerlerin hassasiyetini düşürür.
Çözümlerden ilki ölçeği daha küçük parçalara paylaştırmaktır. Bu parçalanma inceliğine granülerlik (granularity) denir. Tensör başına (per-tensor) kuantizasyonda bütün tensör için tek ölçek kullanılır. Kanal başına (per-channel) kuantizasyonda her kanalın kendi ölçeği vardır. Grup başına (per-group) kuantizasyonda bir kanal, örneğin 128 ağırlıklık gruplara bölünür ve her grubun ölçeği ayrı saklanır. MXFP4 aynı fikri 32 değerlik bloklarla donanım seviyesinde uygular.【13】 Örnekteki satır dörderli iki gruba bölünür.
Tablo 4: Örnek Satırın Dörderli Gruplarla INT4 Eşlenmesi
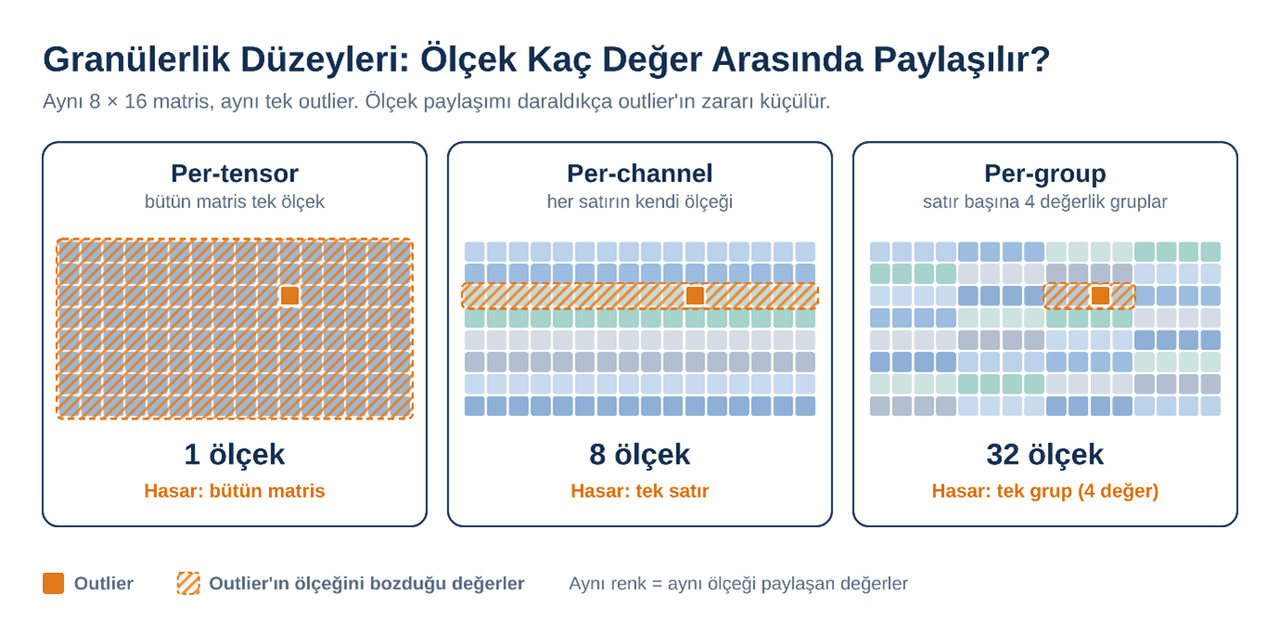
Granülerlik Düzeylerinde Ölçek Paylaşımı (Çizim: Elif İnce)
Birinci grup neredeyse hatasız döner ve outlier'ın zararı ikinci grupla sınırlı kalır. Satırın OKH değeri 0.0177'den 0.0097'ye iner. İkinci gruptaki küçük ağırlıklar ise yine kaybolur.
Granülerliğin bir bedeli vardır: her grup için bir ölçek saklanır. 128'lik gruplar ve 16 bitlik ölçeklerle ağırlık başına ortalama 4 + 16/128 = 4.125 bit, MXFP4'ün 32'lik bloklarıyla 4.25 bit harcanır. Grup küçüldükçe hata azalır, saklanan ölçek sayısı artar.
Girişteki sorunun cevabı şöyledir. Sıkıştırılmış model A cevabını üretti: Qwen3-32B'nin GGUF Q4_K_M kuantı (llama.cpp'nin, ağırlıkların çoğunu 4 bit civarında tutan biçimi), ağırlıkları 65.5 GB'tan 19.8 GB'a inmiş hâliyle. Cevap B, BF16 modelden geldi.
İki cevap kelime düzeyinde belirgin biçimde ayrışmaktadır (kelimelerin yaklaşık %51'i farklıdır); ancak ilk cümle birebir aynıdır, uzunlukları neredeyse eşittir (34 ve 36 kelime; 87 ve 89 token) ve ikisi de aynı iki fikri anlatmaktadır: biriken gereksiz dosyalar ve programlar ile yetersiz kalan donanım. Fark kelime seçiminde ve son cümlenin yönünde: A, disk dolunca okuma-yazma hızının düştüğünü söylüyor; B, bellek ve işlemci kapasitesinin sınırlı kalmasını. Ağırlıkların hemen hepsi bu bölümdeki türden yuvarlama hatalarıyla değişmiştir; buna rağmen cevap korunmuştur. Bu yalnızca tek bir örnektir ve kanıt değildir; dayanıklılığın bir eşiği vardır ve bu eşik deneylerde aranacaktır.
Bu bölümdeki eşleme simetriktir: ızgara sıfırın etrafında eşit dağılır. Değerleri tek yönde yığılan tensörlerde (örneğin ReLU sonrası aktivasyonlar) ızgaranın yarısı boşa gider. Asimetrik eşleme buna bir sıfır noktası (zero-point) ekler ve ızgarayı verinin gerçek aralığına kaydırır.【14】
Asimetrik eşleme aralığı daha iyi kullanır; karşılığında her ölçekle birlikte bir sıfır noktası saklanır ve çarpım biraz pahalılaşır. Ağırlıklar çoğunlukla sıfır etrafında dağıldığı için ağırlık kuantizasyonunda simetrik eşleme yaygındır.
Akılda kalsın: Kuantizasyon her ağırlığı ölçeklenmiş bir ızgaranın en yakın noktasına taşır. Izgaranın adımını satırın en büyük değeri belirlediği için tek bir outlier bütün satırı bozar. Ölçeği küçük gruplara bölmek ise bu zararı grubun içinde tutar.
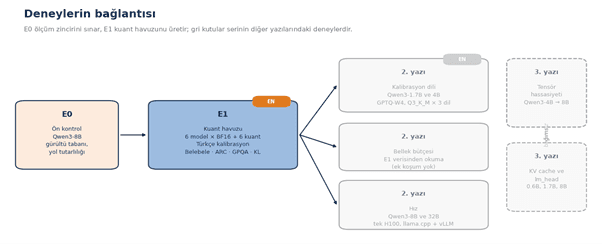
Deneylerin Bağlantısı (Çizim: Elif İnce)
Önceki bölümlerde anlatılanlar bu bölümde Qwen3 ailesinin altı yoğun modeli üzerinde, Türkçe kıyaslama testleriyle (benchmark) sınanmıştır. Ana ölçüt görev doğruluğudur; İngilizce yalnızca karşılaştırma için ölçülmüştür. Cevabı aranan ana sorular şunlardır:
E1'de altı modelin bütün kuantları üretilmiş ve ölçülmüştür. Bundan önce E0'da ölçüm zincirinin güvenilir olup olmadığı sınanmıştır.
Şemada turuncu EN (İngilizce) rozeti İngilizce ölçüm içeren deneyi gösterir; gri kutular serinin diğer yazılarında ele alınan deneylerdir. Serideki bütün koşumlar bir H100'de (80 GB) yapıldı; toplam 10.7 GPU-saat.
Bütün deneyler aynı modelleri, kuantları ve ölçütleri paylaşır.
Tablo 5: Ortak Kurulum; Modeller, Kuantlar, Kalibrasyon ve Ölçütler
Kuantlar: Tablodaki kuantlar üç aileden gelir. GGUF, llama.cpp'nin formatıdır;【24】 adındaki sayı yaklaşık bit sayısını verir (Q8_0 8 bit, Q4_K_M yaklaşık 4 bit). Adında K geçen türler bütün tensörleri aynı bitte tutmaz, kayba en duyarlı tensörlerin bir kısmını daha yüksek bitte bırakır; Q4_K_M'in ölçülen ortalama bitinin 4'ün üstünde çıkması bundandır. imatrix, kalibrasyon verisinden, yani kuantizasyon sırasında modelden geçirilen örnek metinlerden hangi ağırlıkların önemli olduğunu çıkarır ve yuvarlamayı buna göre yönlendirir. GPTQ ağırlıkları sırayla yuvarlar ve her adımda oluşan hatayı henüz yuvarlanmamış ağırlıkları düzelterek telafi eder.【25】 FP8, 8 bitlik kayan noktalı formattır ve burada ağırlıklarla birlikte aktivasyonları da sıkıştırır. W8A8 ve W4A16 gösterimleri ağırlık (W) ve aktivasyon (A) bitlerini belirtir: W4A16'da ağırlıklar 4 bitte saklanır, hesaplama 16 bitte yapılır.
Ölçüm: Ana ölçüt, kuantize modelin doğruluğunun aynı modelin BF16 kopyasına göre farkıdır. Her kuant aynı soruları yanıtladığı için bu fark, sorular eşleştirilerek yeniden örnekleme (bootstrap) yöntemiyle %95 güven aralığı olarak verilir. Cevap değiştirme (flip) oranı, BF16 modelin doğru cevaplarının yanlışa, yanlışlarının doğruya dönme sıklığıdır; ortalama doğruluk aynı kalırken cevapların önemli bir kısmı değişebildiği için doğrulukla birlikte okunur.【26】 KL ıraksaması (KL divergence) her token'da kuantize modelin olasılık dağılımının BF16 modelinkinden ne kadar uzaklaştığını ölçer; doğru cevap gerektirmediği için daha hassastır ve ek ölçüt olarak raporlanır. Bir modelin kırılma noktası, Belebele-tr ve ARC-tr ortalamasında en az 2 puanlık ve güven aralığı sıfırı dışlayan bir kaybın, ölçülen ortalama bit sırasına göre ilk görüldüğü kuanttır.
Türkçe kalibrasyon kümesi, BellaTurca'nın özenle temizlenmiş genel web metinlerinden oluşan OzenliDerlem alt kümesinden rastgele örneklenir.【27】 Kalibrasyon örnek sayısı GPTQ'nun özgün çalışmasındaki 128 örneği izler.【28】 KL ölçümü, kalibrasyondan farklı bir alandan, Havadis haber metinlerinden alınmış yaklaşık 100 bin token'lık bir kümede yapılır.【29】
Belebele'nin Türkçe ve İngilizce kümeleri aynı paragraflar üzerine kurulmuş aynı sorulardır; paragraflar FLORES-200'den alınmıştır.【30】 İki dilin aynı içerikte karşılaştırılmasını bu sağlar. ARC-tr, ARC-Challenge test bölümünün insan kontrolünden geçmiş Türkçe çevirisidir. GPQA-tr'de doğru cevap her satırda aynı sütunda yer aldığı için şıklar sabit bir rastgelelik tohumuyla (seed) karıştırılır. GPQA-tr, BF16 hâlinde bile şans düzeyine yakın kalan 0.6B ve 1.7B modellerde ölçülmez; 4B'de ölçülür, ancak BF16 skoru şans düzeyinde olduğu için o sütun gri gösterilir.
Benchmark'lar log-likelihood tabanlı çoktan seçmeli puanlamayla çalıştırılır; model metin üretmediği için Qwen3'ün düşünme modu sonuçları etkilemez. GPTQ ve FP8 kuantları vLLM'de kendi çekirdekleriyle çalışır.【31】 GGUF kuantlarının ağırlıkları BF16'ya geri açılıp aynı motorda değerlendirilir; böylece bütün kuantlar aynı ölçüm zincirinden geçer. Bu yolun llama.cpp'nin kendisiyle aynı sonucu verdiği E0'da doğrulanır. GGUF kuantlarının KL ıraksaması doğrudan llama.cpp'nin perplexity aracıyla hesaplanır. FP8 ve GPTQ kuantlarının KL'si vLLM'in token olasılıklarından, aynı Havadis kümesinde hesaplanır.
Diğer sonuçlardan önce ölçüm zincirinin kendisi Qwen3-8B üzerinde sınanmıştır. Üç koşul aranmıştır. Birincisi, BF16 model farklı çekirdek ayarlarıyla iki kez çalıştırıldığında flip oranı sıfıra yakın çıkmalıdır; bu oran bütün grafiklerdeki gürültü tabanıdır ve küçükse ölçüm zinciri tekrarlanabilirdir, sonraki grafiklerde bu banttan küçük farklar gürültü sayılır. İkincisi, BF16'ya geri açılmış GGUF ağırlıklarıyla hesaplanan KL ıraksaması llama.cpp'nin kendi ölçümüyle örtüşmelidir; büyük sapma olursa GGUF sonuçları "geri açılmış model" olarak okunmalıdır. Üçüncüsü, doğruluk kaybı ve KL ıraksaması Q8_0 → Q4_K_M → Q3_K_M → Q2_K sırasıyla artmalıdır; sırayı bozan bir sonuç ölçümde ya da kuant üretiminde hata olduğunu gösterir ve sonuçlarla birlikte açıkça yazılır.
Bulgular: Qwen3-8B BF16 modeli varsayılan ve enforce_eager çekirdek ayarlarıyla iki kez ölçüldüğünde Belebele-tr ve ARC-tr ortalaması +0.13 puan değişti (%95 GA [−0.21, +0.47]); flip oranı %0.7. Bu bant (±0.47 puan; GA'nın üst sınırı) sonraki grafiklerde gri şerit olarak çizilir. Yol tutarlılığında dört GGUF kuantında da iki KL yolu birbirine yakın çıktı: Q8_0 için 0.0019 ve 0.0019 (fark %0.5), Q4_K_M için llama.cpp KL'si 0.0370, geri açılmış ağırlıklarla 0.0359 (fark %3), Q3_K_M için 0.1305 ve 0.1287 (fark %1.4), Q2_K için 0.4077 ve 0.4048 (fark %0.7). Kayıp ve KL, Q8_0 → Q4_K_M → Q3_K_M → Q2_K sırasında tek yönde arttı (Δ −0.06, −0.67, −1.48, −7.57 puan; KL değerleri yukarıda). Üç koşul da sağlanmıştır; ön kontrol geçilmiştir.
Tablo 6: Ölçüm Tabanı (E0, Qwen3-8B)
Flip oranı Belebele-tr ve ARC-tr'de birleşik hesaplandı. BF16 ve FP8 GGUF olmadığı için geri açılmış KL sütununda "—" işareti kullanılmıştır; FP8 sıra kontrolünün dışındadır. En büyük KL farkı (%3) Q4_K_M'de; llama.cpp'nin CUDA'da aktivasyonları 8 bite yuvarlamasından gelmiş olabilir, ayrıca sınanmamıştır.
Sonuç E0: Ölçüm zinciri güvenilir: gürültü tabanı ±0.47 puan, iki KL yolu uyumlu, kayıp ve KL doğru sırada. Bundan sonraki farklar bu bantla birlikte okunur.
Araştırma Sorusu: Altı Qwen3 modelinde bit sayısı azaldıkça Türkçe doğruluk nasıl değişir ve bu değişim model boyutuna bağlı mıdır?
Kurulum: Ortak kurulumdaki 6 model × 6 kuant ve BF16 referanslar. Her biri için ortalama bit, disk boyutu, Belebele-tr, ARC-tr ve GPQA-tr doğruluğu, flip oranı ve KL ıraksaması ölçülmüştür. Belebele İngilizce kümesinde de ölçülmüştür; bu, aynı sorularda iki dilin kaybının model boyutuyla birlikte karşılaştırılmasını sağlar.
Beklenti: FP8 ve 8 bitlik kuantların kaybının E0 tabanına yakın kalması, kalitenin 8'den 4 bite kadar yavaş düşmesi, 3 bite doğru inildikçe ise kayıp artışının hızlanması beklenir.【32】 Aynı kuantın küçük modellerde daha fazla kayıp yaratması ve kırılma noktasının model küçüldükçe daha yüksek bite kayması beklenir. Diller kuantizasyondan eşit etkilenmez;【33】 Belebele'de Türkçe kaybın İngilizceden büyük olması beklenir.
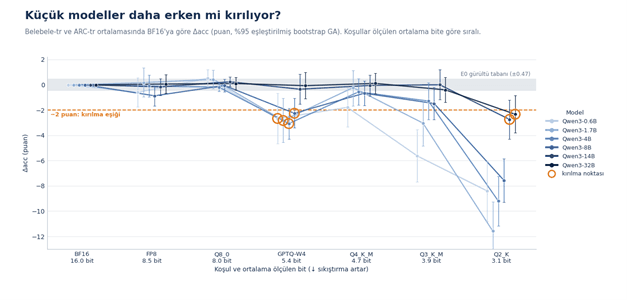
Model Başarısı, Koşul ve Ortalama Ölçülen Bit (Çizim: Elif İnce)
Bulgular: Altı modelin her birinde BF16 referans ile altı kuant karşılaştırılmıştır; ölçü, Belebele-tr ve ARC-tr ortalamasının BF16'ya göre farkıdır. 8 bitte kayıp gürültü düzeyindedir: Q8_0 altı modelde −0.18 ile +0.51 puan arasında kalır ve hiçbir GA'sı sıfırı dışlamaz; FP8 −0.87 ile +0.17 arasındadır ve GA'sı sıfırı dışlayan tek 8 bit hücresi Qwen3-8B FP8'dir (−0.87 puan, GA [−1.66; −0.11]).
Model başarılarının karşılaştırıldığı sonuç görselindeki kırılma noktası, Ortak Kurulum bölümündeki Ölçüm tanımına göre belirlenmiştir.
4 bit ve altında sonuçlar yönteme göre ayrışmıştır. GGUF Q4_K_M, 1.7B–32B arasındaki modellerde −0.67 ile +0.11 puan aralığında kalmıştır; yalnızca 0.6B'de −1.79 puanla (GA [−3.33; −0.24]) sıfırı dışlamış, ancak −2 puanlık kırılma eşiğine ulaşmamıştır. Q3_K_M, 14B'de kayıpsız (0.00) kalmış, 32B'de −0.40, 4B ve 8B'de sırasıyla −1.29 ve −1.48 puan vermiştir; ancak 1.7B'de −3.03 ve 0.6B'de −5.63 puana inmiştir. Q2_K her modelde kırılma eşiğini geçmiştir: 32B'de −2.33, 14B'de −2.74, 8B'de −7.57, 0.6B'de −8.40, 4B'de −9.21 ve 1.7B'de −11.58 puan.
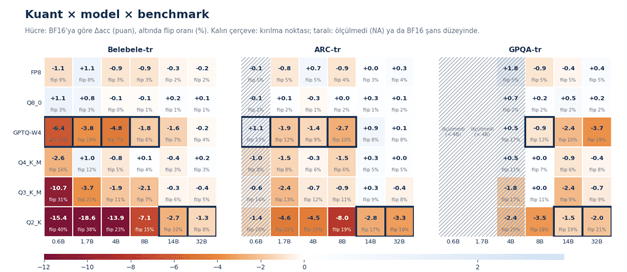
Kuant × Model × Benchmark Isı Haritası (Çizim: Elif İnce)
Kırılma noktası: Ölçülen ortalama bit sırasına göre (asıl ölçüt) 0.6B, 1.7B, 4B ve 8B'de ilk kırılan koşul GPTQ-W4'tür (sırasıyla −2.67, −2.83, −3.07 ve −2.25 puan; GA'ların hepsi sıfırı dışlıyor). 14B ve 32B'de GPTQ-W4 kırılmıyor (−0.35 ve −0.07) ve ilk kırılma Q2_K'dadır; nominal bit sırası da aynı sonucu veriyor. Kırılma noktası bu anlamda model büyüdükçe daha düşük bite kaymıştır; ancak bit sayısı tek açıklayıcı değildir: GPTQ-W4'ün ölçülen ortalama biti 5.3–5.9, Q4_K_M'inki 4.2–4.95 olduğu hâlde, 8B ve altı modellerde GPTQ-W4, Q4_K_M'den 0.9 ile 2.6 puan fazla kayıp vermiştir.
Boyut etkisi: Aynı kuantta kayıp model büyüdükçe azalmıştır: boyut ile Δ arasındaki Spearman korelasyonu GPTQ-W4'te +0.77, Q4_K_M'de +0.77, Q3_K_M'de +0.89 ve Q2_K'de +0.83 olmuştur (pozitif: büyük model daha az kaybetmiştir). Ancak azalma düzenli değildir: Q2_K'de 1.7B (−11.58) 0.6B'den (−8.40), GPTQ-W4'te 4B (−3.07) 0.6B'den (−2.67) daha çok kayıp vermiştir. 8 bit kuantlarda boyutla bir ilişki gözlenmemiştir.
Flip oranı ve KL. Doğruluk aynı kalırken cevaplar değişiyor: 36 hücrenin 15'inde |Δ| gürültü bandının (0.47 puan) altında olduğu hâlde flip oranı gürültü tabanının (%0.7) üstünde. Örneğin 14B Q3_K_M'de Δ = 0.00 iken flip %7.9, 1.7B Q4_K_M'de Δ = −0.23 iken flip %9.7. Flip oranı Q8_0'da %0.7–2.7, Q4_K_M'de %3.8–11.5, Q2_K'de %12.5–28.8 arasında. KL ıraksaması aynı sıralamayı izliyor ve model büyüdükçe düşüyor: Q4_K_M için 0.6B'de 0.122, 8B'de 0.037, 32B'de 0.024; Q2_K için 1.32, 0.41 ve 0.31. KL ıraksaması FP8'de 0.0016–0.0072 (Q8_0'ın biraz üstünde), GPTQ-W4'te 0.031–0.162. GPTQ-W4, ortalama biti daha yüksek olduğu hâlde aynı modelde Q4_K_M'den 1.3–1.6 kat daha yüksek KL veriyor; bu durum doğruluktaki farkla tutarlıdır.
Belebele-en yalnızca bu altı modelde ölçüldü; GA, aynı satırlar iki dilde birlikte yeniden örneklenerek hesaplandı.
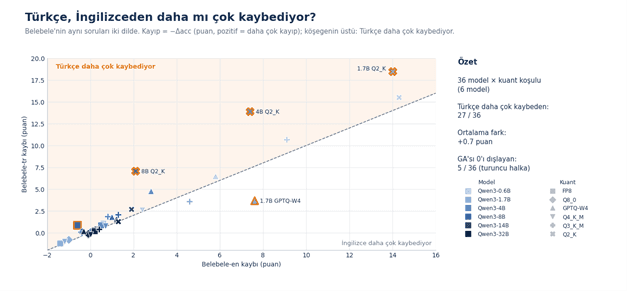
Belebele Veri Setinde Kuantizasyonun Türkçe ve İngilizce Üzerindeki Etkisi (Çizim: Elif İnce)
İki dil: Belebele'nin aynı sorularının iki dilde ölçüldüğü altı modelde 36 model × kuant koşulunun 27'sinde Türkçe İngilizceden daha çok kaybediyor; ortalama fark +0.7 puan. Farkın GA'sı yalnızca beş koşulda sıfırı dışlıyor: 4B Q2_K (+6.56 puan), 8B Q2_K (+5.00), 1.7B Q2_K (+4.5, GA [+2.3; +6.7]), 8B FP8 (+1.44; burada İngilizce doğruluk BF16'nın biraz üstüne çıkmıştır) ve ters yönde 1.7B GPTQ-W4 (−3.9, GA [−6.2; −1.6]; İngilizce daha çok kaybediyor). 0.6B'de fark küçük (+0.2 ile +1.6 puan; Türkçe doğruluk şansa yakın olduğundan taban etkisiyle ilişkili olabilir). 14B'de fark −0.1 ile +0.8, 32B'de −0.2 ile +0.5 puan arasında. Türkçenin ek kaybı en düşük bitli kuantta (Q2_K) ve küçük-orta modellerde (1.7B–8B) belirgin olmuştur; 14B ve üstünde belirgin değildir.
GPQA-tr: 546 soruluk GPQA-tr'de güven aralıkları 4–7 puan genişliğinde (örneğin 32B GPTQ-W4 −3.66, GA [−7.33; 0.00]) ve farklar küçüktür. Qwen3-4B BF16 %27.1 ile şans düzeyine yakın olduğundan o sütun gri gösteriliyor; 0.6B ve 1.7B'de GPQA-tr ölçülmedi.
Tablo 7: Qwen3-8B ve Qwen3-32B Sonuçları
Altı modelin tamamı ek bölümündedir.
Doğruluklar % (Bel: Belebele). Kalın Δ: %95 GA sıfırı dışlıyor. Bit: ölçülen ortalama bit. KL: Havadis'te; GGUF'ta llama.cpp, FP8 ve GPTQ-W4'te vLLM logprob'larıyla.
Sonuç E1: 8 bitte kayıp gürültü düzeyine yakın bulunmuştur (GA'sı sıfırı dışlayan tek 8 bit koşulu Qwen3-8B FP8'dir, −0.87 puan). Kırılma noktası 8B ve altı modellerde GPTQ-W4'te (yaklaşık 5.3–5.9 bit), 14B ve 32B'de Q2_K'de (yaklaşık 3 bit) görülmüştür. Türkçenin İngilizceden ek kaybı yalnızca beş koşulda belirgindir (ayrıntı: İki dil).
Tablo 8: Deneylerin Özeti
Bit sınırı: Eğitim sonrası kuantizasyon, modelin eğitim sırasında karşılaşmadığı bir yuvarlama gürültüsünü sonradan ekler. Bu çalışmada gürültü 8 bitte ölçüm hatası düzeyinde kalmış, 4 bitte yönteme göre değişmiş, yaklaşık 3 bitte ise altı modelin hepsinde kırılma eşiğini aşmıştır. Literatürdeki bulgular da aynı yöndedir: GPTQ, 4 bitte kaybın küçük kaldığını, 3 bitte ise özellikle küçük modellerde arttığını göstermiştir;【34】 3–8 bit aralığını inceleyen geniş ölçekli bir çalışma ise toplam model bit sayısı ve sıfır-atış doğruluğu bakımından 4 biti çoğu durumda en uygun nokta olarak bulmuştur.【35】 Kalibrasyon ve karma hassasiyet bu kaybı yalnızca belirli bir noktaya kadar azaltabilir; ağırlıklar kuantizasyon gözetilmeden öğrenildiği sürece bu sınırın yöntemlerle ötelenebileceği, ancak kaldırılamayacağı beklenir.
Kapsam: Bulgular yalnızca Qwen3 ailesinin altı yoğun modeli, Türkçe (İngilizce yalnızca Belebele'de), çoktan seçmeli benchmark'lar ve kullanılan yazılım sürümleri için geçerlidir. AWQ, NF4 ve EXL3 gibi diğer biçimler, MoE modeller ve 2 bitin altındaki kuantlar kapsam dışında bırakılmıştır; bu durumlarda aynı sıralamanın elde edileceği varsayılmamalıdır.
Ölçüm sınırlılıkları: Açık uçlu metin üretiminin kalitesi ve insan değerlendirmesi ölçülmemiştir. Çoktan seçmeli puanlama Türkçe ekler ve uyum gibi biçimsel hataları yakalamaz; ayrıca otomatik ölçütler kuantizasyonun kullanıcı üzerindeki etkisini insan değerlendirmesine kıyasla olduğundan küçük gösterebilir.【36】 ARC-tr ve GPQA-tr çeviri veri kümeleridir; çeviri hataları modelden bağımsız bir gürültü ekler.
Her zaman aynı cevapları vermez. Ortalama doğruluk aynı kalırken bazı doğru cevaplar yanlışa, bazı yanlışlar doğruya dönebilir.【37】 E1'deki 36 koşulun 15'inde doğruluk farkı gürültü bandının içinde kaldığı hâlde flip oranı gürültü tabanının üstündeydi; örneğin 14B Q3_K_M'de doğruluk hiç değişmezken cevapların %7.9'u değişti. Bu yüzden doğruluğa flip oranı ve KL ıraksamasıyla birlikte bakmak gerekir.
FP8'in kayan noktalı yapısı geniş bir aralığı korur; ayrıca Ada Lovelace ve Hopper mimarilerinde ve sonraki GPU'larda FP8 donanım desteği vardır (Ampere ve öncesinde yoktur); geçmiş değerlendirmeler FP8 W8A8'in büyük modellerde kaliteyi neredeyse tamamen koruduğunu gösterdi.【38】 E1'de de altı modelin hiçbirinde FP8'in Türkçe kaybı 0.87 puanı geçmedi (GA yalnızca 8B'de sıfırı dışlıyor).
Giriş örneği: Girişteki iki cevaptan biri ağırlıkları yaklaşık üçte birine sıkıştırılmış bir modelden geliyordu; bu tek örnekte iki cevap içerik bakımından benzerdi. Bu yazıda anlatılan mekanizmalar o örnekte de işlemiştir: ağırlıklar bir ızgaraya yuvarlanmış, outlier'ların etkisi kendi grubuyla sınırlanmış, hassas tensörler daha fazla bitle korunmuştur.
Farklı Kuantizasyonlar: 8 bitlik kuantlar BF16'ya göre gürültü düzeyine yakın kayıp vermiştir; GA'sı sıfırı dışlayan tek koşul Qwen3-8B FP8'dir (−0.87 puan). 4 bitte sonuç yönteme bağlıdır. GGUF Q4_K_M altı modelde de kırılma eşiğinin altında kalmıştır (en büyük kayıp 0.6B'de, −1.79 puan); GPTQ-W4 ise 8B ve altı modellerde ilk kırılma noktasıdır. Yaklaşık 3 bitte (Q2_K) altı modelin hepsi kırılma eşiğini geçmiştir (en küçük kayıp 32B'de, −2.33 puan); 14B ve 32B'de ilk kırılma bu kuanttadır. Kayıp model büyüdükçe azalmıştır, ancak bu azalma düzenli değildir.
Dil farkı: Belebele'de Türkçe kaybı İngilizceden ortalama 0.7 puan fazladır; fark yalnızca beş koşulda belirgindir ve 14B ile 32B'de belirgin değildir.
Ölçüm güvenilirliği: Sonuçlar E0'da sınanan ölçüm zinciriyle (gürültü bandı ±0.47 puan, iki KL yolu uyumlu, kayıp ve KL beklenen sırada) elde edilmiştir; altı modelin bütün sonuçları Ek bölümündedir.
Sınırlar: Bulgular Qwen3 ailesindeki altı yoğun model, Türkçe çoktan seçmeli benchmark'lar ve belirli yazılım sürümleriyle sınırlıdır; AWQ, NF4, EXL3, MoE modeller ve 2 bitin altındaki kuantlar kapsam dışıdır.
Serinin ikinci yazısında bu kuantların nasıl üretildiğine ve aralarından nasıl seçim yapılacağına odaklanılacaktır: kalibrasyon kullanan yöntemlerin nasıl çalıştığı, kalibrasyon verisinin dilinin Türkçede neyi değiştirdiği ve 8, 16 ve 24 GB'lık bellek bütçelerinde hangi model ve kuant birleşiminin öne çıktığı incelenecektir; kuantizasyonun hızı ne kadar artırdığı ise ölçülecektir.
Altı Qwen3 modelinin BF16 referansı ve altı kuantı aşağıda listelenmiştir.
Tablo 9: Altı Qwen3 Modelinin BF16 Referansı ve Altı Kuantı (Tüm Sonuçlar)
Doğruluklar % (Bel: Belebele). Kalın Δ: %95 GA sıfırı dışlıyor; gri hücre: ölçülmedi (GPQA-tr 0.6B ve 1.7B) ya da BF16 skoru şans düzeyinde (GPQA-tr 4B). Bit: ölçülen ortalama bit. KL: Havadis'te; GGUF'ta llama.cpp, FP8 ve GPTQ-W4'te vLLM logprob'larıyla elde edilmiştir.
Bandarkar, L., D. Liang, B. Muller, vd. “The Belebele Benchmark: a Parallel Reading Comprehension Dataset in 122 Language Variants.” arXiv 2024. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2308.16884
Clark, P., I. Cowhey, O. Etzioni vd. “Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge.” arXiv 2018. Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/1803.05457
DeepSeek-AI, A. Liu, B. Feng, vd. “DeepSeek-V3 Technical Report.” arXiv 2024. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2412.19437
DeepSeek-AI. “DeepSeek-V4 Pro.” Hugging Face. Erişim tarihi: 1 Ekim 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro
Dettmers, T. ve L. Zettlemoyer. “The Case for 4-bit Precision: k-bit Inference Scaling Laws.” arXiv 2022. Erişim tarihi: 4 Ekim 2026. https://arxiv.org/abs/2212.09720
Dettmers, T., A. Pagnoni, A. Holtzman, ve L. Zettlemoyer. “QLoRA: Efficient Finetuning of Quantized LLMs.” arXiv 2023. Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/2305.14314
Dettmers, T., M. Lewis, Y. Belkada ve L. Zettlemoyer. “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale.” arXiv 2022. Erişim tarihi: 30 Eylül 2026. https://arxiv.org/abs/2208.07339
Dutta, A., S. Krishnan, N. Kwatra ve R. Ramjee. “Accuracy is Not All You Need.” arXiv 2024. Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2407.09141
EleutherAI. “Language Model Evaluation Harness.” GitHub. Erişim tarihi: 13 Ekim 2026. https://github.com/EleutherAI/lm-evaluation-harness
Frantar, E., S. Ashkboos, T. Hoefler ve D. Alistarh. “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers.” arXiv 2023. Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2210.17323
Jacob, B., S. Kligys, B. Chen vd. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference.” arXiv 2017. Erişim tarihi: 10 Ekim 2026. https://arxiv.org/abs/1712.05877
Kurtic, E., A. Marques, S. Pandit, vd. “‘Give Me BF16 or Give Me Death’? Accuracy-Performance Trade-Offs in LLM Quantization.” arXiv 2025. Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2411.02355
Kwon, W., Z. Li, S. Zhuang, vd. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” arXiv 2023. Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2309.06180
Marchisio, K., S. Dash, H. Chen, vd. “How Does Quantization Affect Multilingual LLMs?” arXiv 2024. Erişim tarihi: 12 Ekim 2026. https://arxiv.org/abs/2407.03211
Micikevicius, P., D. Stosic, N. Burgess, vd. “FP8 Formats for Deep Learning.” arXiv 2022. Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2209.05433
Moonshot AI. “Kimi K3.” GitHub 2026. Erişim tarihi: 12 Ekim 2026. https://github.com/MoonshotAI/Kimi-K3
Nagel, M., M. Fournarakis, R. A. Amjad, vd. “A White Paper on Neural Network Quantization." arXiv 2021. Erişim tarihi: 30 Eylül 2026. https://arxiv.org/abs/2106.08295
Open Language Data Initiative. “FLORES+.” Hugging Face. Erişim tarihi: 3 Ekim 2026. https://huggingface.co/datasets/openlanguagedata/flores_plus
Rein, D., B. L. Hou, A. C. Stickland, vd. “GPQA: A Graduate-Level Google-Proof Q&A Benchmark.” arXiv 2023. Erişim tarihi: 2 Ekim 2026. https://arxiv.org/abs/2311.12022
Rouhani, B. D., R. Zhao, A. More, vd. “Microscaling Data Formats for Deep Learning.” arXiv 2023. Erişim tarihi: 15 Ekim 2026. https://arxiv.org/abs/2310.10537
Turkish NLP Suite. “BellaTurca.” Hugging Face. Erişim tarihi: 5 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/BellaTurca
Turkish NLP Suite. “Havadis.” Hugging Face. Erişim tarihi: 1 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/Havadis
Xiaomi MiMo Team. “MiMo-V2.6-Pro-RL.” Hugging Face. Erişim tarihi: 5 Ekim 2026. https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL
Yang, A., A. Li, B, Yang, vd. “Qwen3 Technical Report.” arXiv 2025. Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2505.09388
Yıldız Teknik Üniversitesi Bilgisayar Mühendisliği Bölümü COSMOS Araştırma Grubu. “gpqa-extended_tr.” Hugging Face. Erişim tarihi: 13 Ekim 2026. https://huggingface.co/datasets/ytu-ce-cosmos/gpqa-extended_tr
Z.ai. “GLM-5.3.” Hugging Face. Erişim tarihi: 15 Ekim 2026. https://huggingface.co/zai-org/GLM-5.3
ggml-org. “llama.cpp.” GitHub. Erişim tarihi: 6 Ekim 2026. https://github.com/ggml-org/llama.cpp
malhajar. “arc-tr-v0.2.” Hugging Face. Erişim tarihi: 8 Ekim 2026. https://huggingface.co/datasets/malhajar/arc-tr-v0.2
vLLM Project. “LLM Compressor.” GitHub. Erişim tarihi: 3 Ekim 2026. https://github.com/vllm-project/llm-compressor
[1]
Moonshot AI. “Kimi K3.” GitHub. Erişim tarihi: 12 Ekim 2026. https://github.com/MoonshotAI/Kimi-K3
[2]
DeepSeek-AI, A. Liu, B. Feng, vd., “DeepSeek-V3 Technical Report,” arXiv 2024, 2-3, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2412.19437
[3]
Moonshot AI, “Kimi K3,” GitHub 2026, Erişim tarihi: 12 Ekim 2026. https://github.com/MoonshotAI/Kimi-K3
[4]
DeepSeek-AI, “DeepSeek-V4 Pro,” Hugging Face, Erişim tarihi: 1 Ekim 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro
[5]
Xiaomi MiMo Team, “MiMo-V2.6-Pro-RL,” Hugging Face, Erişim tarihi: 5 Ekim 2026. https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL
[6]
Z.ai, “GLM-5.3,” Hugging Face, Erişim tarihi: 15 Ekim 2026. https://huggingface.co/zai-org/GLM-5.3
[7]
A. Yang, A. Li, B, Yang, vd., “Qwen3 Technical Report,” arXiv 2025, 1, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2505.09388
[8]
A. Yang, A. Li, B, Yang, vd., “Qwen3 Technical Report,” 7.
[9]
P. Micikevicius, D. Stosic, N. Burgess, vd, “FP8 Formats for Deep Learning,” arXiv 2022, 4, Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2209.05433
[10]
T. Dettmers, A. Pagnoni, A. Holtzman, ve L. Zettlemoyer, “QLoRA: Efficient Finetuning of Quantized LLMs,” arXiv 2023, 7-9, Erişim tarihi: 6 Ekim 2026. https://arxiv.org/abs/2305.14314
[11]
B. D. Rouhani, R. Zhao, A. More, vd., “Microscaling Data Formats for Deep Learning,” arXiv 2023, 4-5, Erişim tarihi: 15 Ekim 2026. https://arxiv.org/abs/2310.10537
[12]
T. Dettmers, M. Lewis, Y. Belkada ve L. Zettlemoyer. “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale.” arXiv 2022. 2, Erişim tarihi: 30 Eylül 2026. https://arxiv.org/abs/2208.07339
[13]
B. D. Rouhani, R. Zhao, A. More, vd., “Microscaling Data Formats for Deep Learning,” 10.
[14]
B. Jacob, S. Kligys, B. Chen vd., “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference,” arXiv 2017, 8, Erişim tarihi: 10 Ekim 2026. https://arxiv.org/abs/1712.05877; M. Nagel, M. Fournarakis, R. A. Amjad, vd. “A White Paper on Neural Network Quantization," arXiv 2021, 5, 7-8, Erişim tarihi: 30 Eylül 2026. https://arxiv.org/abs/2106.08295
[15]
Yang, A., A. Li, B, Yang, vd., “Qwen3 Technical Report,” 15.
[16]
vLLM Project, “LLM Compressor,” GitHub, Erişim tarihi: 3 Ekim 2026. https://github.com/vllm-project/llm-compressor
[17]
ggml-org, “llama.cpp,” GitHub, Erişim tarihi: 6 Ekim 2026. https://github.com/ggml-org/llama.cpp
[18]
Turkish NLP Suite, “BellaTurca,” Hugging Face, Erişim tarihi: 5 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/BellaTurca
[19]
L. Bandarkar, D. Liang, B. Muller, vd., “The Belebele Benchmark: a Parallel Reading Comprehension Dataset in 122 Language Variants,” arXiv 2024, 3-4, 7-8, Erişim tarihi: 14 Ekim 2026. https://arxiv.org/abs/2308.16884
[20]
malhajar “arc-tr-v0.2,” Hugging Face, Erişim tarihi: 8 Ekim 2026. https://huggingface.co/datasets/malhajar/arc-tr-v0.2; P. Clark, I. Cowhey, O. Etzioni vd., “Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge,” arXiv 2018, Erişim tarihi: 9 Ekim 2026. https://arxiv.org/abs/1803.05457
[21]
Yıldız Teknik Üniversitesi Bilgisayar Mühendisliği Bölümü COSMOS Araştırma Grubu, “gpqa-extended_tr,” Hugging Face, Erişim tarihi: 13 Ekim 2026. https://huggingface.co/datasets/ytu-ce-cosmos/gpqa-extended_tr; D. Rein, B. L. Hou, A. C. Stickland, vd., “GPQA: A Graduate-Level Google-Proof Q&A Benchmark,” arXiv 2023, 1, Erişim tarihi: 2 Ekim 2026. https://arxiv.org/abs/2311.12022
[22]
EleutherAI, “Language Model Evaluation Harness,” GitHub, Erişim tarihi: 13 Ekim 2026. https://github.com/EleutherAI/lm-evaluation-harness
[23]
Turkish NLP Suite, “Havadis,” Hugging Face, Erişim tarihi: 1 Ekim 2026. https://huggingface.co/datasets/turkish-nlp-suite/Havadis
[24]
ggml-org. “llama.cpp."
[25]
E. Frantar, S. Ashkboos, T. Hoefler ve D. Alistarh, “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” arXiv 2023, 5-6, Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2210.17323
[26]
A. Dutta, S. Krishnan, N. Kwatra ve R. Ramjee, “Accuracy is Not All You Need,” arXiv 2024, 3, 6, 8-9, Erişim tarihi: 11 Ekim 2026. https://arxiv.org/abs/2407.09141
[27]
Turkish NLP Suite, “BellaTurca.”
[28]
E. Frantar, S. Ashkboos, T. Hoefler ve D. Alistarh, “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” 6.
[29]
Turkish NLP Suite, “Havadis.”
[30]
Open Language Data Initiative, “FLORES+,” Hugging Face, Erişim tarihi: 3 Ekim 2026. https://huggingface.co/datasets/openlanguagedata/flores_plus
[31]
W. Kwon, Z. Li, S. Zhuang, vd., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” arXiv 2023, 1-2, Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2309.06180
[32]
E. Frantar, S. Ashkboos, T. Hoefler ve D. Alistarh, “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” 3; T. Dettmers ve L. Zettlemoyer, “The Case for 4-bit Precision: k-bit Inference Scaling Laws,” arXiv 2022, 3-4, Erişim tarihi: 4 Ekim 2026. https://arxiv.org/abs/2212.09720
[33]
K. Marchisio, S. Dash, H. Chen, vd., “How Does Quantization Affect Multilingual LLMs?” arXiv 2024, 1, 6, Erişim tarihi: 12 Ekim 2026. https://arxiv.org/abs/2407.03211
[34]
E. Frantar, S. Ashkboos, T. Hoefler ve D. Alistarh, “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” 9.
[35]
T. Dettmers ve L. Zettlemoyer, “The Case for 4-bit Precision: k-bit Inference Scaling Laws,” 9-10.
[36]
K. Marchisio, S. Dash, H. Chen, vd., “How Does Quantization Affect Multilingual LLMs?” 8.
[37]
A. Dutta, S. Krishnan, N. Kwatra ve R. Ramjee, “Accuracy is Not All You Need,” 3.
[38]
E. Kurtic, A. Marques, S. Pandit, vd., “‘Give Me BF16 or Give Me Death’? Accuracy-Performance Trade-Offs in LLM Quantization,” arXiv 2025, 1-2, 5, Erişim tarihi: 8 Ekim 2026. https://arxiv.org/abs/2411.02355

Kuantizasyon Nedir?
Dev Bir Model Belleğe Neden Sığmaz?
Bellek Nereye Gider?
Kuantizasyon Modeli Neden Hızlandırır?
Derine İn: KV Cache ve Bant Genişliği Formülleri
Kuantizasyon Bir Ağırlığa Ne Yapar?
Bir Ağırlık Izgaraya Nasıl Yerleşir?
Bir Outlier Bütün Satırı Nasıl Bozar?
Ölçek Küçük Gruplara Bölününce Outlier Etkisi Nasıl Sınırlanır?
Derine İn: Simetrik ve Asimetrik Eşleme
Deneyler
Ortak Kurulum
Derine İn: Kurulum Ayrıntıları
Ön Kontrol: Ölçüm Aracı Güvenilir mi?
Model Büyüdükçe Kuantizasyona Dayanıklılık Artar mı?
Sonuçlar Nasıl Okunur?
Tartışma ve Sınırlılıklar
Sık Sorulan Sorular
Doğruluk Değişmiyorsa Kuantize Model BF16 İle Aynı Cevapları Mı Veriyor?
FP8 Neden Çoğu Zaman Güvenli Kabul Ediliyor?
Sonuç
Ek: Tüm Sonuçlar